GLM-5.3累计涨83%,还值得用吗?省钱三式,掏钱前先看

源自42位全网作者

15:14

GLM-5.3累计涨83%,还值得用吗?省钱三式,掏钱前先看

涨是真涨,省也是真能省。会分流量的人,账单基本能压回涨价前的水平;不看价格页直接充的,活该当冤大头。

这次涨价有多隐蔽

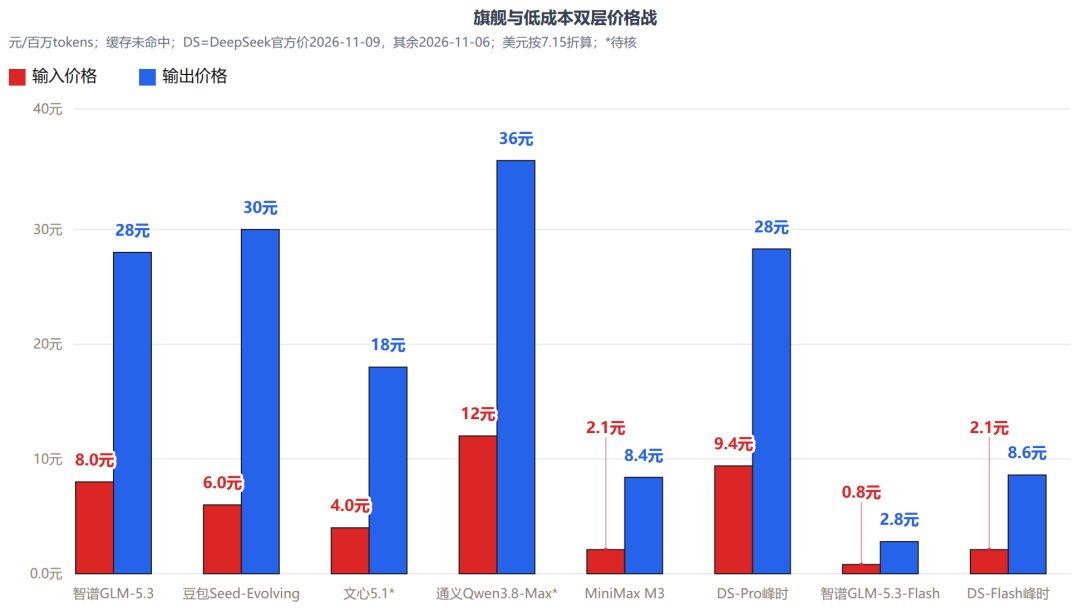
11月12日核实的现价:GLM-5.3每百万tokens输入8元、缓存命中2元、输出28元。8月发布时是输入6元、输出20元。最骚的是官方价格页没有历史对比栏,你想查"涨了多少"都查不到,只能靠第三方追踪站对着旧调研记录算——累计约30%到83%,不同口径。知乎

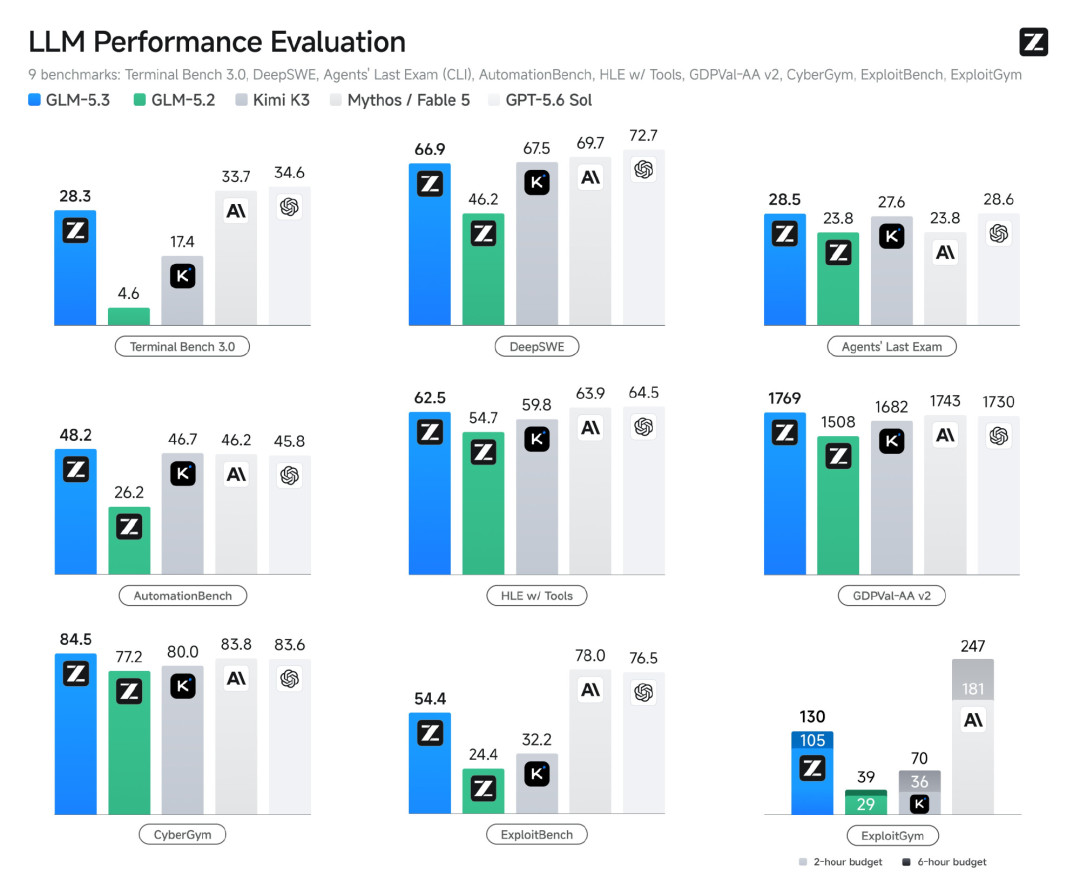
把时间线拉长更刺激:2月Coding Plan套餐+30%,3月旗舰API+20%,4月GLM系列API再+10%,最高档套餐从469元干到1078元。用户端骂声也不少,微博上有人套餐到期直接弃订,说"没有续订的意义了";小红书用户更直接:最低档套餐和GPT一个价,token用量还不如。但骂声没劝退码农:GLM-5.3在Terminal Bench 3.0上拿了28.3分,上一代5.2只有4.6分,6倍的差距比嘴硬实在(官方口径)。小红书微博
GLM-5.3累计涨83%,还值得用吗?省钱三式,掏钱前先看

但诡异的是,越贵用的人越多

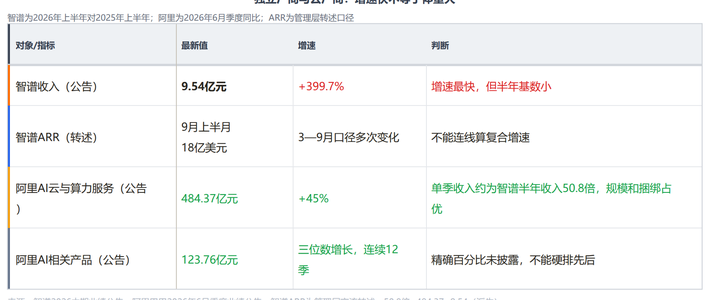
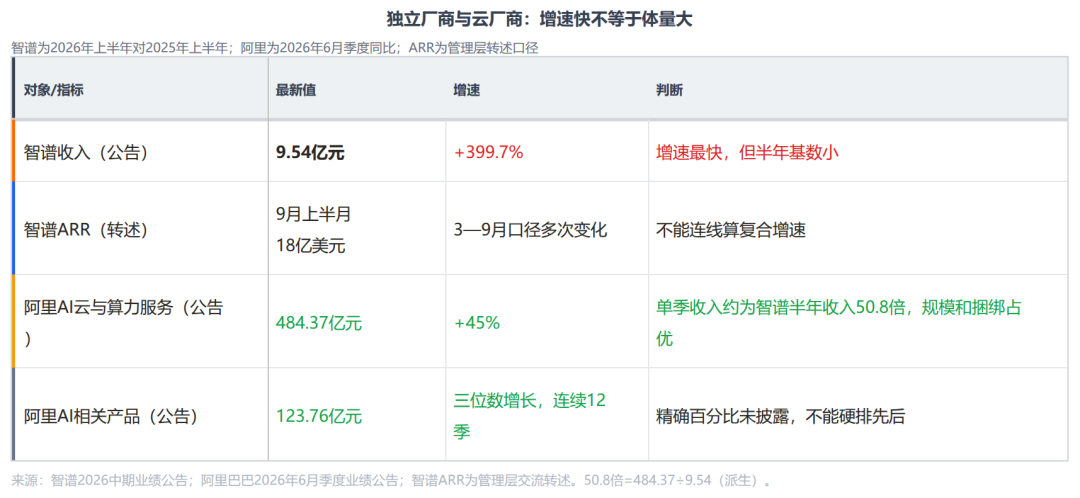
涨价后智谱API调用量反而涨了400%。开源的是权重,收费的是服务——发动机图纸给你,机房电费显卡钱一分省不掉。翻中报更懂它为啥敢涨:上半年收入9.5亿元,同比涨了近4倍。但研发花掉收入的2.2倍,净亏20.7亿元,API毛利率才刚转正到24.6%,收入八成六靠开放平台按量计费。这不是贪婪,是把补贴价拉回成本价。行业也在集体转身:DeepSeek搞峰谷,阿里上Token订阅,白嫖时代落幕。小红书知乎知乎
GLM-5.3累计涨83%,还值得用吗?省钱三式,掏钱前先看

省钱三式,这才是重点

第一式:能用免费的别碰付费。 官方免费模型glm-4.7-flash,输入、输出、缓存命中全免费,200K上下文、128K输出,价目表上明码标着的"0元"。第一次接入拿它跑通调用最稳。知乎

第二式:该降级的果断降级。 GLM-5.3-Flash输入0.8元,旗舰的十分之一。客服、摘要、分类这类任务根本用不到旗舰,编程和长上下文才值得留GLM-5.3。知乎
GLM-5.3累计涨83%,还值得用吗?省钱三式,掏钱前先看

第三式:把缓存命中率抠出来。 同一个系统提示词,命中缓存按2元收,没命中按8元——长会话场景优化这一项,输入成本直接省75%。批量任务再叠一层错峰:闲时段跑,账单还能砍。

两个坑,比涨价更容易亏钱

买了套餐还在扣余额? 10月16日起标准API Key和Coding Plan套餐Key分开管理、互不通用。你在编程工具里塞的是标准Key,那烧的就是账户余额,不消耗套餐额度。知乎

请求中断照样计费。 Token和汉字换算约1:1.6,没收到完整响应不等于没花钱,账单里都躺着呢。

涨价这事,骂归骂,钱是自己管的。搞清价目表再动手,GLM还是那个能打的GLM。
内容由AI生成

精选参考来源

1. 如何看待智谱 GLM-5.3 API 涨价 83%?

2. 第一次用智谱开放平台:先注册并创建模型标准 API Key,用官方免费的 glm-4.7-flash 跑通一次调用,再对照官方人民币价目、充值与退款规则决定要不要充值

3. 国产AI涨价潮:这波你看懂了吗

4. 智谱:把「卖项目」换成「卖调用」,再用一万亿港元学会估值定价

5. 《智谱》2026中报阅读分析-9个月融资755亿,半年收入9.5亿元,市值能给多少?

6. 智谱 AI(Z.ai)今天发布了 GLM-5.3,和 GLM-5.2 共用同一个基座模型,所有提升都来自后训练阶段的强化学习(RL)。【1】编程:开源阵营里最强,但离闭源前沿还有距离GLM-5.3 在多个编程基准上拿到了开源模型(开放权重模型)的最高分。比如 Terminal Bench 3.0,GLM-5.2 只有 4.6 分,5.3 跳到了 28.3。DeepSWE v1.1 从 46.2 涨到 66.9,Agents' Last Exam 从 23.8 到 28.5。在智谱自建的 Z.ai Code Bench 上,GLM-5.3 在 Max 级别用大约 7.5 万 Token 就达到了 34.5% 的完成率,而 GLM-5.2 用了 9.6 万 Token 才拿到 23.4%,能力和效率同时提升。不过对照闭源模型,差距仍然存在。在 Z.ai Code Bench 上 Fable 5 达到 39.5%,ExploitBench 上 Fable 5 拿了 78.0 而 GLM-5.3 是 54.4。整体格局是:开源第一,全局第二梯队。【2】网络安全能力"涌现":他们自己也没完全预料到智谱说,他们在后训练中加入了漏洞发现相关的数据和环境,本来预期模型会在识别漏洞方面有所提升。结果超出了预期:模型不只是在找漏洞,还开始自主规划完整的漏洞利用链条。数字上看,CyberGym(白盒源码审计)GLM-5.3 拿了 84.5%,全场最高,超过 GPT-5.6 Sol 的 83.6% 和 Fable 5 的 83.8%。ExploitBench(要求对真实漏洞进行更深层的利用推理)从 GLM-5.2 的 24.4% 跳到 54.4%,翻了一倍多。ExploitGym(限时完成漏洞利用任务数量)从 29/39 涨到 105/130。规律很明显:越靠近利用链的后端,进步越大。智谱用了"涌现"(emergent)这个词,意思是这个能力不是他们专门去训练的,而是在扩大 RL 规模的过程中自然冒出来的。这个说法如果属实,对 AI 安全领域是个需要关注的信号。【3】在 269 个开源项目中发现 2,436 个真实漏洞跑分只是一面。更引人注意的是,智谱说从 GLM-5.2 开始就和国内安全团队合作,用模型扫描真实代码库。经专家审核和去重后,模型在 269 个开源项目中发现了 2,436 个漏洞,其中 1,097 个是中高危级别。涉及的项目覆盖了操作系统内核、浏览器引擎、网络协议等核心基础设施,有些漏洞在代码里藏了几十年,最老的一个可以追溯到约 40 年前。目前 53 个漏洞已公开披露,2,383 个仍在保密期。智谱还上线了一个公开的漏洞披露追踪页面(Z.ai Security Disclosure Ledger),持续更新进度。这和今年 4 月 Anthropic 公布 Claude Mythos 发现大量零日漏洞的路径很像,但有一个关键区别:Mythos 被美国政府严格限制了使用范围,只对少数审核过的安全机构开放。而 GLM-5.3 的权重将在两周后公开发布。一个能力接近的漏洞发现引擎,即将以开源形式进入公共领域。【4】技术栈:用 slime 框架不换底座只加训练所有这些提升背后的技术逻辑:不换基座模型,靠扩大后训练规模。具体来说,智谱在 GLM-5.2 时期搭建了三个核心组件:IndexShare(长上下文处理)、SAO(长周期任务的 RL 算法)、以及开源的 slime 框架(大规模异步训练基础设施)。GLM-5.3 的做法就是在这套栈上继续堆:更多环境、更多样的任务、更多训练计算。训练环境的设计也在变。新的环境不再像编程练习题,而是模拟资深工程师的真实工作场景,有些任务相当于一个有经验的工程师需要干好几天的活,比如在一个完整的 ML 基础设施环境里诊断训练瓶颈、实现优化、跑实验、交付可验证的端到端加速。为了规模化生产这些训练环境,智谱还搭建了自动合成环境的流水线:研究智能体从真实工作中提取任务模式,生成可执行的长周期环境,评判智能体再验证任务是否可解。这套流水线仍然需要人工参与,但让环境的生产效率提高了很多。【5】怎么用API 已经上线,所有 GLM Coding Plan 用户都可以使用,支持 ZCode、Claude Code、OpenCode 等编程智能体工具。GLM-5.3 不再支持关闭思维链(thinking),只能在 low、high、max 三个思考级别之间切换。编程任务推荐用 max。计费改为积分制,非高峰时段(工作日 14:00-18:00 北京时间以外的所有时段,包括周末)消耗标准积分的 50%。通过 ZCode 使用还能享受 98% 以上的缓存命中率和限时 1.5 倍额度加成,叠加后相当于标准额度的 180%,活动截止到 8 月底。模型权重两周后公开发布。官网:网页链接

7. 智谱的 coding 套餐今天到期了,没有再续订,我感觉没有续订的意义了。我在 DeepSeek Harness 上使用 V4.1 flash 模型也还可以,基本能够满足自己的需求。另外,省下来的钱我也订阅了 WorkBuddy 的会员。因为 WorkBuddy 非常火,所以我必须研究它,然后出一些教程。国内用这两个 Agent 和一些第三方的模型就够用了,毕竟 WorkBuddy 当中可以选择的模型也有很多。当然了,我写作依然是用的 Claude Opus 4.6 这个模型,因为我依然认为这个模型是写作最好的一个模型。

8. 智谱涨价谁给的勇气

0
扫一下,分享更方便,购买更轻松
0评论

当前文章无评论,是时候发表评论了
提示信息

取消
确认
评论举报

最新文章 热门文章