美东时间2026年10月27日,谷歌DeepMind发布新一代世界模型Genie 4,把它定义为“迄今最逼真、交互能力最强”的世界模型。这和“吐出一段成片”的视频生成模型完全不同:官方描述它的工作方式是让事件先动起来,世界如何回应、发出什么声音、人物如何移动和反应,都由模型逐帧模拟给你看。这一代的增量浓缩成三件事:音视频同步生成、一句话实时改写世界、单场景连续模拟上限翻倍到约2分钟。华尔街见闻Google DeepMind博客
先是声音。官方将其定位为原生多模态:环境音、音乐和角色对白与世界同步生成,打开演示听到的声音,都是模型当场“做”出来的,而不是配乐轨道。第二是控制。交互进行中,一行文字就能换天气、加角色或移动镜头,环境跟着变,模拟不需要中断重来。第三是时长。按谷歌向媒体披露的口径,最长模拟时长提升到约2分钟,约为上一代Genie 3一分钟的两倍。Google DeepMind博客微博·嘉文钱华尔街见闻
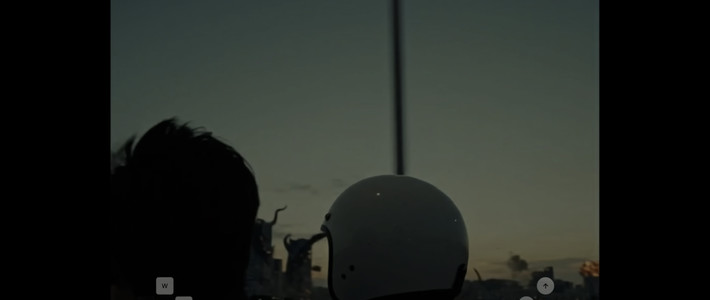
官方演示页里,一个男人在湖中的平台上吹萨克斯,乐声和环境声都出自模型,用户用键盘控制走位、用文字指令随时改变场景走向。传播最广的是那段港风飙车戏:玩家敲进两行提示词,“背景发生爆炸”“毁灭世界的巨型外星触手”,远处的天际线立刻火光冲天、触手砸落。Google DeepMind博客知乎·新智元
负责“导演”的是Gemini。官方明确由Gemini 3.8 Flash担任在环引导代理:持续观察场景、把目标拆成一系列步骤、逐帧检查每步是否成功,你一插话,它立刻改写计划。据媒体报道,谷歌团队试过用旗舰模型Gemini 4 Argon,但实时交互最终跑在更轻量的Flash上——对实时模拟来说,延迟是硬约束,规划者得跟得上渲染的速度。Google DeepMind博客华尔街见闻
自媒体层面的解读很乐观,有文章把这一代的记忆能力写成:推开一扇门,转身离开30秒,再走回来,那扇门依然开着。但有逐帧看过官方演示的用户指出了“出画再回来就变了”的细节:这一代世界模型已经能让你走进场景并即时改变它,还不能替你记住那个场景。谷歌自己的表述其实更直白:模拟时间变长、经过多次复杂编辑、或转回去看时,视觉细节和物体持续性仍会漂移。知乎·新智元知乎·leon鸣Google DeepMind博客
争议同样真实。有知乎用户逐句读完官方博客后统计,官方没有公布任何一个性能数字——没有分辨率、没有帧率、没有生成时长;他翻完Hacker News四百多条评论后的判断是:物理一致性才是这一代真正的短板,音频反而只是最容易的增量。知乎·梦兽编程
开放节奏分三层:研究预览先给少量经过筛选的测试者,未来数周向Google AI Ultra订阅用户开放,再逐步向部分开发者提供访问。谷歌同时强调,所有生成的视频和音频都会嵌入SynthID不可见水印,用于追溯AI生成内容。华尔街见闻Google DeepMind博客
落地场景上,影视测试者已经把它当作预演的“草稿模式”,在活的场景里反复调整机位、灯光和台词跑多个“镜头”。官方给机器人方向的说法是,它可以帮助构建机器人和智能体的训练环境,并解锁新的互动体验。华尔街见闻Google DeepMind博客
市场的反应则有前例:今年1月由Genie 3驱动的Project Genie原型开放后,Unity等游戏相关股票一度遭到抛售;这次实时操控与原生音频再加码,让AI冲击游戏生产成本的担忧重新抬头。华尔街见闻
但世界模型还不等于游戏生产管线。DeepMind产品经理Diego Rivas表示,公司正在与合作伙伴共同研究这项技术如何融入现有工作流程,以及它的能力边界在哪里,目标是扩大现有创作方式能够实现的可能性,而非宣告相关行业的生产流程被全面取代。谷歌给出的下一步方向是“混合世界模型”:由Gemini负责结构与叙事的推理规划,Genie负责逐像素渲染世界的样貌、声音与回应。接下来值得盯住的只有两件事:2分钟内的物体持久性,在普通Ultra用户手里稳不稳;以及下一代产品,会不会被迫把分辨率和帧率重新摆上桌面。华尔街见闻Google DeepMind博客