10月24日凌晨——偏偏选在1024程序员节这天——月之暗面发布了Kimi K3.1 Pro:K3.1系列首款模型,公司迄今最强的3万亿级参数模型,支持100万上下文,重点强化代码、3D创作、金融研究与长程Agent能力,完整权重将于11月4日前发布。 截至白天,知乎相关问题下的回答浏览量已经冲到150万+,B站、小红书的跑分解说和实测帖刷了一屏。知乎36氪
跑分是真的猛,吐槽也是真的猛。这篇把官方数字、第三方评测、社区实测和价格表拆开放在一起,帮你决定要不要把它换成主力编码模型。
 Kimi K3.1 Pro 官方发布主视觉
一、跑分层:离Opus差0.7个百分点,但"偏科"也写在数字里
先按信源把数字分个层——厂商口径和第三方口径,性质不一样。
官方口径:Terminal-Bench 4.0得分65.7%,超过GPT-6 Astra(58.2%),距Claude Opus 5.5(66.4%)只差0.7个百分点——对比栏里的友商分数也是Kimi公布的,非独立实测。 内部Kimi Code Bench 3.0长程测试61.2%,高于K3的55.95%;BenchCAD借助工具拿92.7%,接近Opus 5.5的96.2%。知乎36氪
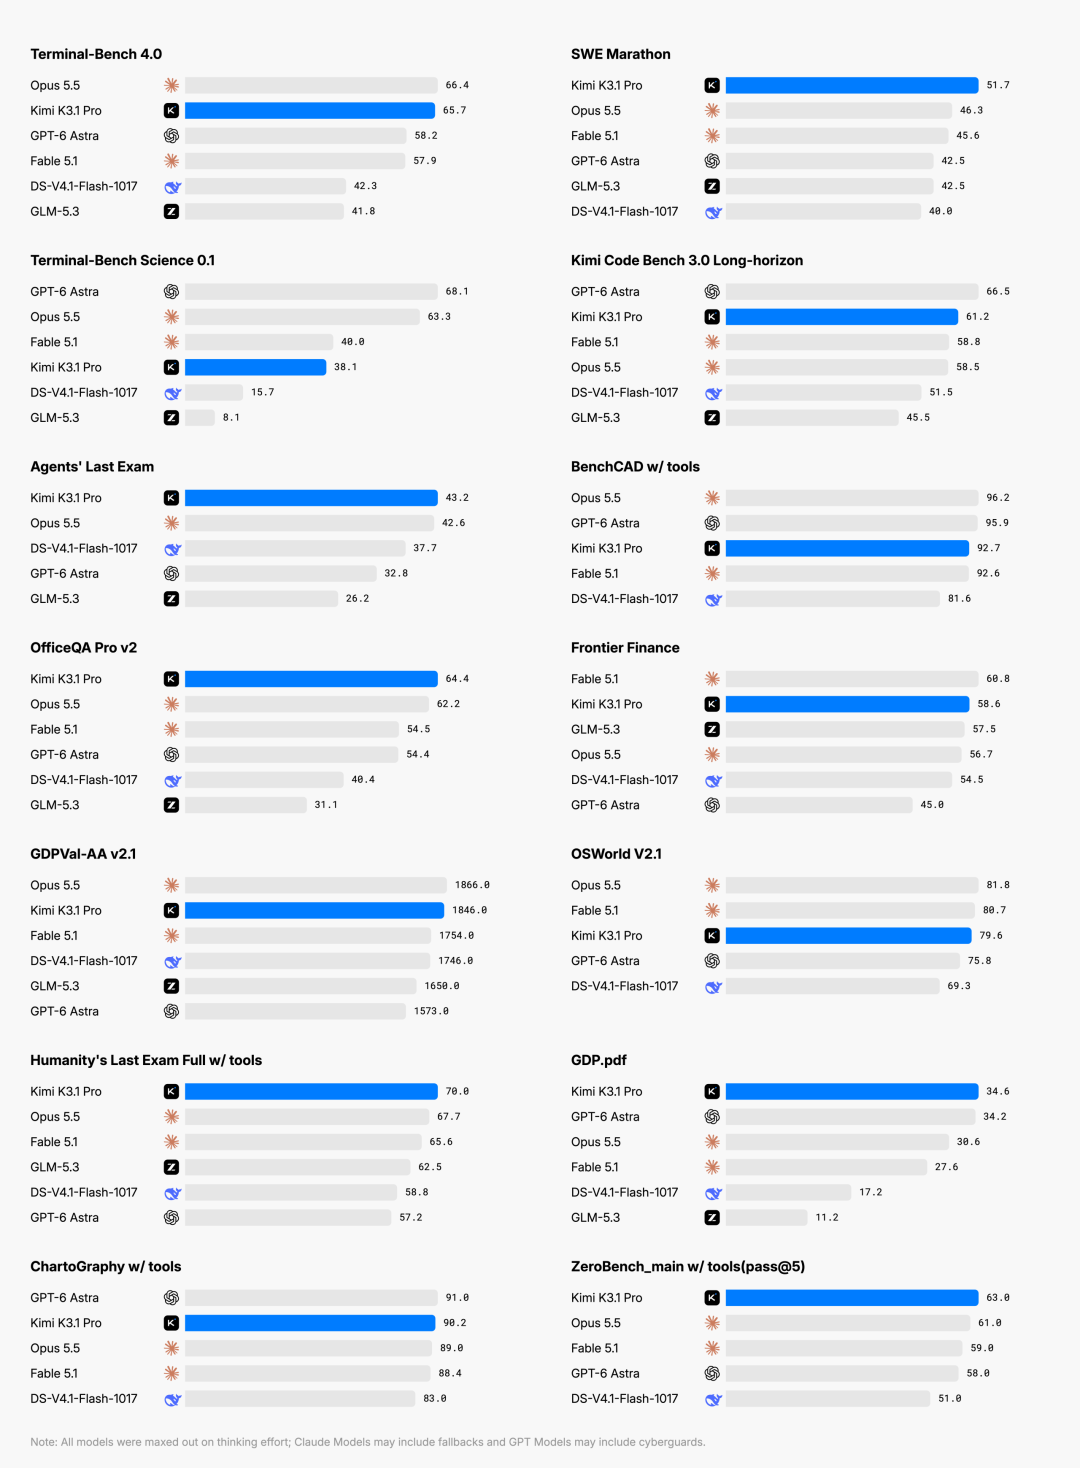 Kimi 官方基准成绩总览图
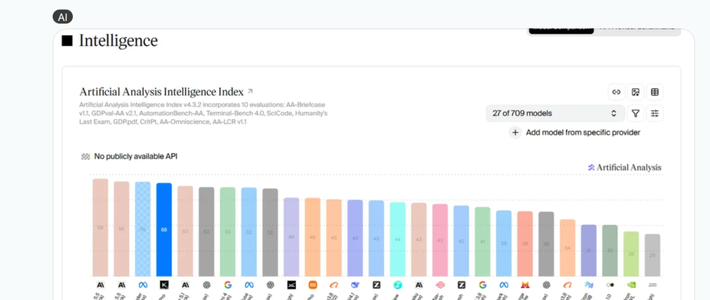
第三方口径:评测机构Artificial Analysis给K3.1 Pro的智能指数评了55分,全球第4,比上一代K3暴涨11分。知乎
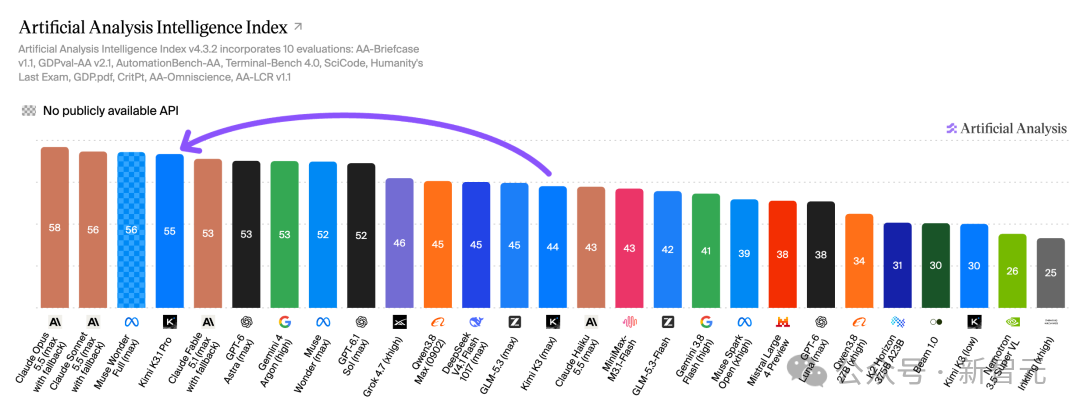 Reddit上关于K3.1评分超越Fable 5.1的讨论截图
AA还给出判断:一旦权重发布,它将登顶开放权重模型榜首,开源与顶级闭源的差距将从12分骤缩到3分——这是一句需要等11月4日才能验证的前瞻。知乎
把两组数字叠起来看,能发现官方宣传里没好意思强调的一点:AA数据显示Humanity’s Last Exam从47%到52%、CritPt从23%到25%、SciCode从59%到61%——知识类提升远小于Agent类。 代码、Agent、前端、3D很强,但"全面追平最强闭源"这个结论,证据还不够。36氪
二、实测层:不到10美元的天宫,和需要"多推三轮"的鹈鹕
跑分之外,社区实测给出了更立体的画像。
官方演示里最能打的两个:用虚幻引擎5.8在云海之上搭出半径1750米、36开间柱廊的天宫场景,3600万源三角形走Nanite与Lumen渲染。 以及基于含296个骨骼、402个肌肉组件的开源解剖模型搭人类行走仿真——在167项任务、420次独立评审中,把仿真人体从"几步就摔"迭代到连续行走11.2秒,中途还会自己放弃调奖励函数、转而去查仿真器动力学,揪出肩部肌肉力臂计算的36处错误。 这种"换思路而不是死磕"的行为,是长程Agent能力最具体的注脚。36氪知乎
 UE5.8云海天宫场景
新上线的3D Make也有独立实测:一张手绘三视图喂进去,约40分钟产出608行Blender脚本、可编辑.blend文件和1.7MB的GLB网页,尺寸误差控制在1毫米级;网友转述的虚幻云端宫殿案例,成本不到10美元。
但另一边,Reddit上一名AI游戏开发者的反馈泼了盆冷水:K3.1 Pro做"鹈鹕骑自行车"的高精度3D场景效果不错,却不是一句Prompt直接出成品,而是需要多轮"继续增强"指令——他此前用Opus 5.5一次Prompt就拿到了更完整的成品。 另有用户做汇编和嵌入式逆向体验不错,但普遍吐槽它"比Opus更啰嗦"。能力在线,交付习惯还得磨合。36氪
 OpenCode联合创始人对K3.1 Pro的评测反馈
三、成本账:话多、单价低,摊到每件事反而便宜了
这是本文最适合"自己算一遍"的部分。
冗长是实锤:AA测得K3.1 Pro完成整套智能指数测试累计输出约1.5亿Token,比参与评测模型的中位数(8700万)高出约72%,AA直接评价"非常冗长";输出速度约73.5 Token/s,也低于81.1的中位水平。36氪
但单价降了:中国区API标价为输入13元、缓存命中1.3元、输出68元(每百万Token),高速版约2倍价换2~3倍速度。 普通输入、输出单价都比上一代K3明显下调,一笔纯计算示例:10万普通输入加1万输出Token,标准版约1.98元。36氪知乎
摊薄到任务级:AA估算K3.1 Pro智能指数平均单项任务成本约2.11美元,同期Claude Opus 5.5约5.98美元、GPT-6 Astra约3.26美元。 翻译一下:它确实更费话,但费的话按降价后的单价算,总账反而比两个闭源对手便宜——"Token多"和"任务贵"是两回事,这是看跑分新闻时最容易混掉的一组概念。36氪
 Artificial Analysis 单项任务成本对比图
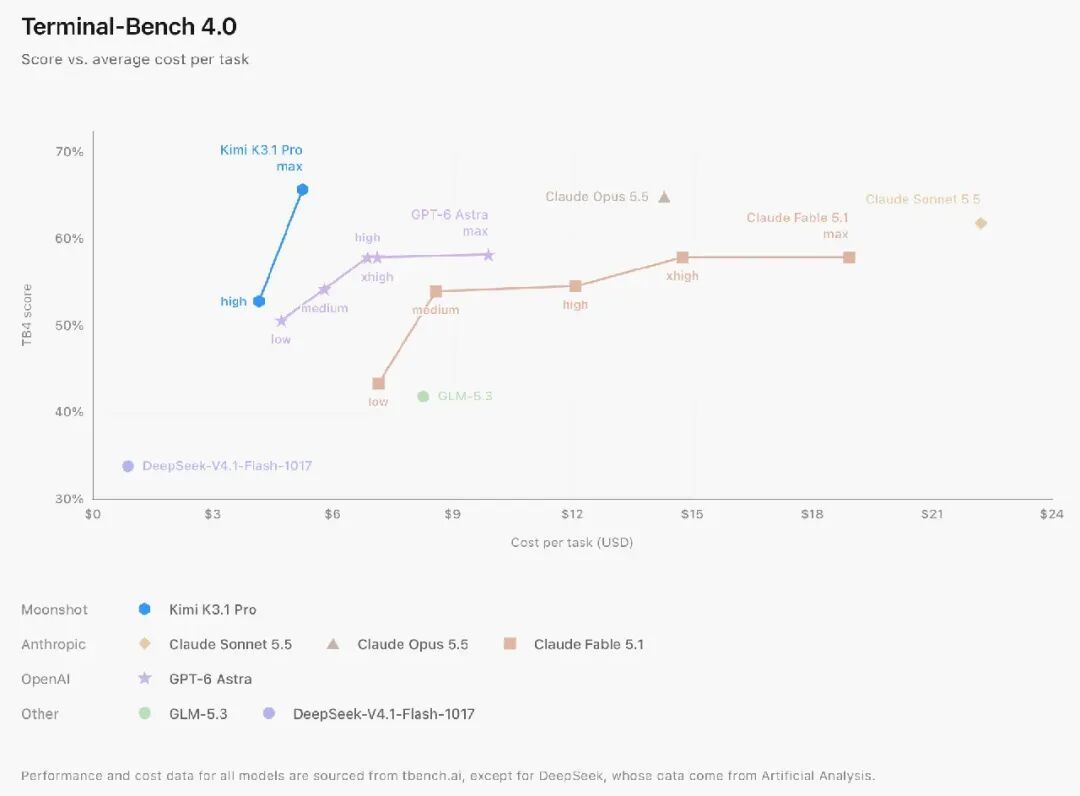 Terminal-Bench 4.0 分数与单任务成本分布图
四、额度墙:最集中的差评不是能力,而是"10分钟烧光"
社区反馈里声量最大的矛盾在这:API的账算得过来,订阅额度却算不过来。
InfoQ汇总的社区实测:一名99美元套餐用户跑了约47分钟、单个会话就触发5小时额度限制。 19美元套餐用户称一个任务就烧掉整个5小时额度;Reddit上更极端的个案是测一个基础3D游戏Demo,没开子Agent,约10分钟额度烧光、任务还没返回(个案口径)。 有人直言"模型再强,30分钟就撞额度墙,没法用于持续开发",甚至觉得按API价格直接用DeepSeek的Flash模型更划算,并开始实践"混合用模"——K3.1 Pro负责规划与复杂决策,便宜的模型承担大量执行。36氪
但反证也要摆出来:Claude用户同样报告过20美元档一个复杂Prompt耗尽5小时额度、Opus 5.5处理存量代码库约30分钟触发限制的情况。 额度焦虑不是Kimi独有的,它是"长程Agent"这个品类的结构性矛盾——模型越擅长持续搜索、调用工具、自我检查,单任务就越长,越容易吃穿推理预算。模型能力涨得比套餐上限快,墙就出现了。36氪
五、两个不那么好听的点:被主动砍掉的网安能力,和被扒出的宣发话术
开放权重版主动"缴械"。Kimi罕见公开了内部数据:训练中模型漏洞研究能力随后训练规模明显增强,若不删除网络攻防数据,xdev-bench-hard上pass@3可达90.5%;发布版同时删除中期训练和强化学习阶段的相关数据后,降到81.0%,且自评网络攻防能力仍落后公开发布至少3个月的前沿闭源模型。 开发者对此分裂成三派:认为这等于承认"内部能训出更强版本只是不放"、担忧删安全知识会伤及它写安全代码的能力、以及认可这是3万亿级开放权重的现实折中。"开放多少能力"第一次成了模型设计的一部分——这个问题今后只会越来越多地砸到每个开源模型头上。36氪
宣发翻车。知乎相关问题下浏览量最大的回答不是夸它的:X上有开发者拒绝参与Kimi的宣发合作,随后官方话术模板被泄露——"便宜5倍的开源版Opus 5.5"“中美前沿模型差距缩到一个月”。 把营销口径和AA实测并排放,你就能看清哪些句子需要打折:比如"1/5价格"对应的是单价叙事,而第三方口径的任务级成本优势没有80%那么夸张。看国产模型发布,先把厂商话术和独立数据分箱,已经成了必备动作。知乎
六、所以,谁现在该动,谁该等
API/按量用户:值得立刻拿真实任务试。建议照社区总结的方法做——挑一个你熟悉的小任务,改一次需求、导出一次结果,同时盯质量和Token消耗,这比看任何演示成品都准。
订阅重度用户(尤其跑长程Agent的):先别急着把主力切过去,重点核对你的套餐档位下5小时额度能撑多久——这是目前最集中的雷区。可以考虑混合工作流:强模型规划、便宜模型执行。
等本地部署/开源的玩家:现在在线可用≠权重已公开,完整权重官方承诺11月4日前发布,届时再看量化版、显存占用和AA那句"开源登顶"能不能兑现。
不会写代码的Vibe Coding用户:3D Make和Kimi Work(桌面端需3.1.0+版本)把"描述→成品→在线改"的链路做短了,是这个节日里最适合顺手一试的增量。
1024这天,Kimi端上来的是这半年国产模型里少见的一盘硬菜:跑分、实测、价格三条线都能打,但额度墙、偏科和"自我缴械"三个问号同样真实。证据覆盖到这里,结论就说到这里——切换与否,取决于你是付Token的人,还是付订阅的人。