10月27日,百度发布并开源文心 Unlimited OCR 2,把 OCR 的处理上限从“数十页”推到了任意页数,实测能一口气解析《哈利·波特》全系列 7 部作品、超过 3600 页。这次开源解决的是长文档“输入”端——页码上限、显存爆炸、批量排队——这三关;还没解决的,官方技术报告也写得明白——能“读完”,还不能“读懂整本书”。文心基础模型据媒体报道下周将有新进展公布,内容尚未官方披露,用户真正需要理清的是:哪些痛点已经被跨过,哪些还留在官方的“未解决清单”上。观察者网
已经跨过的痛点:转录成本不再跟着页数涨
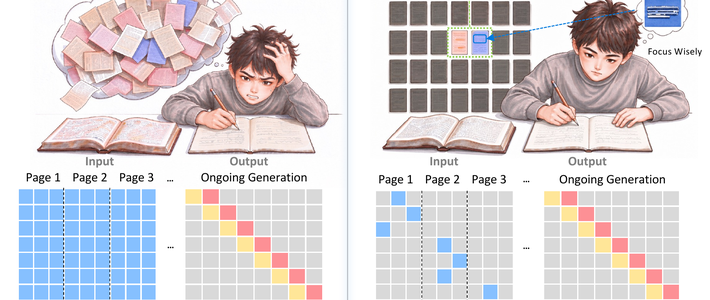
上一代 Unlimited OCR 已经把解析范围拓展到连续数十页,但页数一多,参与计算的视觉信息成倍增加,显存和耗时一起涨;拆成单页跑,跨页段落和表格又会对不齐。Unlimited OCR 2 的思路叫 SR-SWA(稀疏参考滑动窗口注意力),官方拿人类抄书打比方:盯住当前页,需要核对前文或查跨页信息时才回看相关页面,页面门控把视觉参考范围从整个文档缩到相关页,再用得分最高的视觉 token 桶捕捉长距离依赖。知乎
推理端的降幅更直观:单序列推理的峰值 KV 缓存从 47.00GB 降到了 1.77GB。16 路并发测试里,吞吐量从 360 TPS 提到 1315 TPS,约为原来的 3.65 倍——对企业批量解析文档、知识库批量入库这类场景,缩短的是任务排队的长度。实测门槛也在往下走:有工程师用一块 16GB 显存的消费级 AMD 显卡跑通了这个约 3B 参数、MIT 协议的模型,把一本横拍的 229 页物理教辅重建成可检索、带公式 LaTeX 的干净文本。但门槛没有消失,官方快测环境仍是 A800-80GB 档,模型卡没有向消费级小卡承诺极长上下文的稳定。模型加载还涉及 trust_remote_code 远程代码,生产环境建议先审源码再上线。知乎知乎知乎
开源与榜单:自己造的尺,自报的分
代码与权重已同步开源到 GitHub、Hugging Face 和 ModelScope,官方仓库的发布记录写明,这一代是“以 SR-SWA 实现无界长度解析”,并放出配套新基准。官方基准成绩:多页解析的 MPDocBench 得 84.6 分,百页级超长文档的 MarathonDocBench 得 77.1 分,端到端达到 SOTA 并大幅领先多家闭源大模型。需要留意的是,后者恰是百度与模型同一天开源的新基准——对照的尺由被测方自己造,领先幅度以自报口径理解更稳妥。前作的热度倒是独立的:6 月发布次日就拿下 GitHub、HuggingFace 四榜第一。知乎GitHub36氪
未解决清单:官方报告先认的账
技术报告的限制部分承认:当前的稀疏注意力机制没有保留全局文档信息,标题层级等文档整体结构的理解仍受限。落到实操,最危险的正是跨页表格——表头在上一页、金额在下一页,错位后输出的是一张格式完全正常、内容已经跑偏的表。普通用户的体感则更直接:把论文、教材、扫描件丢给 AI,想让它总结重点、做 PPT,结果章节会串、表格会乱、关键数字还可能认错。图像转文字这半程刚被解决,转完之后 AI 懂不懂整本书、知识库检索答得对不对,靠的是基础模型的长上下文与结构理解,这是另一道题。知乎微博
下周的新进展:目前只锁定了时间
吴甜的离职由百度公关经理在朋友圈证实:已结束在百度的任职,技术工作仍在向前推进。另据 Tech商业报道,吴甜此前已卸任基础模型研发负责人,转岗百度研究院副院长。接近百度的消息经观察者网等媒体披露,文心模型方面下周会有新进展对外发布。微博36氪观察者网
官方日程里,下一个可见节点是 11 月 12 日的百度世界 2026 大会:将进一步展示文心 Unlimited OCR 2 的技术亮点与应用潜力,并发布“芯云模体”全栈 AI 最新升级成果。知乎
下周发布的内容官方尚未披露,无法预写它“会解决什么”;但验收标尺其实已经摆好——全局结构理解、跨页合并、整书级问答这三个官方自认的短板,模型端是否迈进一步。Tech商业分析文心过去一年失速时点到的,恰恰是用户体验上“长文档的跨章节关联不够精准”。36氪
对每天和长文档打交道的人,不必等:权重 MIT 开源,先拿自己最痛的材料做小样本对照——扫描表格、公式密集的讲义、跨页表格各测一批,跑得快还要看得准,两头数字都出来再谈迁移。至于下周和 11 月 12 日,盯着的是同一件事:官方那份“未解决清单”上的名字,会被划掉几个。