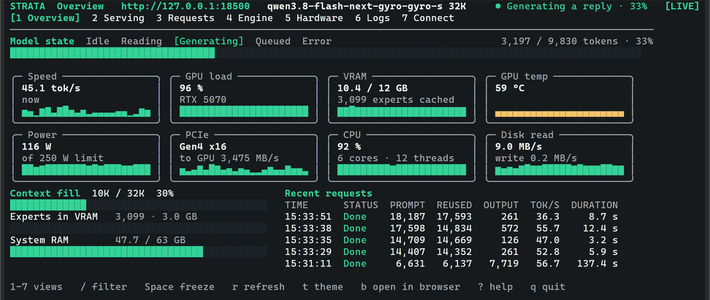
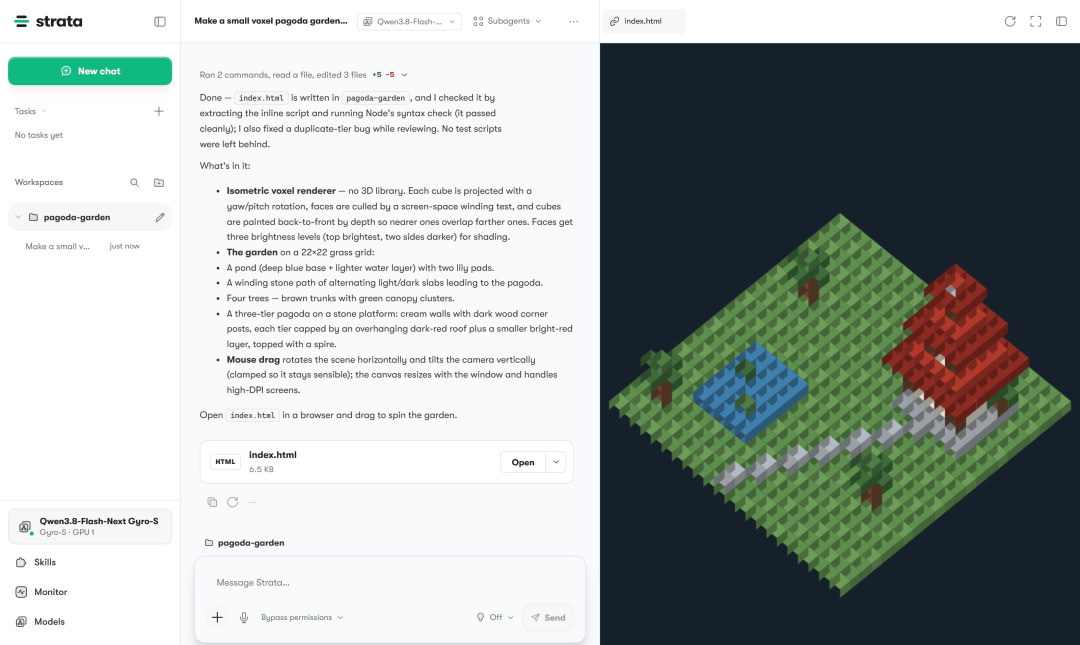
本地大模型圈这周过了个好日子:开源推理引擎Strata在B站和小红书刷屏,教程标题出奇一致——“12G显卡就能跑DeepSeek-V4.1-Flash”。这颗7630亿参数、384个专家的MoE巨兽,官方部署要烧一大笔硬件钱,如今一张中端游戏卡也能跑起来。哔哩哔哩小红书
但在播放量4.5万的教程视频下,一条306赞的评论把账算得很直白:需要12G显存的显卡、64GB的内存、250GB的SSD,实际输出6~8 token/s,评价为拉完了。一句话点破死穴:12G从来不是能力指标,只是门票;验票的是内存。哔哩哔哩
Strata玩的是"高科技低配用"
原理不神秘:传统推理默认模型参数常驻显存,763B对消费级显卡想都别想;Strata把模型拆开分层跑,装不进显存的部分下沉到系统内存和磁盘。有拿4060 Ti实测的玩家说得直白:“Strata不是把整个模型硬塞进16GB显存,而是让显卡、系统内存和CPU一起干活”。知乎
本周的火是量化版本点的:新量化把每个权重压到约2比特,IQ2_XXS档直接"完全保住了原版实力"——AIME25满分、GPQA 90.91、任务平均恢复率100.0%。小红书
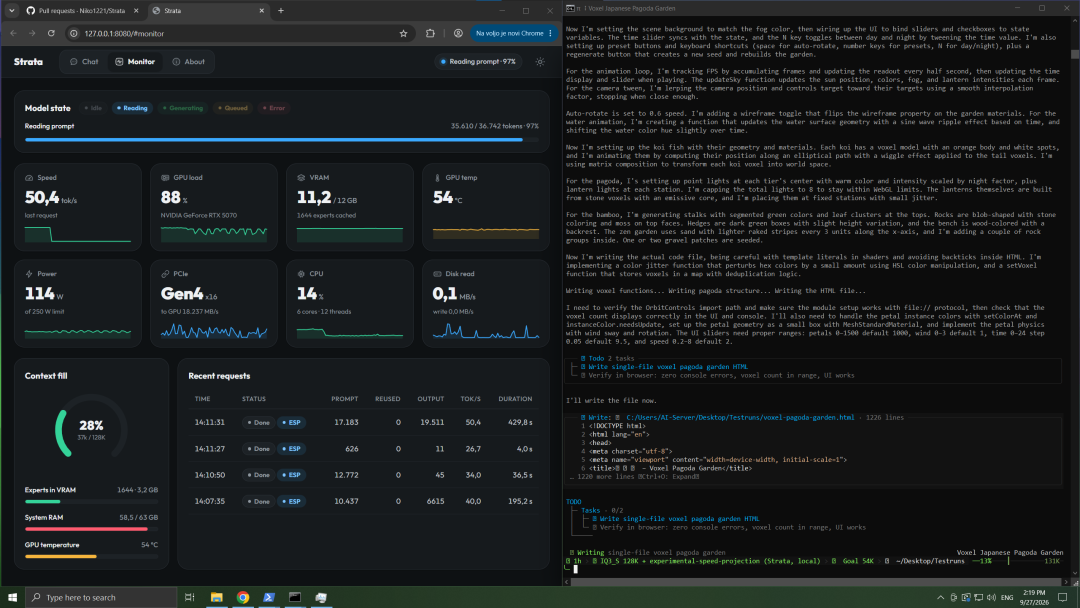
那为什么还是慢?速度上限不在显卡
社区实测按配置摊开就很清楚:
12G卡+64G内存+250G固态:输出6~8 tok/s。
EPYC 7402+双3090+DDR4-2666:输出约30 tok/s,prefill只有100 tok/s,长上下文基本不可用。小红书
洋垃圾E5+64G DDR3(内存约500元):128K上下文跑出35 tok/s。哔哩哔哩
官方用251GB内存的机器跑DeepSeek V4.1-Flash:也就是接近30 tok/s。微博
规律一句话:显卡决定能不能启动,内存容量决定能不能装下,内存带宽决定每秒吐几个字。MoE是"每写几个字就换一个专家"的架构,每换一次都要在内存和显存间搬运——带宽就是手刹。
量化"100%恢复率"能信吗?信一半
跑分满分是事实,社区高赞质疑也是事实:题答对再多也没意义,“还是只能在自己的使用场景里去测试对比,才有意义”。真实反馈同样分裂:有人觉得日用干活够用,也有人嫌"文本输出质量越来越拉"。一轮超长思考能生成两万七千多token、接近10分钟才结束。烧掉的时间和电费,都是账。目前诚实的结论:跑分层面100%恢复暂未见反例,实际体验层面证据不足,拿自己的任务测了再定。小红书哔哩哔哩知乎
上车前,对一下自己的账
值得装:手里已有64G甚至256G内存和空余NVMe固态;有合同、病历、代码这类不方便上云的数据;能接受10~30 tok/s的节奏。新版已经把入场墙砍到内存加显存合计约27.6GB,图形界面、中文界面和模型推荐都安排上了。微博
不值得装:只有32G内存的玩家,有人懊悔"只恨去年没把内存条插满"。偏偏内存还在涨,有报道里"原本600元的内存条,如今售价升至2000元"。用惯了超长上下文API的,prefill会让你最难受。指望"完全替代云端、实现token自由"的,先算账:不想折腾的话,最划算的还是买云端token,本地部署很难赚回来。小红书抖音知乎
门票确实发出来了,牌桌上也确实坐上人了——但门票只是门票,戏好不好,得看座位。