九月初Qwen3.8-27B开源,两周过去,本地圈直接裂成两半:一半在放火箭——有开源引擎把27B推到"稳跑150t/s",那条两万八千播放的视频评论区都在喊"上百t/s真的回不去了"。一半在泼冷水——8G显存笔记本实测两晚的结论是"能跑,但自由俩字你先掂量";还有人花两千八买了张5060Ti,跑大半年总结"三个用途两个行不通",那张卡 coding 场景的真实身份是"昂贵的摆设"。哔哩哔哩
夹在中间最难受的是这么一群人:手上或正打算买一张16–24G显存的卡,想把27B当本地主力,替云端跑代码、跑Agent、日常对话。你大概认识Ollama,知道GGUF,但每次准备动手,找到的关键数据只有一句会害人的话——“模型11.8GB,显卡12GB,装得下”。
我把知乎、B站、微博、小红书上九月份关于27B的部署实测、量化推荐和评论区踩坑记录扒了一遍,替你算成三笔账。算完再决定掏不掏钱,至少能省一张卡的学费。
第一笔账:装得下≠用得上,墙不止一道
这半年圈子里最大的误判,就是把"模型文件大小"当成"硬件需求"。27B九月的量化混战刚好把这个错误集中摊牌:有博主实测那颗11.8GB的GGUF塞进12GB显存——模型加载完,留给上下文的只剩24MB,等于书房装修完了没地方放书。另一颗被吹上天的4-bit文件16.5GB,官方口径"总内存16到19GB就能跑"——那是对话能开机的线,不是干活的线。哔哩哔哩哔哩哔哩
这些账拆到底,27B要过三道门:权重(文件大小)只管第一道;真正决定"能不能干活"的是第二道KV缓存——上下文能开多大,和第三道——开大了之后还剩多少速度。讲多用户并发原理的那期视频有句好记的话:“显存即座位数”,70B模型在128K上下文下单用户KV缓存就能占掉40GB,上下文长度而不是显存总量才是天花板。哔哩哔哩
所以九月16G卡玩家最扎心的反馈是"权重装进去了,上下文不够用"。两种野生解法都真实存在:一种把内存当KV池,每轮只把与当前问题最相关的KV换回显存,作者自测5060Ti 16G能到256K上下文30+ tok/s,代价是256K要占10GB以上内存。另一种是GSQ量化分支,16G显存开126K上下文、40tok每秒,还保住接近bf16精度的KV——这条视频5680播放收了402个收藏,评论区全在求教程。哔哩哔哩哔哩哔哩
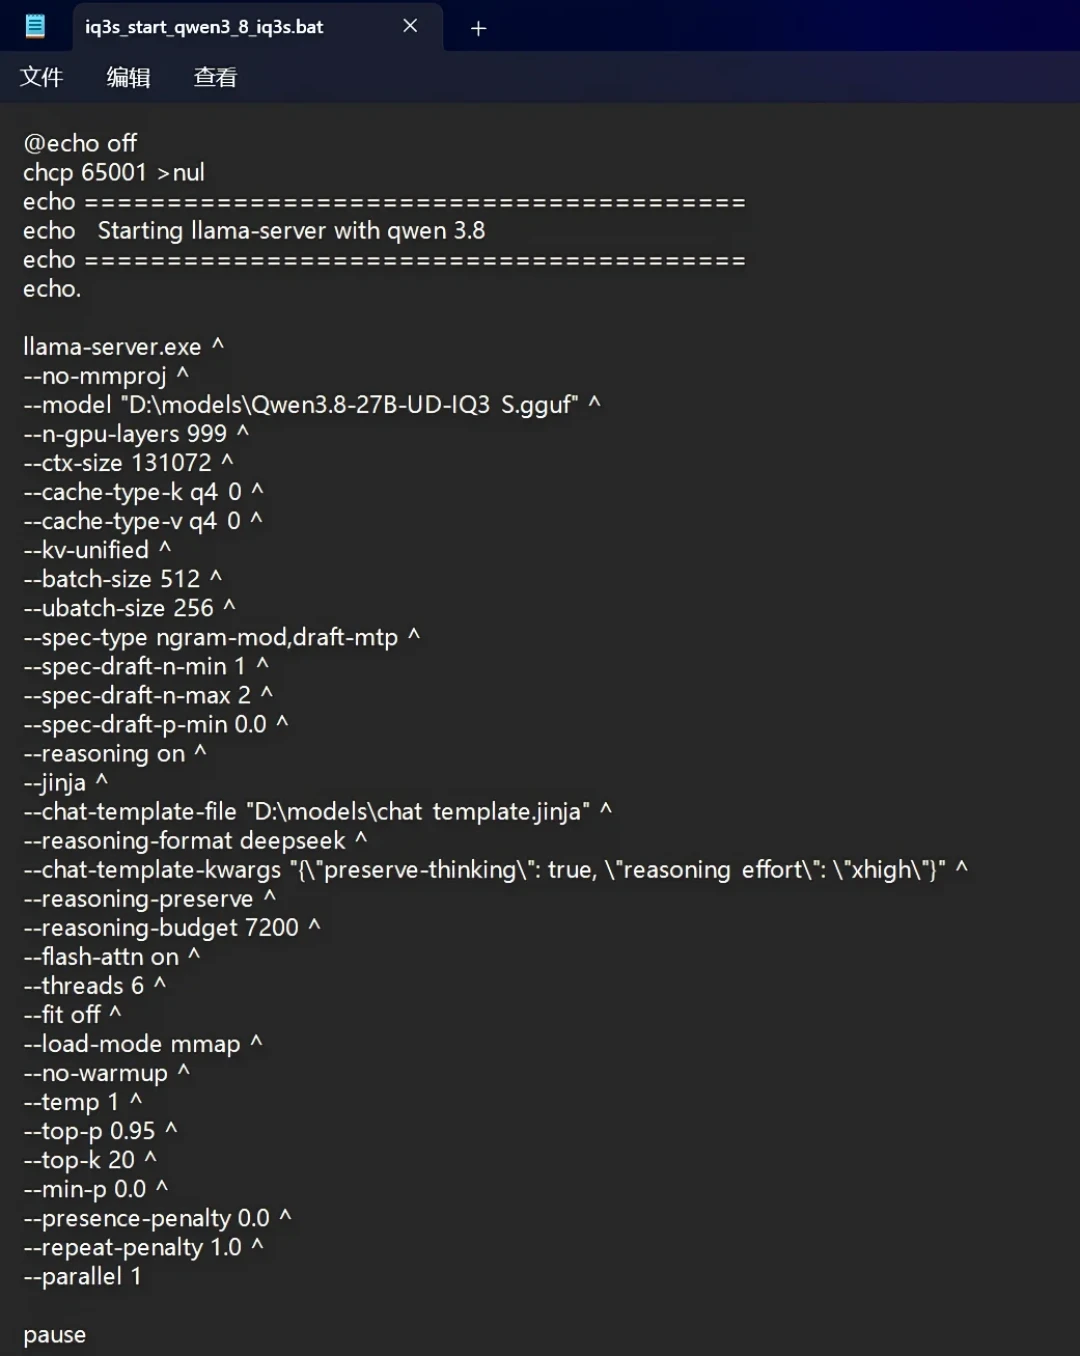
小红书那张被收藏612次的《16G显卡Qwen3.8-27B本地最佳实践》给了最直白的抄作业样本:选unsloth的UD-IQ3_S量化(权重11.2GB),128K上下文占显存14.5G左右,稳定40+ token/s,写稿跑代码批量处理都不在话下。小红书
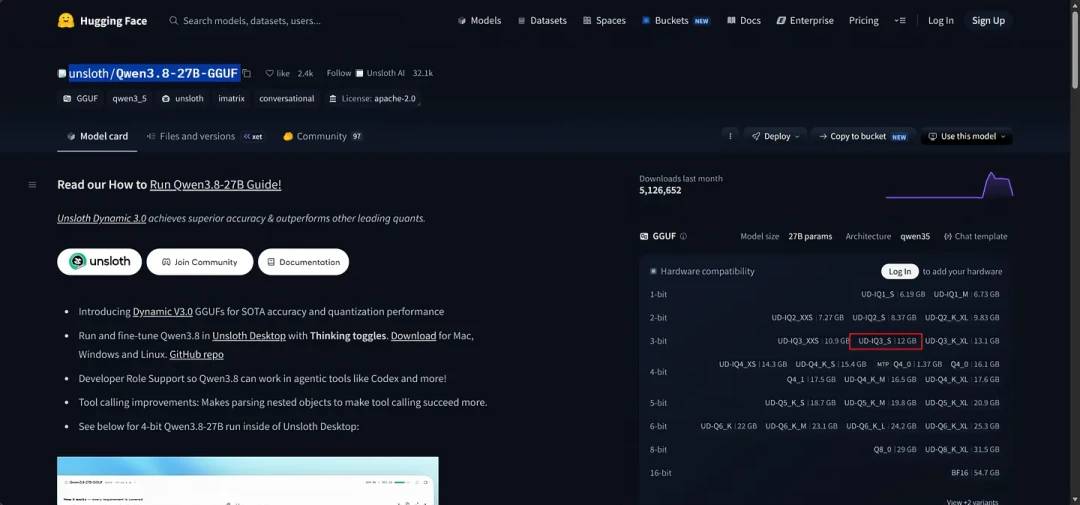
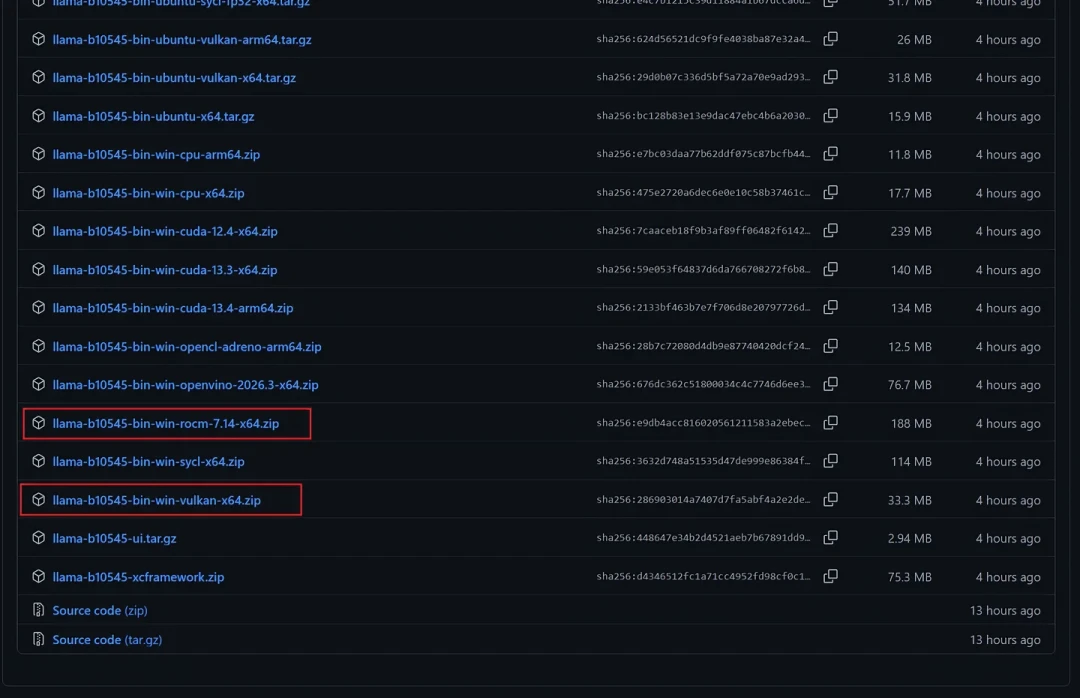
帖子里还藏着一个新手必踩的坑:AMD卡别死磕ROCm,llama.cpp选vulkan构建才丝滑——下载页里rocm和vulkan后缀一字之差,选错就是天天掉驱动。但要注意:这些方案全是社区猛改的野生分支,框架只认特定量化版本,模型文件一更新教程就作废——连那款150t/s引擎的专用模型都悄悄从16.9G换成了19G,照旧教程操作的人当天直接加载失败。小红书
第二笔账:分卡位看速度,"150t/s"没人明说的价签
九月全网实测汇总下来,速度大致是这个梯度。8G档不建议碰27B主力:同配置实测里,跑完一轮系统可用内存能掉到1G出头,长任务前得重启整个环境,不然直接崩。16G档用野生方案能摸到30–40 tok/s@126K–256K(上一笔账已拆),裸跑Offload则是"等它写完一个函数,我手动都写完了"。知乎
24G档是本月口碑主战场。3090玩家给出了一张罕见的双方案对照:Ollama跑Q4最省事,但上下文只有64K、解码38.6 tok/s;换vLLM+投机解码+KV压到4/2-bit,直接240K上下文、短文解码113.5 tok/s,快了2.9倍——代价是240K模式砍掉视觉功能,偶尔发图还得切回Ollama。微博玩家的判断更直接:“24G就是当下本地LLM的甜蜜点,16G玩啥都玩不了,32G相对24G也没什么提升”——这句有争议,往下看。小红书微博
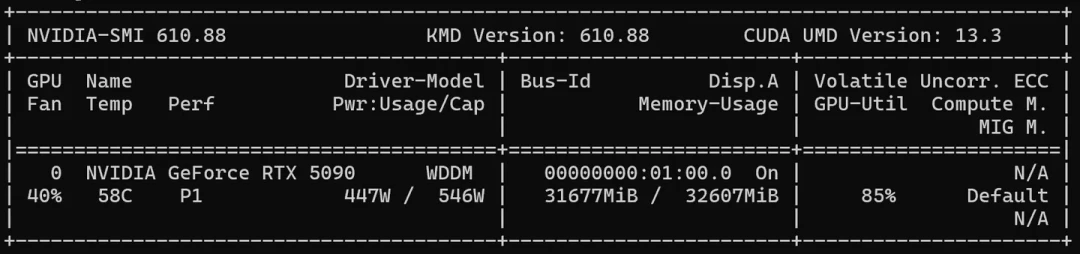
32G/5090档才是"火箭党"的主场。知乎有玩家总结:nvfp4量化+专用推理框架,32G显存能跑出近百token的输出速度和两千多token的prefill。评论区的5090D用户用pi agent跑编码任务,160K上下文下多数时候稳在200 token/s以上、峰值220。还有人晒出nvidia-smi:27B权重加KV缓存把32.6G显存吃到31.6G,一张图就是"显存账"的实物证据。知乎哔哩哔哩
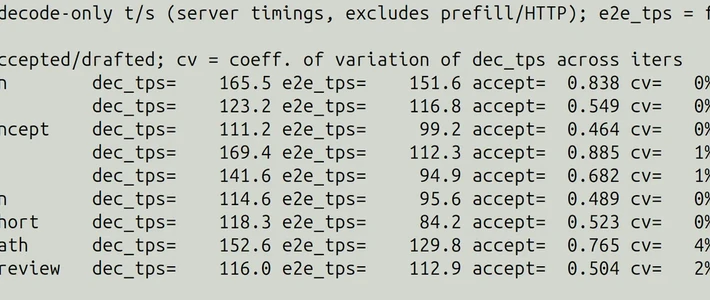
投机解码是这个月速度跃升的真正推手:DFlash 2配合oMLX,M5 Max上的27B能到约70 tok/s、最高4.6倍无损加速,作者自己5090+llama.cpp逐任务实测峰值170 tok/s。另一路5090 FE实测同样指向真实干活的状态:长推理稳态87 tok/s,接入DSH跑真实Agent任务95 tok/s、上下文拉到123904。小红书小红书
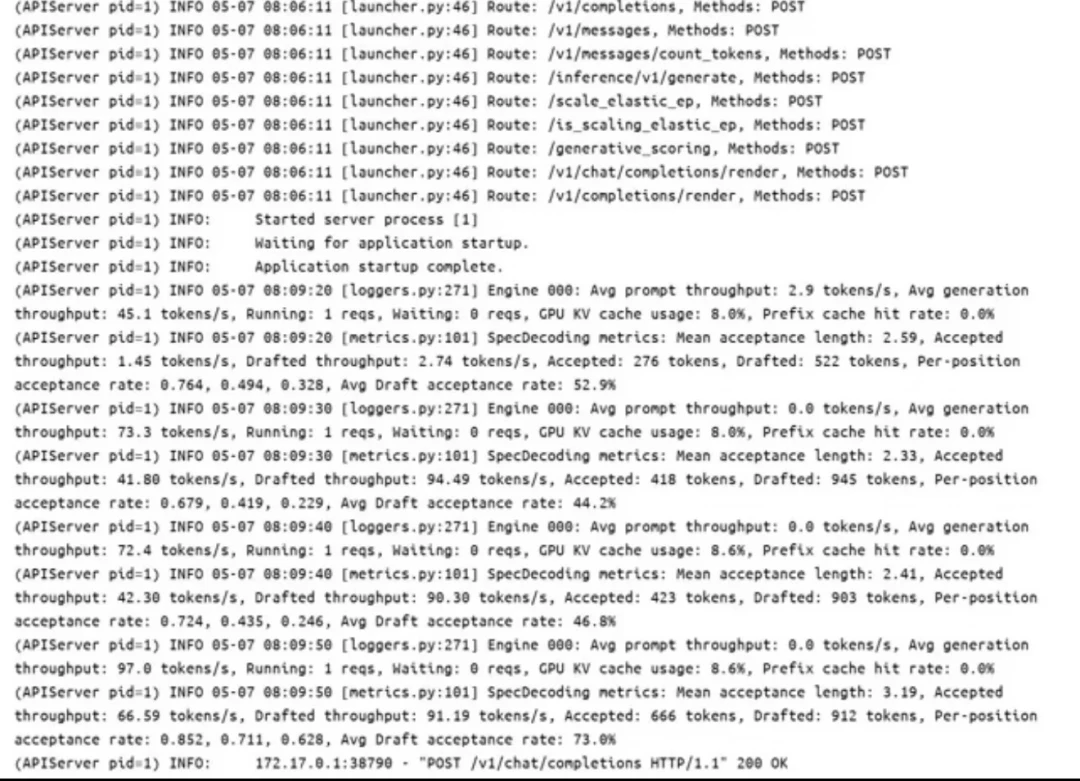
但比速度数字更要紧的是价签。有玩家实测发现:那款150t/s引擎的专用模型把思维链限制在约7K——同一道难题,原版要烧5万到7万token思考才能解对,快模型开到最高思维也只有7K,直接答错;Tool Calling不稳、不支持多卡、连GSQ量化都不兼容。九月的"火箭速度",本质是拿一部分智力和生态换几倍吞吐:拿来折腾,血赚;当主力干活,再等等。哔哩哔哩
第三笔账:钱——"token自由"的答案本来就是分层的
本地圈算账的完整口径,九月罕见地正反都齐了。微博一位消费级部署博主的结论是:愿意花接近十万(比如M5 Ultra 256G),flash next的Q8水平约在国产前五,电费加折旧已经低于token plan,还免疫云端429和量化缩水——这个档位,自由是真的。但反方同样成立:有人一句话点破——显卡钱够换好多API credits了,速度还慢、并发低、上下文短、量化狠、缓存难伺候。5060Ti买家半年实测的原话是:“每月几十块的API钱,比折腾硬件便宜太多”;知乎也有热帖提醒"这破玩意比较鸡肋,花钱买24G以上单卡能选的只有5090DV2和5090满血版"。微博小红书知乎
真正的成本模型得按人拆开。纯编码/Agent用户:九月社区共识仍是云端碾压——上下文、速度、生态三墙叠加,“等它改完黄花菜都凉了”。图生成/创作重度用户:本地唯一真正回本的场景——出一张图的边际成本接近零,同一构图跑二十个种子、LoRA从0.6扫到1.1随便试,高频出图的卡钱就是这么省回来的。隐私敏感+被云端伤过的用户:动机还在变硬——GPT-6类产品的五小时限额让Agent任务烧完额度也"跑不完"。第三方API拿27B冒充Max你根本查不出来。本地至少把"我用的是什么、还能不能用多久"攥回自己手里。知乎知乎微博
该动手的、该等的人
手里16G卡想折腾:别换卡,等90天。16G的全部玩法都是野生hack,让27个量化版先收敛、让引擎生态先稳定。正打算按24G档预算买卡:这是本月被反复验证的甜蜜点,64K到240K上下文各有实测背书,但预留两三天折腾时间,别指望开箱即用。8G显存老笔记本:放过27B,小模型聊天+API干活才是正解,别为口号交学费。十万预算党:自由是真的,但先看你月度token账单是否大于机器折旧——是,就上;不是,你买的其实是玩具里最贵的那个。
最后盯三个信号:那款火箭引擎何时解决Tool Calling、多卡和通用量化的兼容;"媲美27B、上百tok/s"的新模型会不会来(评论区高赞愿望);端侧内存技术还在提速——交大与UC系团队开源的"8G显存跑35B、40Token每秒"和把35B压进1–2.5GB峰值内存、手机也能推理的Edge0,都在往"显存墙"的根上凿。这两年本地圈的老规律是:答案永远在下一个版本里——所以最聪明的花钱方式,往往是先把手停在购物车上。小红书小红书