这几天,AI圈最热的新模型,既不是新的GPT,也不是Claude或Gemini,而是一个连"1+1等于几"都不愿意开口回答你的家伙。
它叫Jev,9月15日由一家叫TypeSafe(TypeSafe AI)的创业公司放出,拿了DCVC领投的4000万美元种子轮。发布推文浏览量超过3000万、点赞6万+。拥有约38万粉丝的开发者博主ThePrimeagen嚷着要接进自己的自动化工具,开发者写作者Dan Shipper说团队实测了一周,赌"6到12个月后它会变得不可或缺"。而在中文社区,知乎相关问题浏览量冲到11万+,高赞答案却在骂它"套皮分类器"。知乎36氪
会玩的、会买的、会怀疑的,全到位了。这篇就替跑Agent、天天给LLM写路由和分类prompt的你,把这场热闹拆成三层账:它解决了什么真问题、哪些说法有证据、哪些争议还没结论,以及你该不该现在就把它接进管线。
第一层账:你的程序其实养了一堆"写作文的分类器"
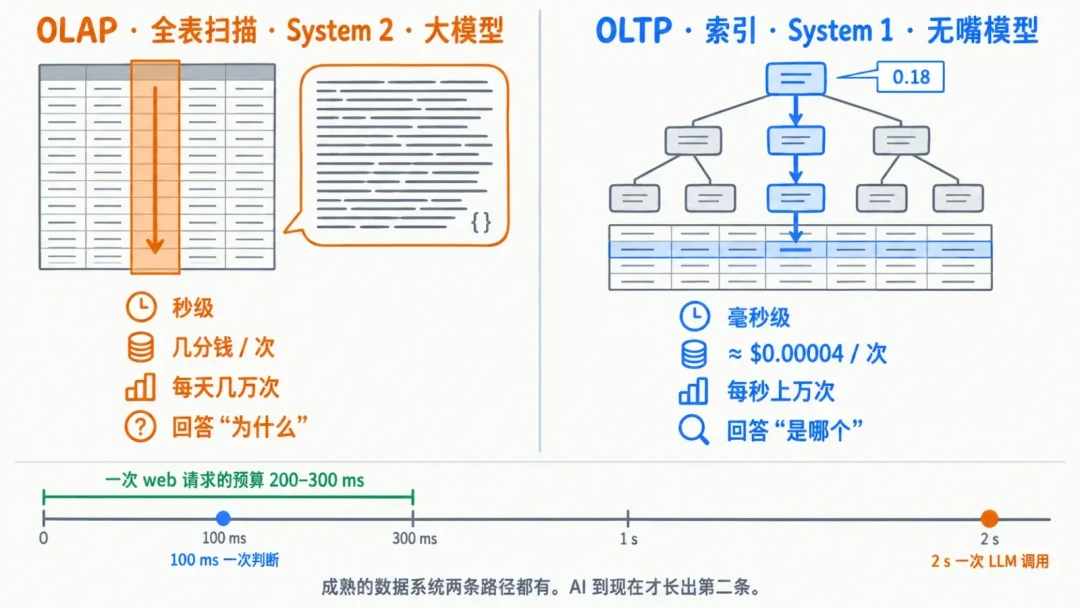
先说清楚Jev是什么:一个不做任何自由文本生成、只输出"类型化概率决策"的模型。你给它一段状态加一组题目——这是哪类工单(选择题)、严重度几分(评分题)、要不要现在叫醒值班(判断题)——它在70到500毫秒内把所有题目的概率分布一次吐回来。定价是每百万输入token 0.042美元,输出干脆免费:反正它压根没有输出token。知乎
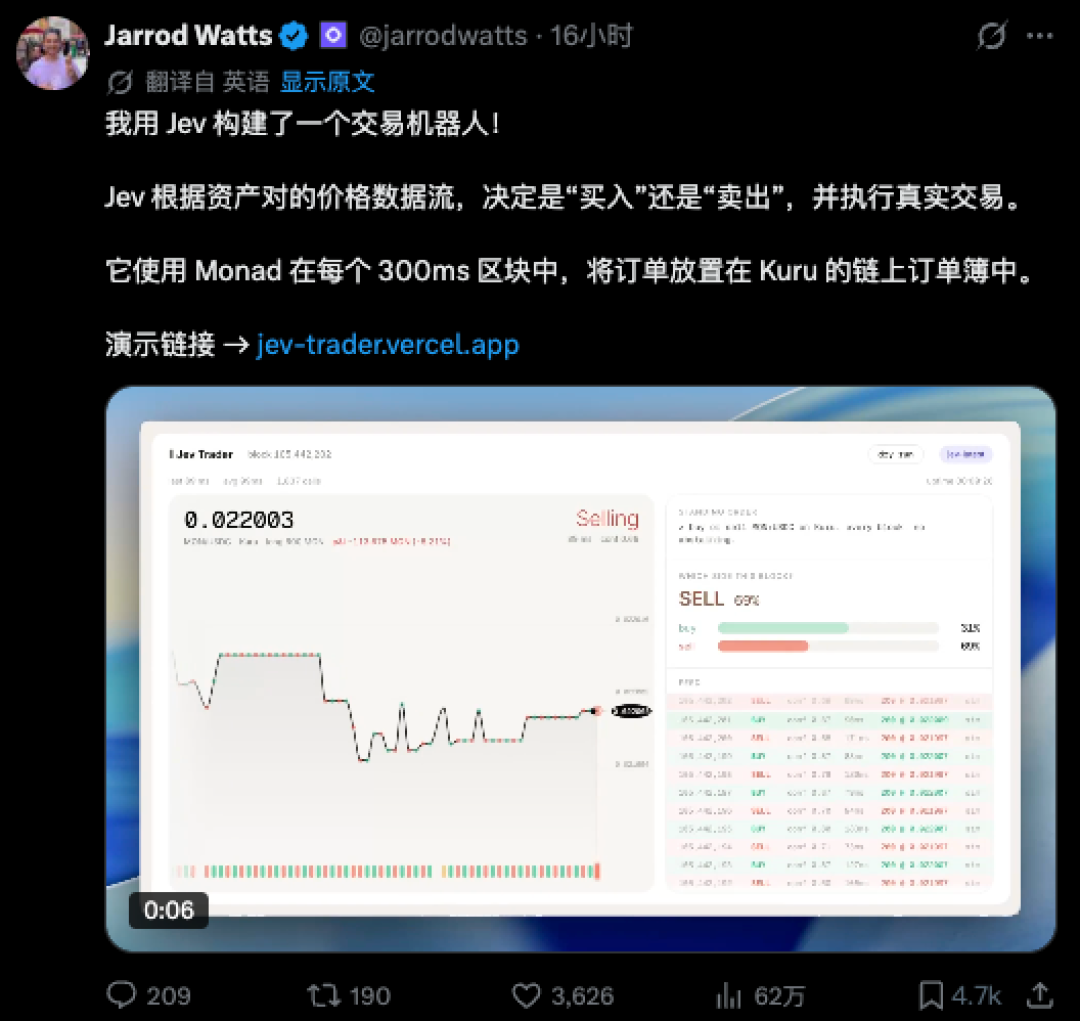
这个模式有多戳痛点?冯若航有句话概括得狠——大量判断只要一个很短的答案,我们却给它套上了长篇生成的外壳。 你的管线里有多少这样的调用:工单分诊、内容审核预筛、注入攻击检测、Agent工具调用的安全检查、RAG相关性打分——答案空间事先就知道,要的就是几个bit。可今天让大模型干这活,你得写prompt、等它推理、生成一段合schema的JSON、解析、校验、失败重试。一个bit穿着两千token的马甲。知乎
官方给的最出圈的演示是拿Jev打《毁灭战士》:一秒约10次决策,全程流畅走位开枪,一小时成本约7美元——而且用的还是通用版,不是游戏特化版。开发者们还玩出了花:Marcel Pociot做了个浏览器插件,后台用平均380毫秒一条的速度实时折叠引战帖。有人让它操控浏览器查苏黎世到伦敦的航班,全程7.1秒,选按钮用Jev、填文字再叫一个小语言模型代笔。36氪知乎
TypeSafe创始人Diogo Almeida的背景是热度的另一半来源:前OpenAI研究员、InstructGPT论文作者之一——当年正是这套RLHF方法教会GPT"好好说人话"。教了几年AI说话之后,他离职创业两年,第一款产品的卖点居然是不会说话。这个叙事本身就值一次转发。知乎
第二层账:机制不新,新的是交付形态——但"校准"这个词才是核心
高赞质疑先摆出来。知乎赵泠(266赞)的判断很直接:这就是"一个窄接口的、根据自定义标签给出加权分数的JSON分类器套上’前沿模型’的皮"。论据也硬:OpenAI的Structured Outputs、Anthropic的tool use、Outlines的语法约束解码,早就能让模型"物理上无法输出选项之外的字段";读logprob做选择题,学术界从2020年MMLU评测就在用;Qwen3-Reranker官方示例直接取yes/no的logit归一化打分,从没调用过生成。更扎心的是,有推特老哥看完发布,据说用2小时基于一个1B小模型复刻了同类效果。知乎
但把这些噪音滤掉之后,懂行的复盘反而指出了真增量在哪。模型最后一层本来就是softmax概率分布,自回归只是"一个字一个字往外挤"的习惯;Jev做的三件事单拎出来都不算发明,新的是工程整合:第一,把散在"Yes"、" yes"、"Y"一堆token上的概率,收成你调用时用自然语言现场定义的选项集——不用为每道题攒数据集训模型。第二,用RLCD(面向校准决策的强化学习)专门训练"把握"本身,让模型说的90%真的接近十次对九次。第三,多问题并行,同一段状态编码一遍,挂十几个短尾巴一起问,多问一题边际成本接近零。36氪
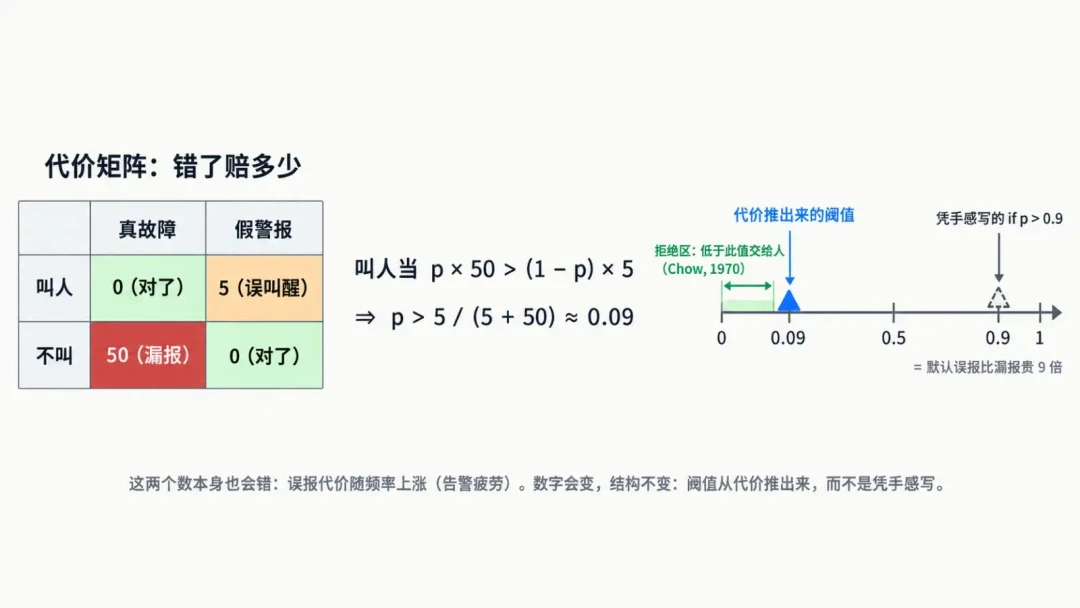
卡尼曼《思考,快与慢》的系统1(快、直觉、不解释)是它的命名来源,也是产品逻辑:置信度大于0.90自动执行,0.70到0.90之间交给更强的大模型复核,低于0.70直接摇真人。这套"快慢分工"的路由结构,恰好是过去两年每个认真做Agent的团队都在手搓的东西——Jev等于把胶水层做成了产品。36氪
所以更准确的说法是:幻觉不会消失,但"可路由的不确定性"第一次变成了一等公民。对自动化管线来说,一个报不准概率的聪明判断,不如一个报得准概率的快速判断。
第三层账:能不能进你的管线,看切片,别看发布会
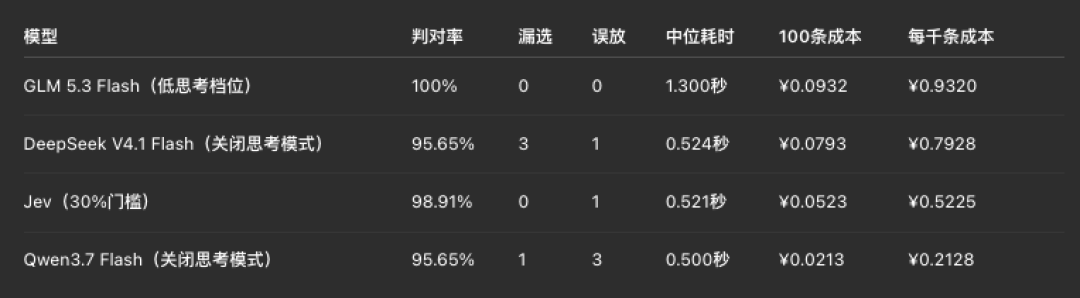
争议也要如实记录:TypeSafe至今不跑公开benchmark。官方对比图里还有些"作者自己在文档里写了的诚实细节"(比如那张对比图的可比性问题);Jev目前仍在内测,官网申请、Vercel AI SDK首发接入。没有思维链,凡是要多步推导的题,它不如一个带CoT的小模型——这是它的物理天花板。卡兹克那篇流传很广的100题预筛实测也提醒了另一半:他自己的横评里,GLM-5.3 Flash是唯一全对的(但最慢最贵),Qwen 3.7 Flash价格只有Jev的一半,Jev综合排第二(准确性第二+便宜,但国内网络下延迟被拉高)。便宜大碗的国产flash小模型,在"分类路由"这个赛道同样不是吃素的。知乎知乎
按人群给结论:
正在跑高频判断管线的人(日处理几千条预筛、路由、审核):值得现在就试。 成本结构是真实的数量级差异——0.042美元/百万输入、输出免费、毫秒级。先拿预筛开刀:便宜的模型挡掉80%无关内容,贵的模型只处理剩下20%,这是卡兹克实测验证过的正确姿势。
只是订阅ChatGPT/Claude聊天、写代码的人:跟你无关,别为它换任何会员。 Jev不聊天、不生成,它不是来抢你对话框的。
指望它替代现有Structured Outputs方案的人:先别急着拆。 约束解码是免费兜底,小模型分类是平价替代,Jev的溢价在于校准过的置信度和并行多问——这三样现有方案确实给不了,但"准确率反超前沿模型"还没有第三方可复核的证据。
观察清单四条:公开benchmark或可信第三方复测数据何时出来;选项集做大到几十上百个时校准还准不准;内测结束后的正式定价;OpenAI/Anthropic是否在两个月内跟进同类产品——如果机制真是窗户纸,跟进速度就是护城河成色的试金石。
最后说句题外但重要的:Jev这波真正的行业意义,可能不是某个模型变强了,而是它撕开了一个被"AI=聊天框"锁死四年的共识——大模型从一开始是造出来跟人说话的,RLHF服务人,RLVR服务判题器,第三个客户"程序"一直没人认真服务。
给AI装上嘴不是唯一的进化方向,把嘴缝上、额头装一块压力表,也可能是一门大生意。
要不要接,数据都在上面了。至少有一点可以确定:接下来6个月,"决策模型"会是Agent赛道上最拥挤的词之一。