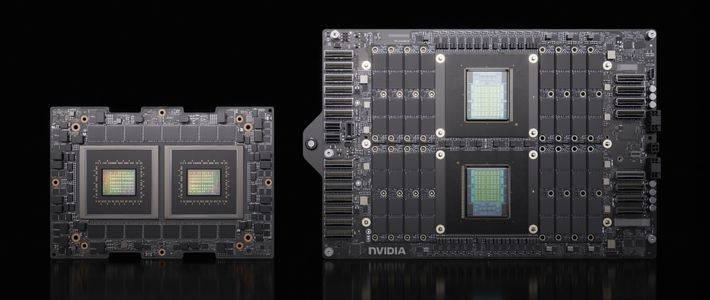
9月21日这一天,知乎上同时冒出了两个新提问:"英伟达GPU包含10-40个RISC-V核心,这对行业意味着什么?“和"英伟达显卡底层揭示数十个RISC-V核心接管驱动执行,对未来显卡架构意味着什么?”
源头是科技媒体XDA对英伟达GPU底层的一次扒皮式分析:你桌上那块RTX显卡,硅片上除了跑CUDA的图形核心,还住着10到40个RISC-V小核心,其中一部分已经实际接管了图形驱动的执行工作。知乎
第一反应的普遍困惑是:英伟达不是封闭的代名词吗?CUDA锁了十几年、驱动代码捂得严严实实——这家最封闭的公司,怎么把芯片的"神经中枢"押在了全世界最开放的指令集上?
先别急着下结论。把公开信息摊开,这件事对N卡玩家、AI开发者、蹲国产替代的人,是三笔完全不同的账。
第一笔账:这块"卡内小电脑",其实你已经用了8年
GSP(GPU System Processor)不是新东西。按知乎回答里引用的XDA分析,这套架构从图灵时代(2018年)就开始存在,只是英伟达从来没在发布会上讲过。知乎
它干什么?过去,显卡的硬件调度、驱动指令翻译,大部分压在系统CPU上——占CPU资源、还引入延迟。GSP的思路是:干脆在GPU内部放一颗专门的"片上小处理器",把这部分活接过去,指令的实时调度与管理在显卡内部就地完成。
XDA这次披露的新细节是"里面住的到底是什么":
每块GPU内含10-40个RISC-V核心,不是统一规格,而是分档定制;
简单的控制逻辑用NV-RISCV32,重载管理任务用支持乱序执行的NV-RISCV64;
这些核心跑着高度封闭、加密的固件,给显卡建立了一个独立的硬件信任根——恶意驱动想从底层通道侵入GPU,这条路被从硬件层面堵死。知乎
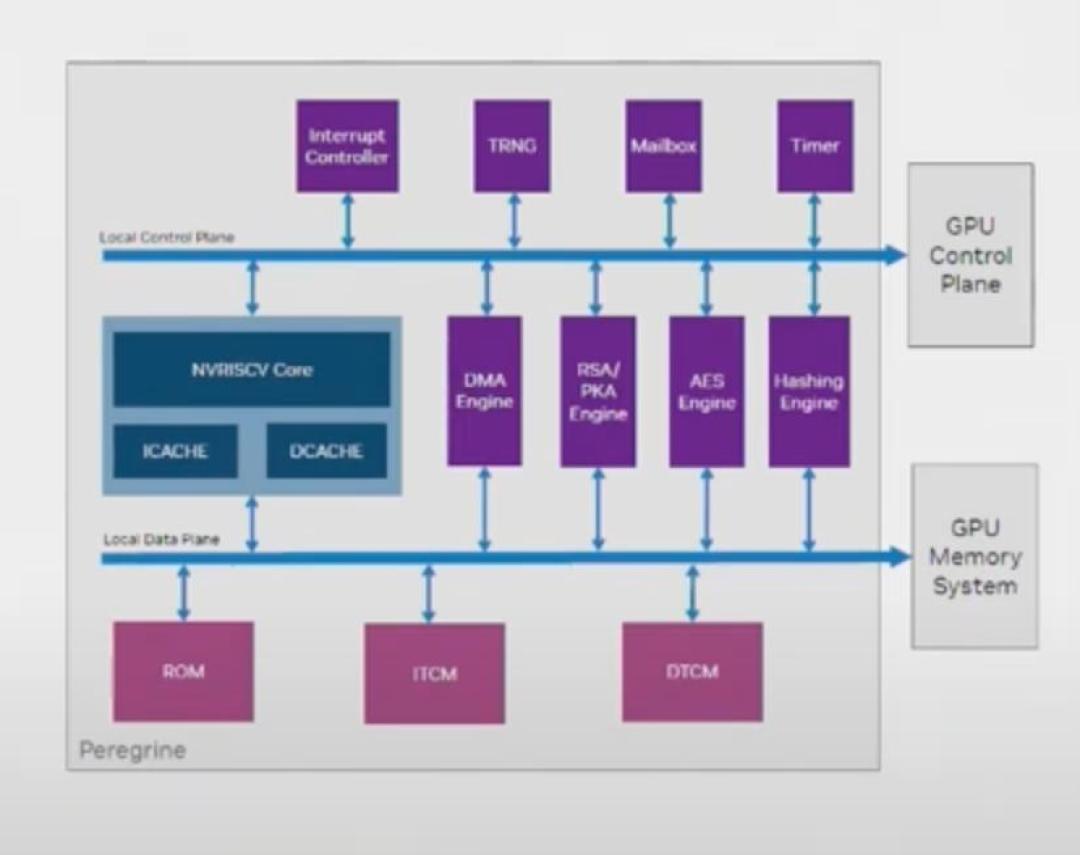
换句话说,英伟达的GPU早就不是"一颗大核+一堆流处理器",而是一个你看不见的SoC:图形核心负责算,RISC-V集群负责管。

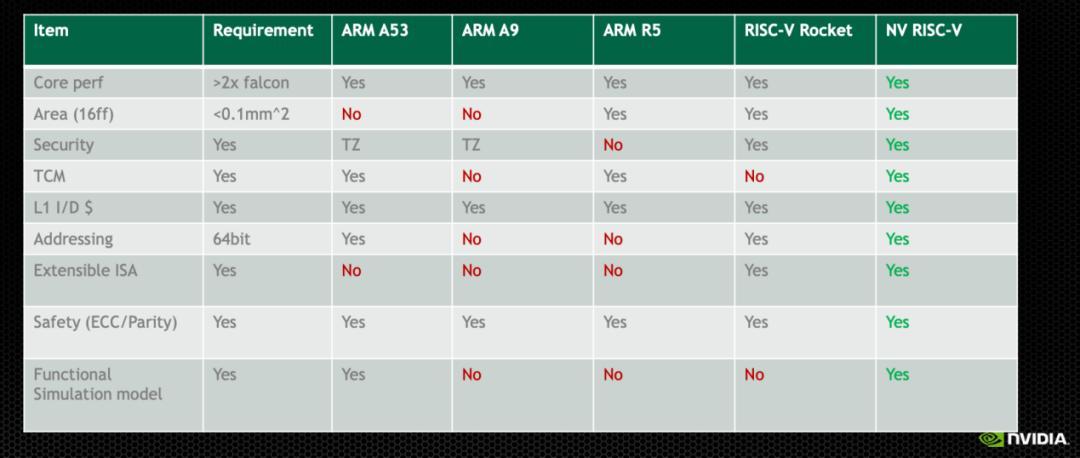
为什么选RISC-V而不是ARM?这个问题圈子里吵了很多年,答案其实不浪漫:管理核心不跑生态,跑的是固件——ARM授权按核计费、定制受限,而控制面要的恰恰是按自己的需求随便改的核。看看同赛道的邻居就明白了:知乎芯片话题下一个被引用的梳理很直白——Tenstorrent的Tensix阵列用RISC-V核做控制、Meta的MTIA一代用晶心核、昇腾的控制面同样有RISC-V的身影,“RISC-V是控制面标配,只是营销物料里不写”。英伟达只是把这件事做到了最大:有统计口径估计,英伟达2024年的RISC-V核心出货量已经到了十亿颗级别——全球最大的RISC-V"用户"之一,恰好是卖封闭生态起家的那家。知乎知乎
第二笔账:真正的重头戏不是卡内,是CUDA开始瞄准RISC-V主机
如果故事只停在"管理核用RISC-V",那只是个工程八卦。8月下旬英伟达的一场技术分享(半导体产业纵横做了详细转述),才把这事的战略意图摊开:CUDA目前只支持x86-64和aarch64两种CPU,英伟达正在把它扩展到RISC-V主机上。半导体产业纵横
但注意,这个"开放"是带门槛的。英伟达硬件工程副总裁Frans Sijstermans的原话相当直接:"如果没有RVA23,我们根本不会考虑将CUDA移植到RISC-V。"整理一下CUDA给RISC-V开出的条件清单:
CPU必须符合RVA23标准(拒绝碎片化,宁可不要低端市场,也不发"最低公分母"的慢速版本);
遵循RISC-V服务器SoC规范(v1.0),要RAS能力、要专用安全处理器;
ACPI支持——软件要能探测硬件能力、管理功耗和热。这个卡点2025年才由UEFI论坛把规范补完;
PCIe缓存一致性——否则CPU刚写进缓存的数据,GPU的DMA读不到;GPU写回内存的结果,CPU读缓存拿到旧数据。英伟达直接把它当成服务器CPU的标配,不接受软件打补丁;
PCIe端到端直传——两块设备传数据不许绕道CPU内存。

同场的还有NVLink Fusion:第三方可以把英伟达的NVLink IP集成进自家芯片——意味着未来接英伟达GPU的"主机",可以是x86、可以是Arm、也可以是RISC-V。参考形态就是联发科与英伟达协同开发GB10那样的深度合作。目前明确的消息是英伟达正与SiFive合作,SiFive计划在Hot Chips上演示一套能跑CUDA的RISC-V系统——从规格看,是一颗大核数的服务器芯片。半导体产业纵横

这里有个容易被带偏的点,必须先拆掉:这不代表你把一块5090插进RISC-V开发板就能跑CUDA。转述原文说得很清醒——市面上绝大多数现有RISC-V硬件达不到英伟达的条件,短期内消费级硬件几乎不可能全部满足,真出现支持CUDA的RISC-V系统,大概率是服务器,不是爱好者手里的单板机。
那英伟华图什么?一句话:多一个主机CPU的选择权,就少一分对x86和Arm两家供应商的依赖。同时用RVA23这条高门槛反过来给整个RISC-V服务器生态"定规"——开放是开放,但规矩由我来立。
第三笔账:蹲国产替代的人,这周的信号密度确实高
把时间线摆在一起看,会发现这一周RISC-V话题的密度不太寻常:
9月中旬,工信部、发改委发布的"十五五"规划相关文件中,RISC-V首次被写入国家五年规划,原句是"推进第五代精简指令集(RISC-V)研发与产业化,支持RISC-V芯片在人工智能、嵌入式系统等领域应用"——用的词是"推进",不是"探索";
同一周,国内RISC-V赛道出现了近20亿元的最大单笔融资,标的奕行智能投后估值近150亿元,做的正是基于RISC-V的云端AI计算核心;
有知乎回答引用产业统计:国内RISC-V全年产业产值已达约1700亿元,同比增长超过35%;B站科普视频引用的口径更猛:中国RISC-V芯片年出货约30亿颗、占全球一半;
而英伟达这边,Rubin架构的寄存器头文件里已经被发现出现RISC-V相关定义。知乎
热闹是真热闹,但泼冷水的证据也在同一批材料里:知乎上讨论量76万+的话题"RISC-V架构的CPU为什么还没流行起来"下面,高赞抱怨集中在生态碎片——矩阵扩展指令集光提案就有三套;英伟达那份CUDA门槛清单,本质上也是在替整个行业承认:RISC-V的软件配套(ACPI、一致性这些"无聊基础设施")到今天才刚凑齐服务器级的答案。知乎
所以这条线值得跟,但站队姿势要对:控制面和互连层面,RISC-V已经是既成事实,不需要再"证明"什么;主机和计算面,英伟达开出的每一道门槛,都是国产RISC-V服务器要实打实跨过的坎。把"英伟达拥抱RISC-V"直接解读成"RISC-V赢了",属于把两条进度完全不同的线,抄进了同一句话。
跟你有关的部分:三类人各记一个观察信号
存量N卡玩家(尤其折腾驱动、魔改、Linux的老哥):GSP意味着驱动越来越多地"住在卡内固件里"。XDA分析里那句要记住——这些核心用户无法编程,一旦固件被篡改,GPU可能连都开不了。往后显卡的"可折腾边界"(刷VBIOS、非官方驱动、超期旧驱动)只会由这套信任根说了算。你的卡还能不能用第三方方案"白嫖"新功能,取决于英伟达固件松不松口,不取决于社区手速。
AI开发者:留意这条时间线的三个节点——CUDA Rust(GPU内核侧,已经官宣)、CUDA on RISC-V主机(工具链何时正式支持)、SiFive Hot Chips演示的后续量产消息。英伟达软件栈"半开半闭"的节奏,比任何一条单独的利好都值得收藏跟踪。
盯国产链的投资向读者:政策文件(十五五)、产业融资(奕行智能)、出货统计三个信号已经密集落地,下一个要盯的是英伟达划的RVA23门槛有没有中国厂商跟进达标——这决定这波是叙事还是订单。知乎
英伟达这周没开发布会、没发涨价函,却在芯片的"看不见的楼层"里被扒出了自己的底牌。过去我们比较显卡,比的是流处理器、显存、帧数;接下来真正拉开差距的,可能是那10到40个从来不写进参数表的核。
参数表之外的东西开始决定参数表之内的东西——这才是"显卡全面SoC化"真正的起点。














