这个9月,想入坑本地部署AI的人,最先撞上的不是模型,是显卡价格。
RTX 5060 Ti被渠道炒到6000元上下,DGX Spark现货被炒到3万3。 知乎上"内存显卡什么时候回归正常价格"的问题拿到了580个赞,高赞回答的结论很冷静:最少还要再等2年。 买卡的逻辑也变了——二手市场里流行一句话:"先不问性能,先问显存。"8G嫌小,10G起步,12G看着才安心。知乎知乎知乎
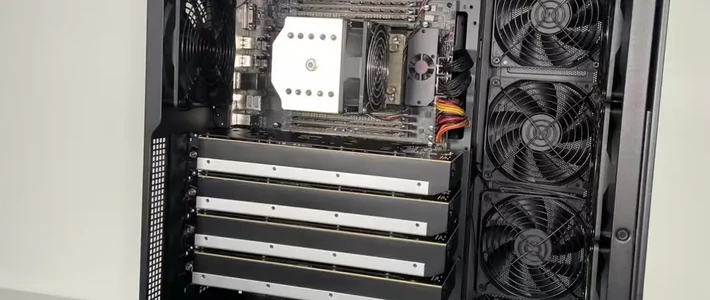
就在这个背景下,小红书9月7日的一篇帖子火了一把:博主"极客老猫"晒出一台自制开放式机架——8张RTX 2070分层"住楼房",总显存64G,跑Qwen3.8-27B的Q6_K_M量化版,上下文拉到200K,开了tensor和MTP,生成速度30 token/秒。 374赞、251条评论、225次收藏。评论区第一热评拿了109个赞,只有一句话:“以前,这个东西叫矿机架。”小红书
矿潮记忆瞬间被激活。但这一次,显卡下面插的不是矿盘,是大模型。

一台"新矿机"的真实账单
评论区问得最实际的问题是:"8张卡得多少钱?"楼下的回答很干脆:9600元。小红书
单张2070在这个行情里大约1200元——作为参照,二手市场一张2060 12G现在也要1200元左右,比低点涨了约20%。8张2070凑出64G显存,加上一张"非服务器主板、8个以上PCIe"的板子(评论区猜是矿潮遗产X99或者B85),电源、内存、自制架子,整机投入大概率压在1.5万以内。这个数字什么概念:一张阉割版5090的价钱(3.5万起步),够你搭两台还有找零;一张5060 Ti的钱,够买5张2070,总显存40G对16G。知乎
这就是垃圾佬路线的核心逻辑:用捡垃圾的心态选型,不用追求性能的心态。这是那条帖子评论区里的原话。单张2070的性能今天看已经很弱,但推理这件事和游戏不一样——游戏要单卡快,推理要显存装得下。64G总显存意味着200K上下文随便拉,而这正是24G新卡最痛的地方。
当然评论区也没客气。有人质疑"你这个30t/s,等上下文跑到100K的时候,有5t/s就不错了",作者的回复是"上下文到了200K也还能有28,总显存足够大"。还有人直接泼冷水:如果不是个人兴趣,其实买token比电费便宜。 这条下面有人接了一句很关键的:肯定,但有些东西在线的就是做不了。小红书
这两句对话,基本就是2026年9月"要不要本地部署"这个争论的最短版本。
电费已经打平了token,没打平的是硬件
知乎上那个108万播放的问题——“本地部署一个大模型,就实现token自由了,真的吗”——博主翔宇情9月8日的回答给了目前最完整的一笔账:
消费级本地部署的可用线,现在刚好跨过去。他的判断是Qwen3.8 Flash-Next(177B,跟27B不是一回事,是旗舰)差不多是国产大模型第五名左右的水平,能稳赢它的只有Kimi K3、GLM5.3、Qwen3.8 Max和HY4预览版。知乎
电费已经低于token plan了,而且本地没有API的量化、429限流问题。
但硬件太贵。要跑Flash-Next,得是两台DGX Spark或者一台256G的Mac M5 Ultra,价格都在7-8万;Mac M5 Ultra 256G版本接近十万。
注意这个结论的结构:运行成本已经不是问题,入场费才是。这也是为什么垃圾佬路线突然有了吸引力——它本质上是在用时间和折腾能力,去对冲那个近十万的入场费。8张2070跑不了177B的旗舰,但跑27B足够;而27B是8月14日才开放权重、Apache 2.0可免费商用的模型,256K原生上下文,开源圈等了几个月的东西。小红书
另一位博主"方华Foina回来了"的路线则展示了另一条对冲方式:不买新卡,买二手Mac。他先淘了2023款MacBook Pro M2 Max 96GB和M3 Max 128GB两台机器做对比,结论很残酷——M2 Max 96GB连Flash-Next都加载不了,退而求其次跑27B的Q4量化只有12 token/秒;M3 Max 128GB可以轻松加载,长文加代码压力测试长期稳定在38-40 token/秒,“属于可以正常工作的范围”。最后他留下了128GB那台,整机3万多,还顺手点破了选机逻辑:本地大模型选机器,不能只看芯片新不新、GPU核心多不多——内存装不装得下、实际能跑多少token每秒,才是最重要的。小红书

统一内存的Mac路线和垃圾佬多卡路线,其实是同一道题的两个解法:都在凑显存/内存容量,一个靠二手显卡堆量,一个靠苹果的统一内存溢价。区别是Mac安静、省电、能当主力机,多卡方案吵、费电、只配待在角落里当"矿机"。
四条路,四本账
把9月社区里能看到的真实方案摆在一起,大概是这样一个光谱(价格为发帖时的行情价,浮动很快,仅供参考):
路线一:垃圾佬多卡。8×2070约9600元(整机1.5万内),64G显存,27B量化版30t/s,200K上下文。适合有矿潮记忆、会验卡、能接受开放式机架和电表转速的人。风险写在脸面上:矿卡寿命是赌的,2080 Ti那种"完整经历过矿潮"的卡,二手1500元,性能至今能打,但本质是赌寿命。 主板是另一个坑,非服务器主板要8个以上PCIe,可选的都是矿潮遗产,供应量说没就没。知乎
路线二:一张新卡硬扛。5090 24G三万五起步,5060 Ti被炒到6000。单卡的问题是显存天花板:16G的卡跑27B的UD-IQ4-XS量化版(13.3GB),实测18t/s,属于个人能用的水平。小红书

12G的4070跑Qwen-Image 2.1生图,40步约200秒一张。适合游戏和AI两用的人,纯为AI买新卡,9月这个节点性价比很差。小红书
路线三:二手Mac统一内存。3万级二手M3 Max 128GB,Flash-Next 38-40t/s。安静、省电、数据不出机器,96GB和128GB之间隔着一道"能不能加载旗舰模型"的硬门槛,预算卡在中间最难受。适合真正要拿本地模型干活、处理公司数据和技术资料的人。
路线四:不部署,买token。评论区那位说得最透:内部有24小时不间断服务、对模型质量要求不高的,内网自己部署保证数据不出网;外网需求直接买token,国内国外服务都买。翔宇情的账也支持这个——电费比token便宜了,但那是建立在硬件已经买完的前提下,把折旧算进去,他的结论还是有点不值得的。知乎
三个坑和一个时间点
坑一:显存是门票,不是性能。二手市场现在"先问显存"的风气里藏着最容易踩的雷:12G装在3060上,它也不会变成4070。为AI买卡,显存决定你能不能上场,算力决定你跑多快,两个都要看。

坑二:标称速度都是短上下文速度。30t/s的测试条件如果是几K上下文,别急着套用到自己的场景。长上下文掉速是普遍规律,买卡前先找同方案的实测,或者看作者敢不敢回评论区晒200K上下文的速度。
坑三:矿卡验机。这条路线的省钱建立在"你懂硬件、会验卡、能接受维修风险"上。不满足任何一条,就别碰10系20系的老卡,那是别人的快乐。
时间点上还有一个变量值得等一等:RTX Spark笔记本已经官宣10月8日登场,本体盒子也在发货周期里。上一轮报道里我们说过,这类新品的定价会直接冲击"二手卡+自制机架"这套方案的性价比——如果不急,让它先发布,看看首发价和实测速度再决定走哪条路,成本是零。
最后说回那台"楼房矿机"。它真正的意义可能不是性价比,而是评论区的另一条高赞回复说的事:内部数据不出外网的需求是真实存在的,外网买token、内网自己部署,会是越来越多小团队的标准姿势。8张2070只是这个需求在涨价周期里,被逼出来的一个极具时代特色的解法——上一轮矿潮,这些卡用来挖别人发的币;这一轮,至少挖的是自己的token。









校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案