跑长上下文推理服务的人,多半动过同一个念头:把KV cache offload到远端,让多个引擎共享前缀缓存,TTFT不就下来了?LMCache、Mooncake、HiCache的官方案例都在说这件事。但10月17日挂出的这篇生产事故论文(arXiv 2610.21500),正面挑战了这个共识:给vLLM接上共享远端KV缓存(LMCache+Valkey)后,中位TTFT毫无变化,16k长prompt的p99却从3.96秒飙到17.3秒,上线当天就被回滚。知乎
这篇论文值得每个正在考虑给vLLM接L2(远端KV层)的人仔细看:作者没有停在"网络慢"这种一句话诊断上,而是重建了生产引擎的原始请求流,从路由日志和压测客户端数据库还原出该引擎在16k档SLA负载下收到的683条请求及其原始prompt与发送时间,在完全一致的配置下回放(vLLM 0.31.0、LMCache 0.5.5、FlashInfer 0.7.0、NCCL 2.30、CUDA 13.0,GLM-5.3 FP8跑在8卡B300上,prefill按PCP8上下文并行),最后给出一个只有两项的成本模型。先看事故本尊——逐请求prefill延迟,中位带(绿/灰/蓝亚秒区)没动,接了远端缓存的那组(红点)尾巴直接炸到上百秒:知乎

模型结论相当反直觉:
一、不是网络慢,是GPU太快
一次远端命中能不能赢过重算,取决于一道生死线:缓存层给单个prompt交付的带宽B,必须跑赢本机prefill的重算需求 s·R。其中s是每token的KV字节数,R是引擎prefill速率。对GLM-5.3 FP8+B300这组配置:s=48.4 KB/token,R=52.2k token/s,阈值算出来就是B*≈2.53 GB/s。注意prompt长度在这道不等式里被约掉了——阈值只取决于模型的KV体积和硬件的prefill速度。知乎
而他们的L2通路(单个Valkey实例服务8个PCP rank)实测最好只交付1.71 GB/s,低于2.53。在这种带宽下,每一次L2命中都比重算更慢:一条16k token的prompt,重算只要0.31秒,从L2加载要0.88秒。B300 prefill太快,缓存层根本喂不过重算的速度。
更麻烦的是还有一个不随带宽缩小的固定成本T₀≈0.33秒——调度、查询往返、未缓存尾token的一次前向、每chunk的元数据交换与广播。命中要划算需要 n>R·T₀,代入R=52.2k算出阈值约17k token:这套硬件和实现上,16k及以下的prompt无论带宽多高,用L2都不可能改善中位延迟。模型对16k命中的预测0.79秒,和实测0.83–0.88秒也对得上。

二、尾巴炸开的三个连锁细节
带宽不足只是第一层。事故里真正让p99失控的,是三个叠加的实现问题:
rank-0单写者。AllGather之后每个rank都持有完整KV,但存储全压在rank 0:一次约20万token的双prompt追踪里,rank 0往主机内存写了19.1GB、忙碌度82%,其余7个rank 98%在忙——每个rank在9.5秒窗口里累积约1.55秒的AllGather等待。
step内同步加载。加载发生在引擎step内部,PCP锁步语义下一次慢加载卡住全部8个rank,引擎退化成一个单服务器排队系统。按ρ=λns/B估算,hit-heavy回放里λ=1.21请求/s、中位KV量约0.79GB、实测带宽0.78–0.89 GB/s,ρ≈1.13>1:队列没有稳态,中位延迟从3.52秒一路涨到52.30秒,引擎里一度同时挂着59条请求——而GPU利用率只有7%。知乎
三个客户端bug,都会让GPU时间线整段空掉。
下图是同场景下引擎内运行/等待请求数的对照:单实例同步那组(红线)一路膨胀直到跑完,修好的配置(蓝/绿)全程不超过1条:

一个"缓存加速"方案跑到最后,卡几乎全在发呆。这就是KV cache offload最危险的地方:它慢的时候不是线性变差,而是把整个引擎变成排队系统。
三、修完之后:中位仍然没赢,但问题问错了
作者给出的解法全部已提交LMCache上游(分片存储#5545、按rank的远端URL#5548、分片异步加载#5553,外加三个客户端修复):按 chunk c归rank (c mod 8) 独占所有权,一rank一Valkey实例(客户端只改一处URL:`resp://valkey-{rank}:6379`),聚合带宽从1.71升到10.76 GB/s(6.3倍),而单实例从1个客户端加到8个只提升13%——瓶颈从来在服务线程。再补异步加载后,hit-heavy流p99从83.32秒降到0.67秒,124倍。知乎

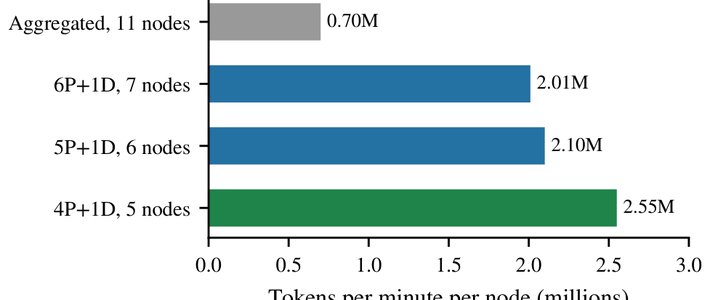
但要看清一个容易被标题党掉的数字:修完之后,中位延迟仍比重算慢0.09秒——其中传输只占0.074秒,剩下全是T₀。作者说得很直白:即使带宽无限大,一次16k命中也要约0.33秒,略高于重算,在快GPU上中位赢不了重算。L2的价值在尾部(p99 0.67秒对重算的1.28秒)和"命中不消耗GPU算力"。顺带这一回放还揪出第二个无关瓶颈:FlashInfer的SwiGLU+FP8融合kernel占17%的prefill GPU时间,一个上游重写把它从1.57ms压到0.23ms。两个修复合起来把prefill吞吐+34%(58k token/s),距"完全关掉LMCache"只差4–5%。最终4P+1D部署通过20万token的SLA(P90<70s),每节点每分钟2.55M token。知乎
四、为什么Kimi和LMCache的漂亮数字也是真的
社区里另一批证据明显站在对面:Mooncake与SGLang HiCache整合后实现全局KV缓存共享,在真实企业场景下报出84%的TTFT下降。LMCache官方博客的GKE分层存储基准测试更具体:10万Token共享上下文下TTFT降低79%、吞吐量提升264%,8卡共享缓存把TTFT从3.98s压到0.29s。拿这篇论文的模型去照,两边其实不打架:知乎哔哩哔哩
Mooncake走的是RDMA专用传输、生产环境是8张网卡聚合加自研传输引擎,交付带宽远超2.53 GB/s这道线。论文的事故通路则是Valkey单实例RESP、卡在单服务线程上——通路不同,结论相反。知乎
LMCache自己也标了适用边界:工作集低于25-30万Token时,额外缓存层反而带来10%-17%的性能损耗,需根据显存压力决策。漂亮数字是拿"超长共享前缀+够快的传输通路"换的,不是无条件开关。哔哩哔哩
LMCache官方对多级KV层的表述也是这个结构——GPU、主机内存、本地盘、远端后端四层,数据在层间移动,官方图里那句注释几乎就是这篇论文的注脚:retrieving beats recomputing only sometimes(检索赢过重算只是有时成立):

一旦换成TCP单实例+中短prompt,同样的"远端KV缓存"立刻翻车。所以"远端KV cache到底值不值"根本没有全局答案,只有你自己机房的答案。
五、开L2之前,先量两个数、问三个问题
两个数(都是你自己引擎上的实测,不是官网PPT):
R:本机prefill速率。用一条长prompt直接测vLLM的prefill token/s;
s:每token KV字节数(MLA类模型按latent维度折算,普通MHA用层数×头维度×2×精度字节数)。
然后实测你的L2通路对单个prompt的交付带宽B,做两道比较:B>s·R才允许开,命中prompt长度n>R·T₀才有中位收益。B300的例子告诉你这道线可以到2.53 GB/s——TCP+单实例的默认部署大概率过不了。
三个问题:
你要的是p99还是中位?快GPU上远端命中中位基本赢不了重算,别拿中位KPI给L2记功;
你要的是"更快"还是"把算力换回来"?命中不消耗GPU,吞吐受限的集群即使延迟打平也值得开——论文最终形态正是靠这一点过SLA的;
你的并行拓扑会不会把慢加载放大成全局排队?TP/PCP下rank-0单写者和step内同步加载这两个坑,比带宽更致命。
继续观察的信号:LMCache那批PR(#5545/#5548/#5553)合入和后续版本行为;vLLM KV connector生态里按rank分片的实例化配置会不会变成默认;以及FlashInfer SM103系kernel修复扩散到其他模型栈的速度。这三件事决定的是:下一次你再开L2,还需要不需要自己动手改一遍。












