全网对百度的舆论,两个词绕不开:“广告”、“起个大早赶个晚集”。9月底一条"大家现在还用百度吗"的热帖下,高赞回答基本指向同一个替代品:AI。但就在10月27日,百度又拿了个全球第一:文心Unlimited OCR2正式发布并开源,仓库采用MIT协议,免费商用。微博微博新智元哔哩哔哩42号电波
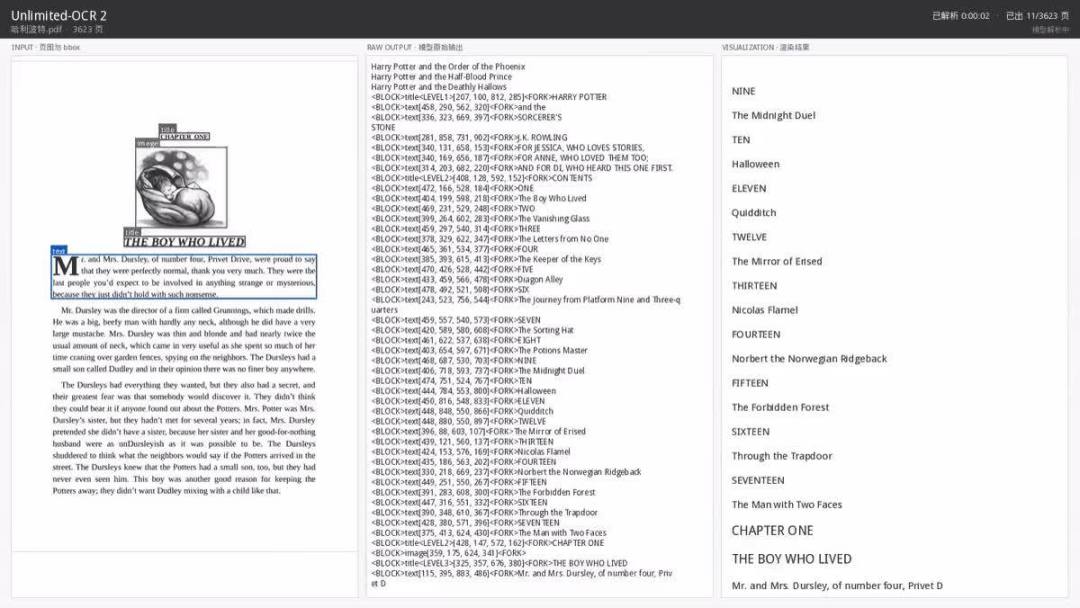
官方演示:7本《哈利·波特》,一次喂进去
整套全部啃完,掐表一看1个半小时,平均翻一页只要1.5秒左右,3623页翻了3000多次,一次也没"断片"——上一代的极限还卡在40多页,120天后,页数上限直接没了。新智元
为什么它能啃厚书?
文档越长,模型要参考的前文越多,推理延迟与显存占用一路走高,这是长文档解析的常见痛点。OCR2的解法叫SR-SWA(稀疏参考滑动窗口注意力):模型只看当前页、挑少量相关页、结合最近文字——像人翻页一样读书,不用的就扔掉。42号电波哔哩哔哩
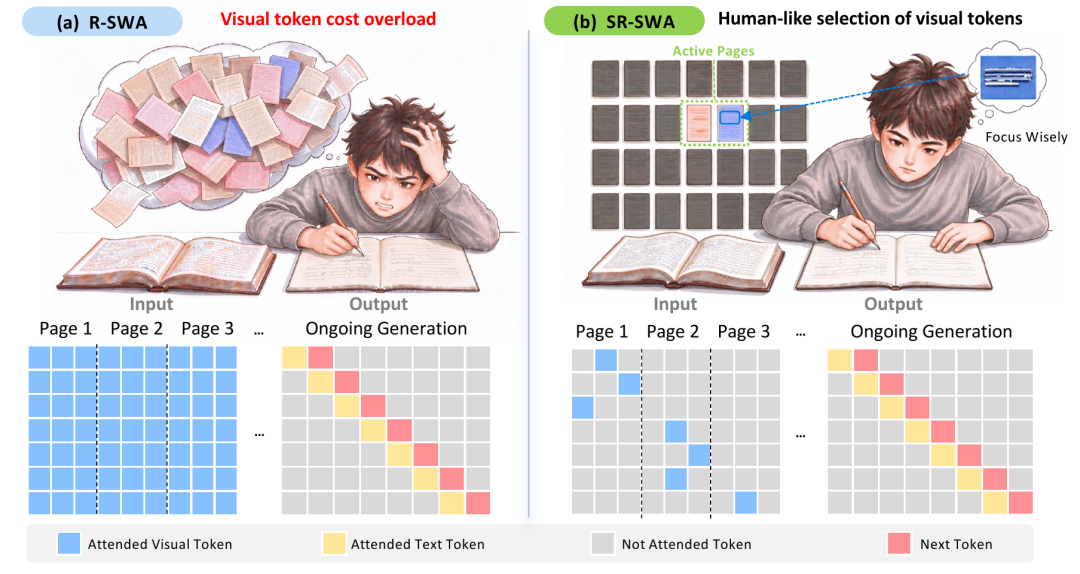
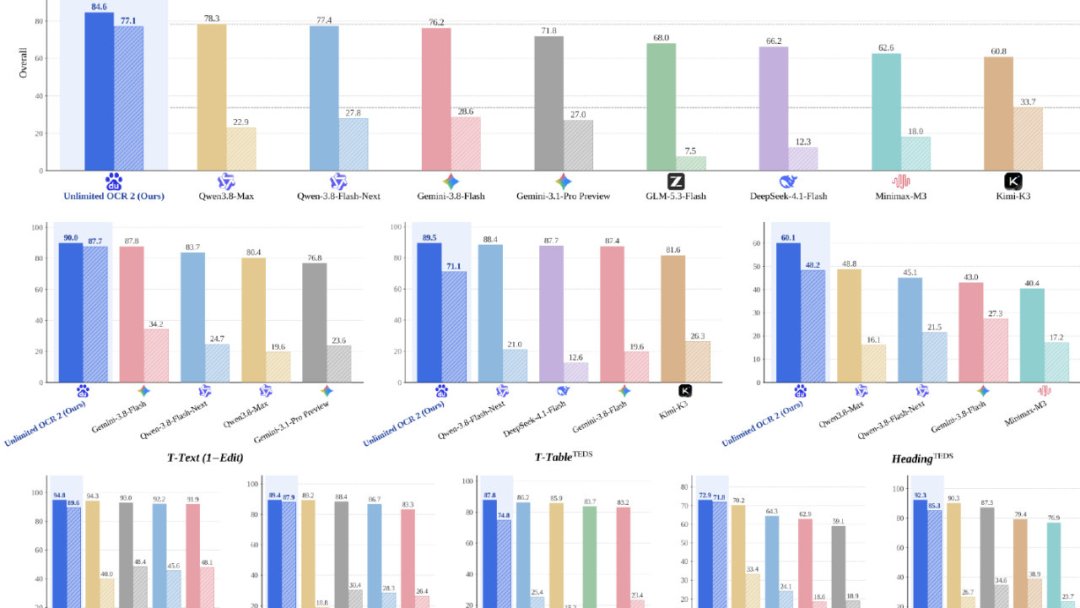
数字很直观:单序列推理的峰值KV缓存从47.00GB降到了1.77GB。砍掉96.2%之后,一张普通游戏显卡就能跑满全场。16路并发吞吐量从360提到1315 TPS,约3.65倍。评测是两张卷子:几十页级的MPDocBench和百页级的MarathonDocBench,仅3B参数的它拿了84.6分,压过一众商业大模型,百页卷领先第二名43.3分、断层第一。而它的上一代,是被LeCun转发推荐、狂揽1000万下载的初代"神作",这代是它的四个月迭代款。冰码达GitHub鲲鹏Talk新智元
对你有什么用?
合同、发票、PDF提取和企业知识库建设,就是这套方案瞄准的场景。普通人的用法大概是这些:鲲鹏Talk
手头的合同、标书、几百页的PDF,整本转成可检索文本,不用再"每50页切一次再拼回去"。新智元
扫描书稿、论文批量转文字,直接输出结构化JSON,表格和文字都能用。
老照片、试卷、家用票据的数字化,也是高频场景。
但丑话说在前面
B站UP主上强度实测:1001页跑了46分10秒,平均每页2.77秒全程不掉速,319处该续接的地方一处没漏——但"长得像又不该合并的表格,被缝成了一张"。官方技术报告也自己承认:稀疏注意力没有保留全局文档信息,对标题层级等文档整体结构的理解仍受限制——表头在上一页、金额续在下一页时,得到的可能是一张"格式完全正常、内容已经错位"的表。小天fotos冰码达
另外别上头:多页PDF以前就能处理,PaddleOCR等工具早已有相应能力,没必要为这次更新专门换刀。至于能省多少服务器钱,得拿自己的文档实测,别拿显存降幅直接换算。冰码达
最后说句公道话
评论区风向很有意思:连常年骂百度的人都留下一句"百度的OCR技术真的是全球第一,但他们也就只剩OCR了"。"起个大早赶个晚集"或许是百度的命,但至少在开源OCR这条线上,这套四个月一迭代的作业是真材实料。手上正好有一堆厚文档要啃的,值得拉下来试试——反正免费,显卡够就行。小天fotos