Qwen3-VL作为视觉语言模型,其实现细节对开发者至关重要。本文深入源码,剖析其图像处理、图文融合及自研视觉编码器的设计,帮助理解多模态模型的工作原理。
 智能速览
Qwen3-VL复用Qwen2-VL的处理器进行图像预处理。
模型通过`masked_scatter`操作将图像特征嵌入文本序列。
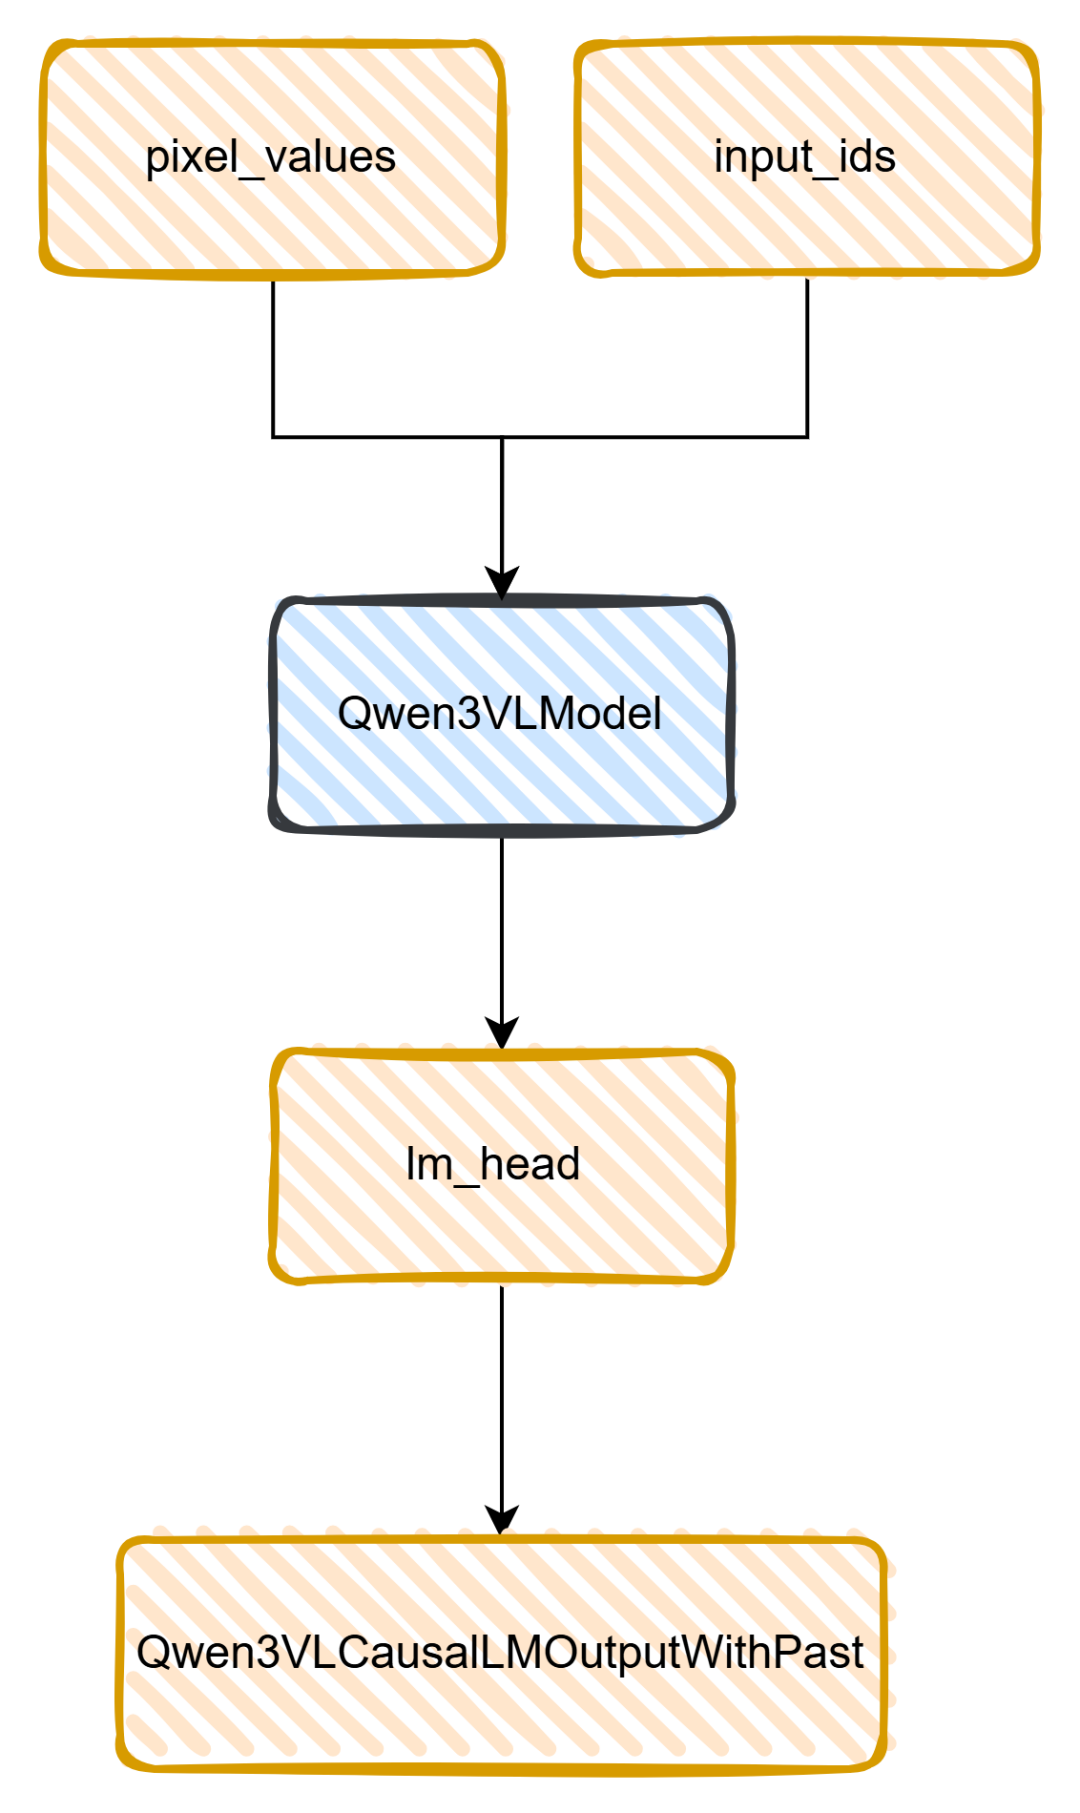
核心模型类`Qwen3VLModel`负责图文特征的融合处理。
视觉编码器为自研实现,包含27层Attention模块。
模型入口类`Qwen3VLForConditionalGeneration`统一处理输入输出。
 精华内容
要真正理解Qwen3-VL的工作方式,必须深入其源码。本文将剖析其核心组件,揭示图像与文本如何被协同处理,以及其独特的视觉编码器设计。
图像预处理流程
在将图像输入模型前,需经过`Qwen3VLProcessor`的精细处理。该类复用了Qwen2-VL的图像处理器,首先将图像按尺寸分组,然后进行智能缩放以适应不同分辨率,保证图像信息不丢失。随后,对图像像素值进行重新缩放和归一化处理,使其符合模型输入标准。最终,图像被分割成小块并展平,转换为`pixel_values`张量,作为视觉特征的原始输入。这个过程为后续的模型推理准备好了标准化的视觉数据。
图文特征融合机制
`Qwen3VLModel`是多模态模型的核心,负责将视觉和语言信息统一。文本输入`input_ids`通过嵌入层转换为`inputs_embeds`。同时,图像数据`pixel_values`经过视觉编码器提取为`image_embeds`。关键步骤在于`masked_scatter`操作,它将`image_embeds`精确地嵌入到`inputs_embeds`序列中由特定视觉占位符标记的位置,从而生成一个融合了图文信息的统一嵌入序列。这个序列随后被送入语言模型进行后续处理,实现了图文信息的无缝对接。
自研视觉编码器揭秘
与采用CLIP或SigLIP等现成方案不同,Qwen3-VL设计了自研的视觉编码器`Qwen3VLVisionModel`。该编码器首先通过一个3D卷积层`Qwen3VLVisionPatchEmbed`将图像分块并映射到高维空间,形成初始的`hidden_states`。接着,融入位置编码信息,然后送入一个由27个`Qwen3VLVisionBlock`模块组成的深度网络。每个Block本质上是一个Attention模块,负责捕捉图像的局部和全局特征。最后,通过一个`merger`层对特征进行整合与输出,这种定制化的设计保证了模型对视觉信息的高效处理。
通过源码拆解,Qwen3-VL从输入到输出的完整链路得以清晰呈现,尤其是其独特的图文融合和自研视觉编码器设计。这不仅加深了对多模态模型的理解,也为相关研发提供了实践参考。