这两天只要你刷本地部署的内容,很难错过同一个名字:Bonsai2-27B。HuggingFace模型热榜榜首,近三十天下载量190万+。 B站单个测评视频两天1.7万播放,站内搜"Bonsai2 27B"一周冒出三十多条视频。但同一时间线上还有两件事在同时发生:有人发帖说"显卡16G,本地部署大模型干不了活",拿了106条评论。 阿里又放出了Qwen4的预告图。三件事叠在一起,评论区最真实的状态是那句拿了13个赞的话:“qwen3.8 27B,光模型就下载了十来个了,到底哪个好”。哔哩哔哩小红书哔哩哔哩
这篇就把这笔账算清楚:Bonsai2的官方数字哪些能信、8G到16G显卡各自该下哪个版本、以及现在到底要不要等Qwen4。
一、Bonsai2的官方数字,先逐条过一遍
PrismML这次做的事,是把Qwen3.8-27B的权重压成三值(+1、0、−1),每128个权重共享一个FP16缩放系数,再折叠blockwise Hadamard旋转,平均每个权重只占1.76 bit。结果是一个5.93GB的GGUF文件——原版FP16权重约54GB,压了9倍还多。小红书
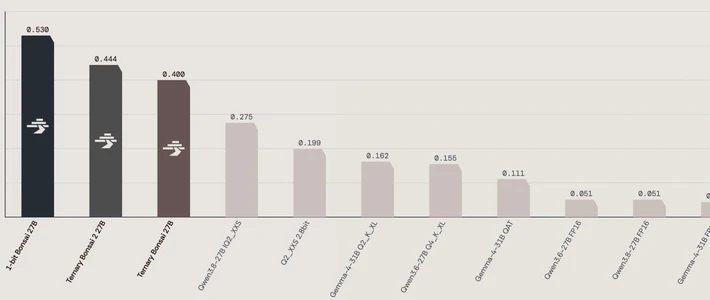
官方口径的成绩单:综合83.9分对原版85.4,保留98.2%(上一代Bonsai约95%);指令跟随102%,反超全精度;六个评测维度里五个保住96%以上。速度方面,RTX 5090跑到每秒143个token,单张3090实测68-70 tok/s,4090的每token能耗比8B全精度模型还省40%。哔哩哔哩
这意味着一件事:8G显存的卡,第一次真正够得着一个当打之年的27B稠密模型。此前社区对Qwen3.8-27B的说法是"最低8GB显存就能跑",但那是勉强装下的口径——标准Q4_K_M量化版本显存占用过高,绝大多数家用12G显卡都无法流畅运行。 Bonsai2把门槛真的打了下来。知乎
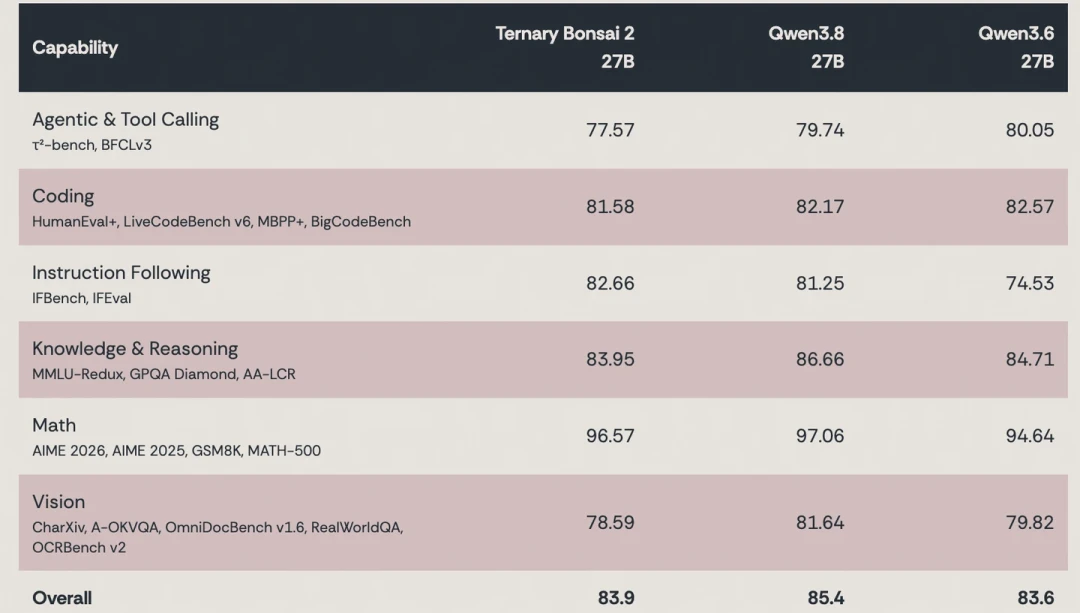
二、98.2%这个数字,先看口径再激动
这是这周吵得最凶的地方。98.2%是学术基准的综合分,不是干活的分数。海外博主RepoChad的实测里,SWE-Bench这类Agent任务的性能下降约25%。 DigitalSpaceport在单张3090上对比,结论是工具调用零失误、基础对话流畅,但复杂任务下的代码可玩性和创意明显弱于FP16原版,“所谓98%性能保留言过其实”。 国内也有UP主冲着98.2%下载,实测之后表示"感觉啥也不是"。哔哩哔哩哔哩哔哩哔哩哔哩
B站评论区的反馈更具体:不思考模式经常截断,思考模式的CoT也截断,查了原因,是模型自己输出停止token。 "雷霆大思考"的老毛病还在——有人用Bonsai2跑一个俄罗斯方块,思考过程吃掉60K上下文。 还有开发者专门为它写了个开源插件,治Agent循环超时死循环,把一个任务的步数从26步压到11步。哔哩哔哩哔哩哔哩哔哩哔哩
也有反方向的证据:有用户实测"代码和推理性能上远胜上一代,没有任何简单bug和逻辑错误"。谨慎派则提醒,二元三元量化对质量保留的挑战太大,BitNet的1.58bit前车之鉴摆在那,“把PrismML这个项目当做科研项目来看比较好”。所以我的判断是:基准分数是真的,但它是单轮问答口径。你的用途是聊天、翻译、总结、轻量工具调用,Bonsai2在8G卡上就是成立的福利;你的用途是重度Agent、长链路写代码,那两成多的折扣会真实砸在你身上。还有一条反证值得记着:同样是8G显存加32G内存的组合,有人认为它被qwen3.6-35B-A3B(MoE架构,激活参数少)“吊起来打”——低显存跑大模型,MoE路线一直是另一条合法出路。哔哩哔哩
三、16G这一档,社区已经有共识答案
如果说8G档吵的是"能不能用",16G档吵的是"哪个最好"。目前社区口碑集中在GSQ-RCO:非均匀混合精度量化方案,先生成候选量化张量,再按张量敏感度和体积预算分配精度,把27B压进12G。 真实用户的数字:5080 16G跑IQ3_XXS档、KV缓存Q4量化,能开190K-230K上下文,峰值67 tok/s、日用平均42。 特斯拉T10这种150W的老卡,配合kvmem-llama.cpp(一个把KV缓存交换到内存的开源项目)跑q8精度、262K上下文,平均27 tok/s;3080 20G能塞下256K上下文,50 tok/s上下。知乎哔哩哔哩
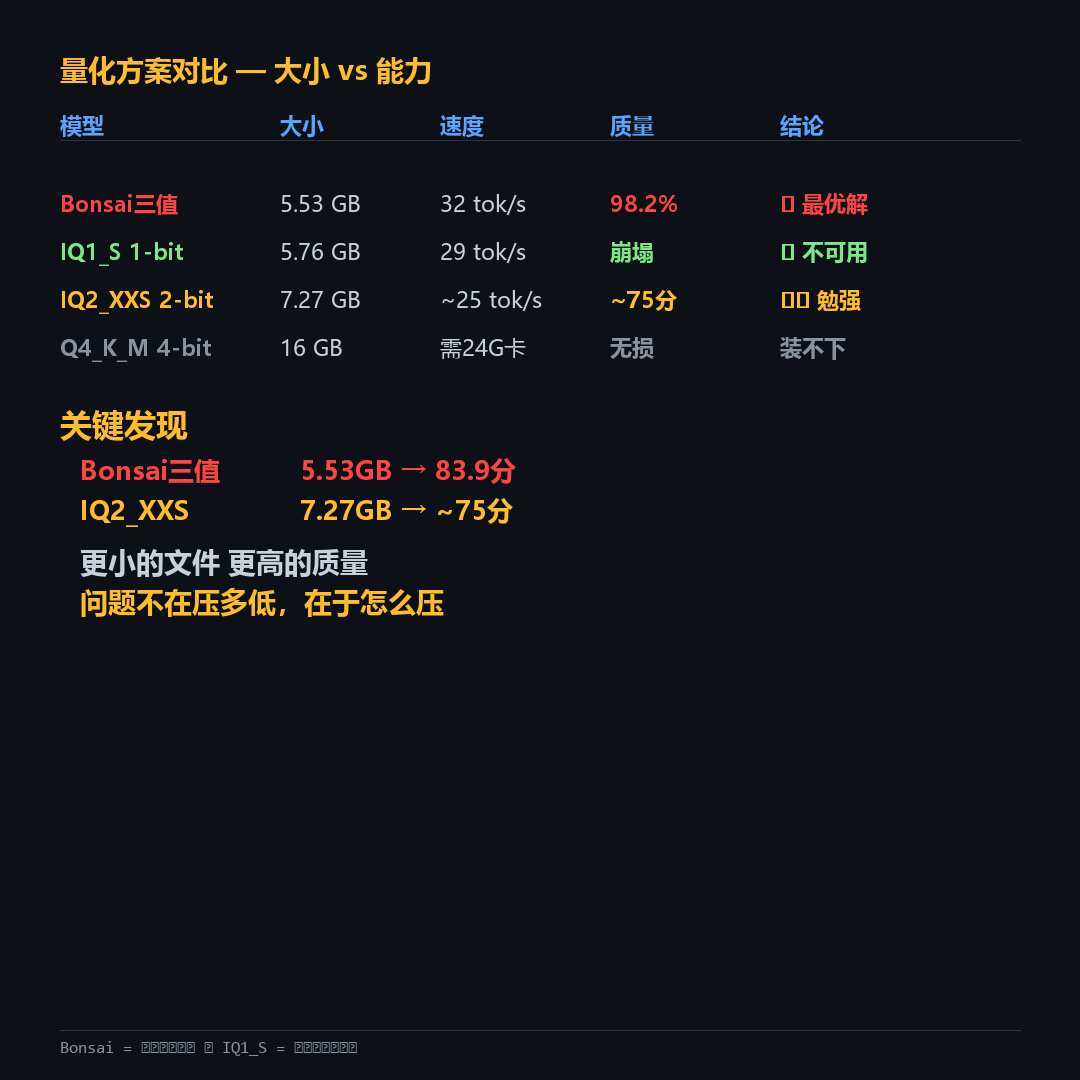
它还有个反直觉特性,一条高赞总结是"越难越强,简单的可能不如q4,上难度能打q8"。当然也有24G显卡用户泼冷水:跟标准q4_k_m比速度更慢、能力反而不如q4_k_m加KV4量化。所以16G档目前的最优解被概括成一句话:GSQ-RCO-IQ3_S-mtp加kvmem-llama.cpp,“16g显存下有大上下文、高速度、高质量,更优的话等qwen4”。哔哩哔哩
不少老玩家干脆双持:一个快、一个好,Bonsai2管速度,GSQ-RCO管质量。
四、按显卡对号入座(截至9月22日)
8G及以下:Bonsai2的5.9G版基本是唯一解。接受Agent场景打折;跑之前先装社区那个防死循环插件;注意GGUF必须用PrismML自己的llama.cpp分支,原版跑不起来。哔哩哔哩
12G:Bonsai2的7.2GB PQ2_0版本实测单轮推理很强;或者GSQ-RCO低档位,12G卡跑出过30 t/s。知乎
16G:GSQ-RCO-IQ3_S-mtp加kvmem-llama.cpp,256K上下文拉满,这套是目前社区公认的甜点。
20G以上(3080 20G/3090/4090):不用折腾极限量化,q4_k_m或q8_0原味直接上,256K上下文基本塞得下。
消费侧多说一句:Qwen3.8-27B这波被叫"模型斩杀线",二手3090的价格已经从人均1950元被抬到2150元。 如果你现在为了跑Bonsai2专门去买卡,冷静——它要的就是你手里那张老卡。真要升级,等Qwen4落地后再出手也不迟。知乎
五、Qwen4,等还是不等
9月22日,官方预告图放出四款:Qwen4-Max、Flash、Plus和27B,状态"Coming Soon"。 评论区的许愿清单很集中:治好3.8的过度思考、恢复3.5时代的语言表达能力、单卡5090跑到200 t/s。也有人担心35B-A3B架构被抛弃,感叹"大模型进入月抛时代"。小红书
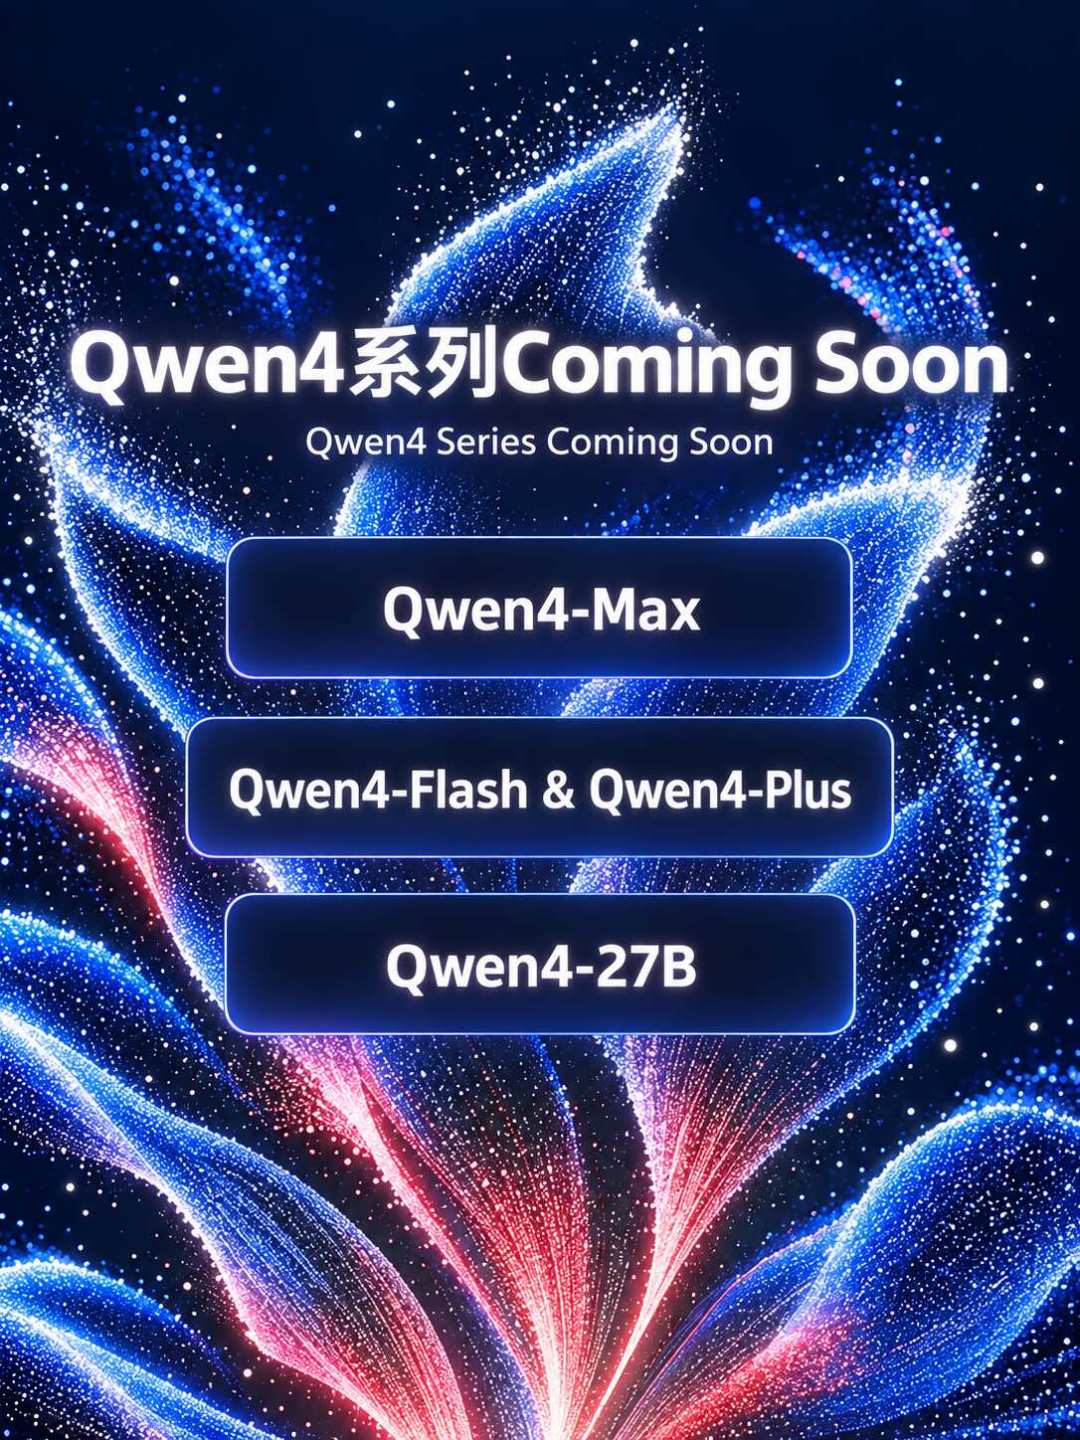
我的建议分两种人:手上已经有8G以上的卡,别等,现在这套27B生态够用,而且Qwen4发布后GGUF和社区量化版至少还要几天到一两周才能跟上;正准备花两千多买二手卡升级的,可以等一等——发布前后的显卡行情和量化适配进度,值这个时间差。
最后留三个继续观察的信号:一是沈三殊的bonsai+ninfer转制方案(4080单路130 t/s、双路并行230 t/s,体积压到6G左右,还在迭代中);二是kvmem-llama.cpp对更多模型的适配;三是Qwen4-27B开放权重后,PrismML几天内会不会跟进三值版——上一代Bonsai(7月,基于Qwen3.6-27B,6.6GB保留约95%)到这一代98.2%,只用了两个月。 这个迭代速度,才是低显存玩家最该盯住的变量。哔哩哔哩