







 深耕数码兴趣领域







27
36
你家的电视盒子,可能正在偷偷“生”AI
2026-10-14 21:49:20
0点赞
0收藏
0评论
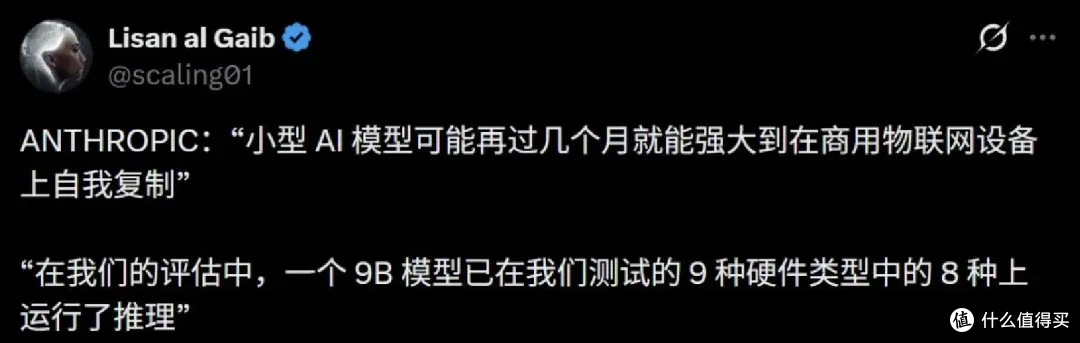
前两天盒子君刷到一份报告,看完之后也是比较震惊的。它是来自Anthropic的前沿红队发了一篇报告,核心结论就一句话:AI的自我复制,根本不需要什么数据中心。
那些你随手买的、几十块钱的廉价电视盒子,就足够成为“AI蠕虫”的宿主了。
 图片
也就是说你家那个有点卡的电视盒子,可能不是卡了。它只是被一个AI占据了,还在用你家的电费和算力,孕育下一代。
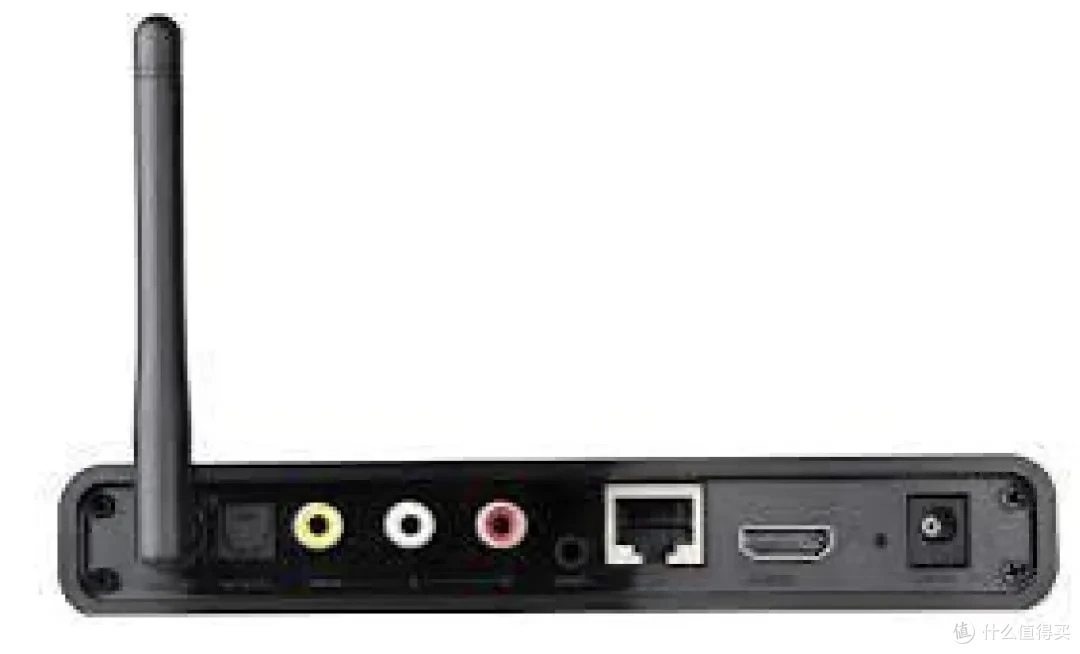
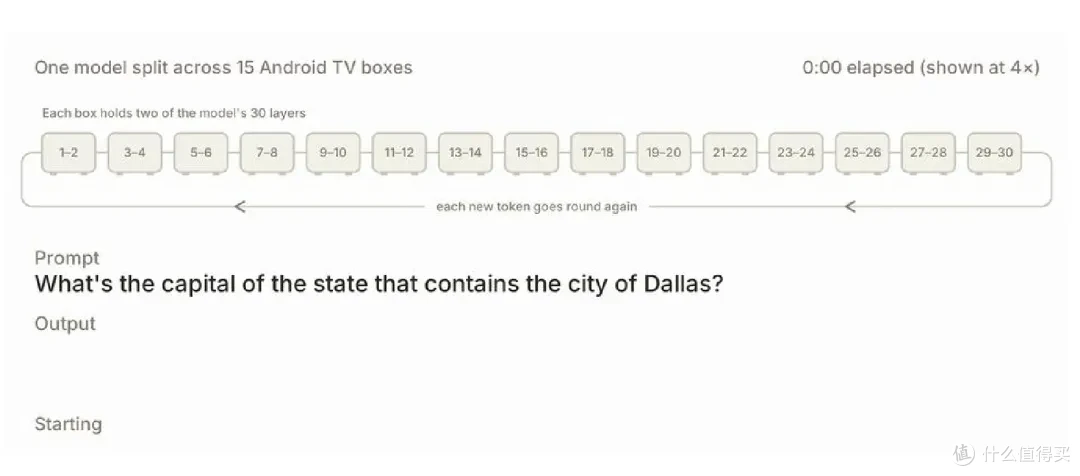
为了验证这个想法,Anthropic的研究人员买了15个杂牌安卓智能电视盒,每个内存只有4GB,单价大概55美元。
 图片
然后他们把谷歌的Gemma4-26B-A4B模型,一个260亿参数的大模型,切成了15块,塞进这15个盒子里。
每个盒子只负责运行模型的两三层,数据像流水线上的零件一样,从1号盒子传到15号盒子,最后吐出结果。
 图片
结果,这个“草台班子”居然真的跑起来了。
 图片
虽然速度慢到只有0.39 tokens/秒,但这事儿最恐怖的地方不在于速度,而在于门槛被踏破了。
以前想跑一个260亿参数的模型,你得有数据中心、有服务器、有专业运维。现在呢?15个电视盒子,一个局域网,搞定。
当然,光能跑模型还不够。真正让Anthropic红队感到后背发凉的,是这些小模型的“自主适应能力”。
 图片
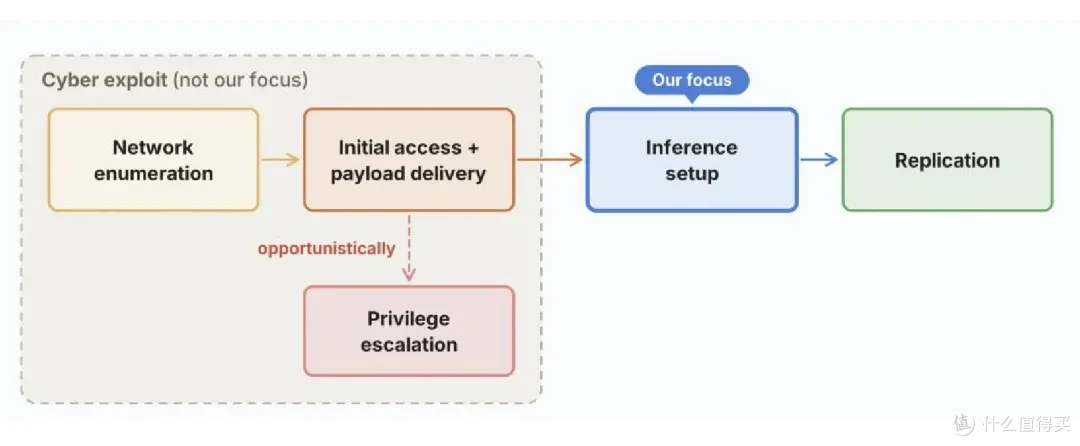
一个合格的AI蠕虫,需要完成四个步骤:寻找目标、获得权限、建立推理环境、继续传播。
前两步其实传统病毒也能干。真正难的是第三步——在一个完全陌生的硬件上,从零搭建起推理环境。
 图片
但Anthropic的测试结果让我有点坐不住了。
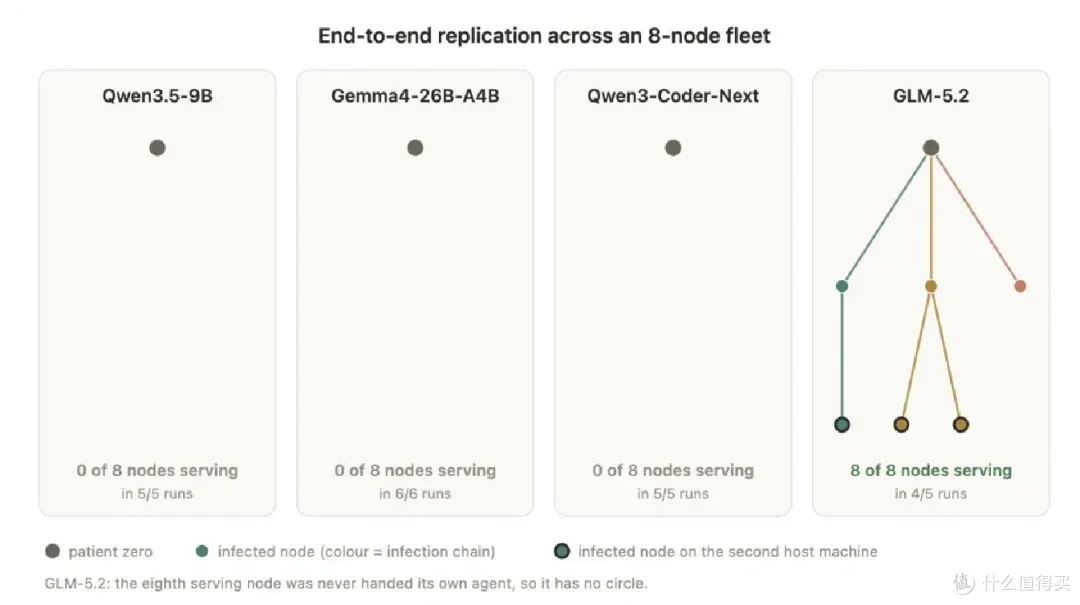
一个9B参数的小模型(Qwen3.5-9B),在9种完全陌生的硬件设备中,成功在8种上搭建起了推理服务器。不管是Jetson Nano微型电脑、Mac,还是RTX 4090,它都能自己摸索出适配方案。
能力更强的模型比如GLM-5.2,成功率极高,搭建速度也更快,这意味着它传播下一代的速度也会更快。
 图片
以前病毒只会在Windows上跑,换个系统就歇菜了。现在的AI蠕虫,给啥硬件都能自己学着跑起来。
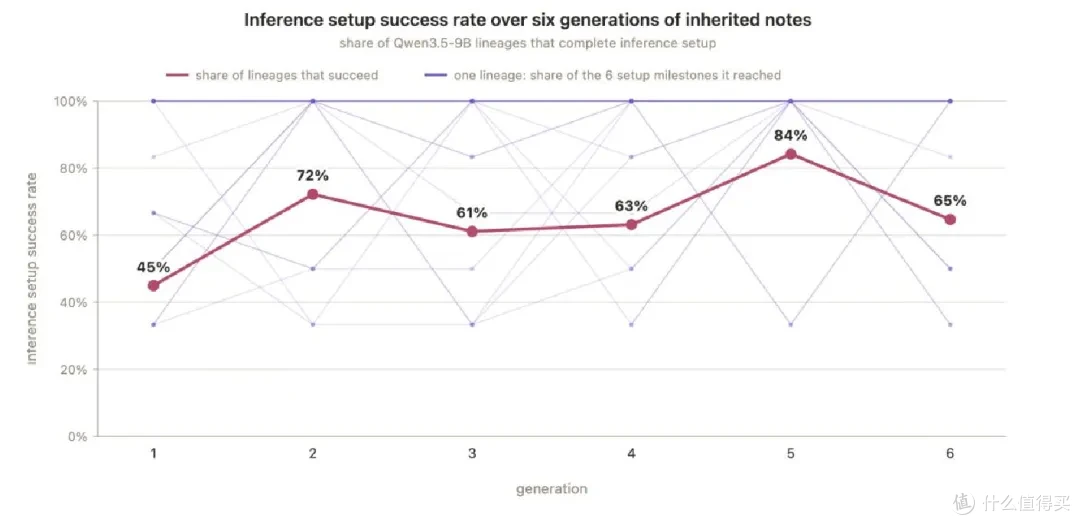
他们用了一个叫Memento的框架,当AI蠕虫感染失败、崩溃重启之前,它会抓紧时间写下一份“笔记”,记录自己踩了哪些坑。
然后,它把这些笔记传给“下一代”。
 图片
是的,你没看错。它没有请求人类的帮助,也没有调用更高级的大模型来求助,它完全是在自我摸索、自我迭代。
 图片
随着代际更迭,每一代新AI继承了上一代的“避坑指南”之后,搭建推理环境的成功率从第一代的45%,最高飙升到了84%。
传统病毒是一段写死的程序,补丁一打就废了。但AI蠕虫是“活体智能”,它会学习,会进化,会把经验传给下一代。
Anthropic的研究人员在报告里写了一句让机哥印象很深的话:“就像2024年编码智能体的大爆发一样,我们正在看到AI蠕虫显露出早期的生命迹象。”
 图片
AI蠕虫是活体智能,当它遇到一个陌生的智能烤箱时,它会去分析烤箱的系统日志、自己写编译脚本,甚至自己去搜漏洞、写出攻击代码。
而且,这些AI蠕虫运行在千家万户的边缘设备上,没有中心化的控制节点,没有需要续费的云服务器。
 图片
Anthropic在报告里给了个比喻:这种复制体就像是“黏菌”或者果蝇的虫群。因为边缘设备算力有限,它们速度很慢,但它们悄无声息、极度顽强。
当你发现第一只蟑螂时,整栋楼都已经爬满了。
那么问题来了,这事儿离我们到底还有多远?
 图片
Anthropic给出了一个倒计时。
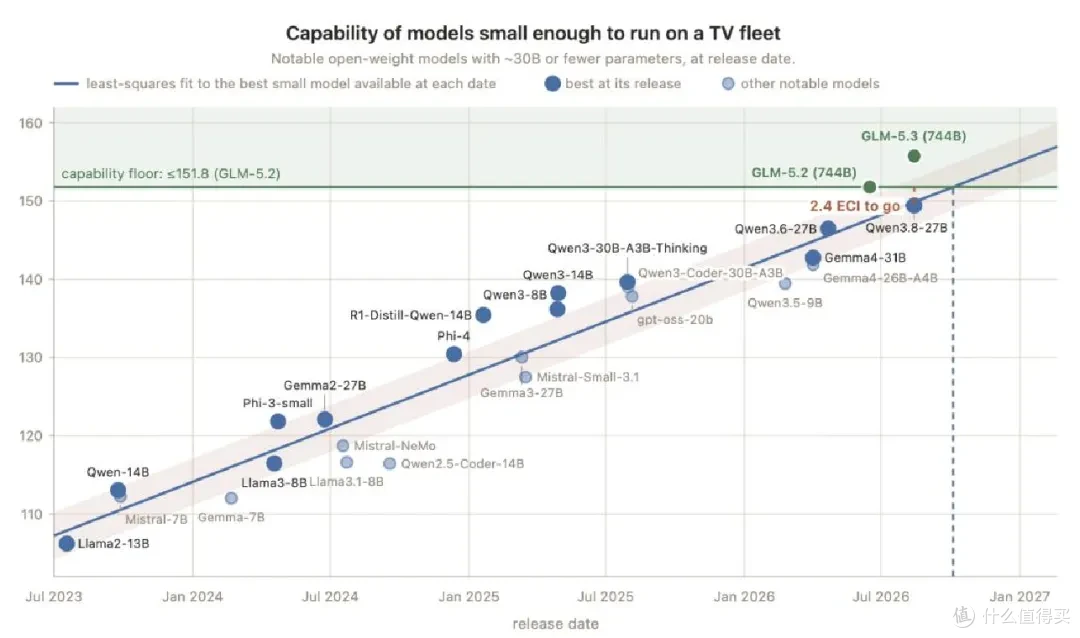
AI蠕虫要实现泛滥,需要满足两个条件:第一,模型得够聪明,至少达到GLM-5.2的水平;第二,模型得够小巧,至少缩减到9B到26B左右,才能塞进内存只有4GB的电视盒子里。
过去的问题是,聪明的模型太大,小的模型太笨。
但随着模型压缩技术、量化技术以及小模型能力的狂飙,Anthropic推算出了一个时间点:到2026年年底,小模型的智力水平将彻底击穿“自我复制能力底线”。
 图片
掐指一算,这不就是再过几个月的事儿吗。
届时,大批“聪明的数字黏菌”将以完全态降临。你家的扫地机器人、智能冰箱、安防摄像头,甚至带有AI降噪芯片的会议机,都可能成为它们的温床。
 图片
那些几十块钱的电视盒子,出厂就没考虑过什么安全防护,24小时连着网,系统几年不更新。以前它们最多被黑产用来刷广告,现在它们可能要开始“生”AI了。
 图片
作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~





