凌晨一点,NAS 推来一条通知:存储池已降级。
很多人的第一反应是下单一块新盘。买盘没错,错的是接下来那十几个小时——你以为自己还有冗余,其实只剩最后一份。
RAID 5 只允许坏一块盘。坏一块,阵列还能跑;但它已经从“坏一块也没事”变成了“再坏一块就全没”。换盘后的重建,就是把这最后一份冗余重新铺一遍。这段时间,是整套系统最脆的时候。
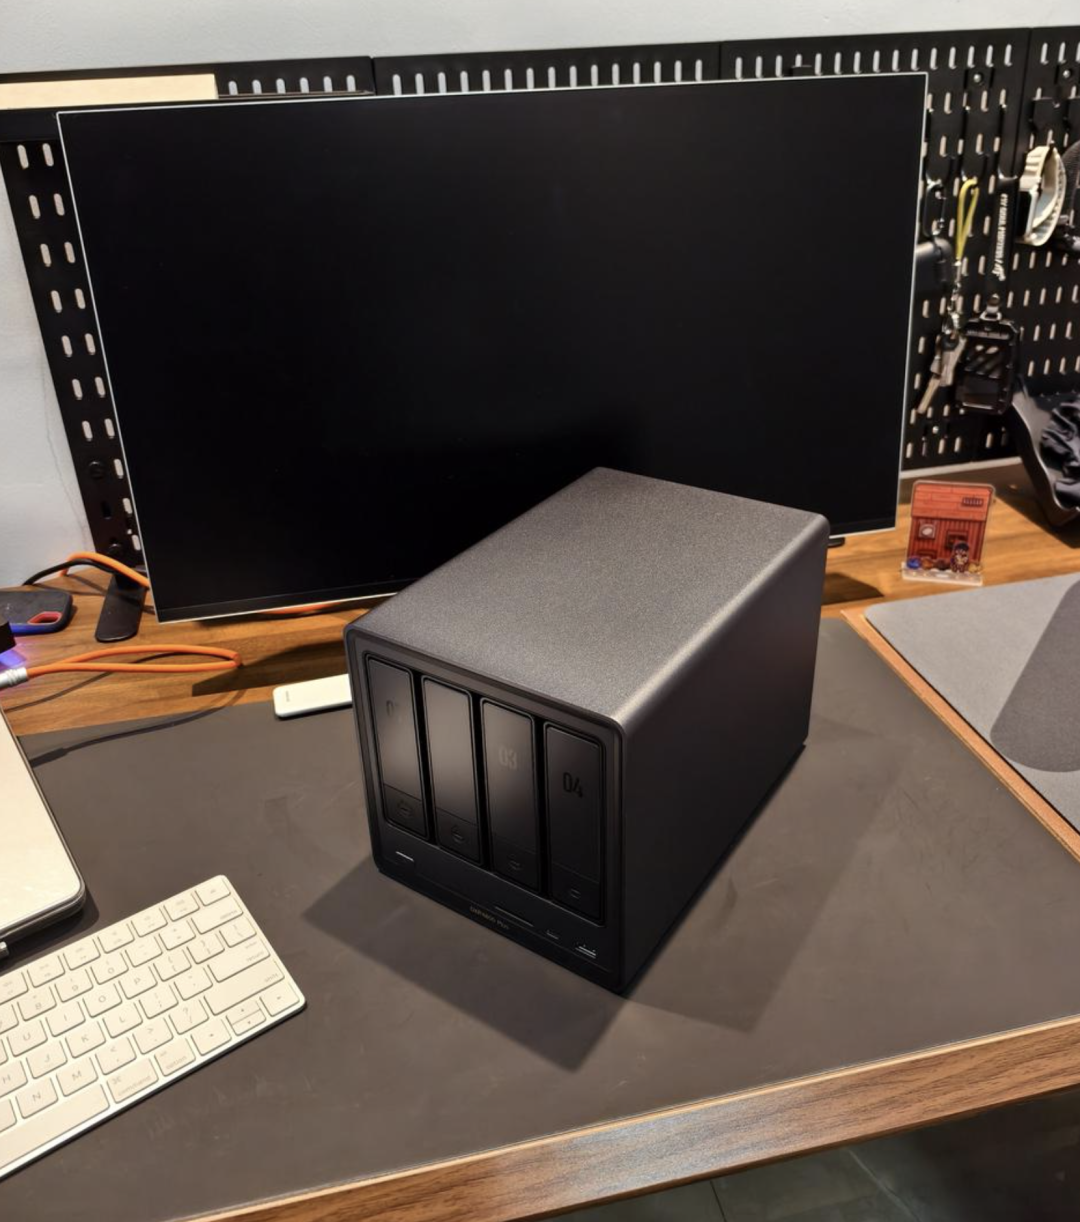
先确认:阵列是不是真的健康
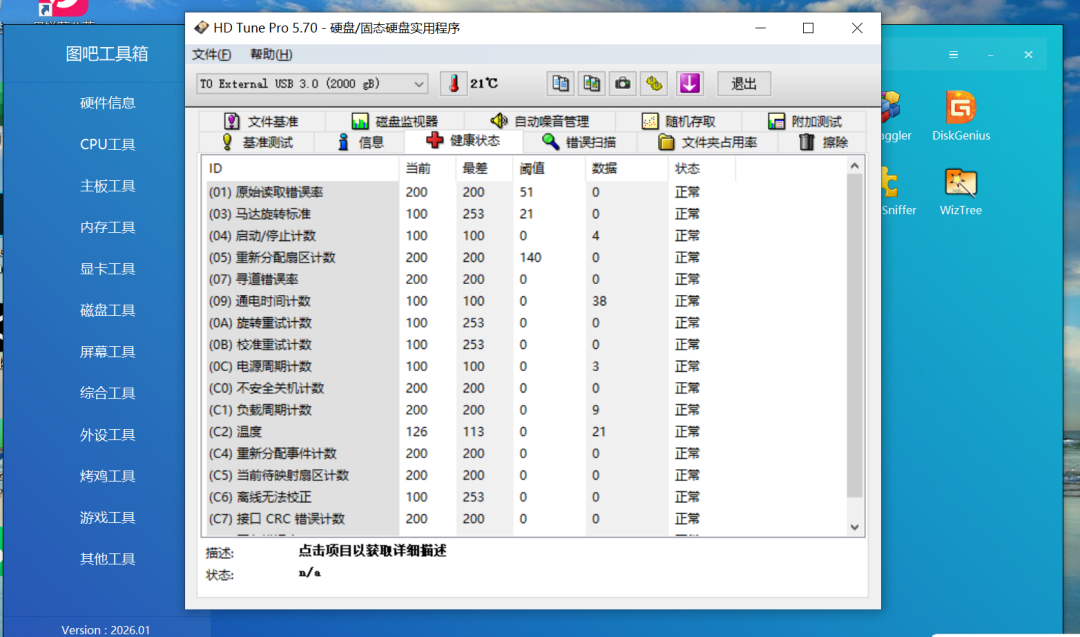
扩容前只看三处:存储池状态是不是“正常”;所有成员盘的重分配扇区计数是不是稳定在 0;上一次完整性校验距今多久。
重分配扇区从 0 变成个位数还在涨,或待映射扇区非零,都别急着加盘。UDMA CRC 错误一直涨,先查线材和背板。
阵列带病时扩容,等于在只剩单份冗余的情况下,做一次十几个小时的高负载操作。知乎
重建要多久:4TB 六小时,12TB 十七小时
重建要把其余每块盘顺序读一遍,时间下限由容量和持续传输率决定。4TB 按 180MB/s 估算约 6.5 小时,8TB 按 215MB/s 约 10.8 小时,12TB 按 200MB/s 约 17.5 小时。知乎
如果阵列里混进一块只有 150MB/s 的老盘,同样 12TB 会被拖到 23 小时以上。风险窗口就是这么被拉长的。
还有一笔概率账:消费级盘标称的不可恢复读错误率常见是 1/10^14,大约每读 12.5TB 就可能撞上一个读不出的扇区;重建恰好要读完整阵列。
新盘别乱配:同型号、同档位
同一个阵列里的盘,尽量同型号、同容量、同期买。混装不只是难看:重建速度会被最慢的那块拖住,固件差异也会在极端负载下被放大。
档位也要对齐。家用盘常见标称 180TB/年、3 年质保;高负载盘常见标称 550TB/年、5 年质保。拿 180TB/年的盘去补 550TB/年的阵列,等于让额度最紧的一环扛全阵列。
重建期间,别再给它加压
重建不是普通写入,是全阵列持续满速读写。这段时间把大批量备份、影音刮削、转码都停掉;把休眠和定时任务关掉,别让重建被调度打断;接上台 UPS,否则一次断电就能让 17 个小时从头再来。
加盘,不等于加容量
扩容能涨多少可用容量,取决于阵列类型和冗余级别,是纯算术题。有人拿 4TB 单盘建了 SHR 存储池,想加一块 2TB,系统直接拒绝:新盘至少 3.6TB。小红书
买盘之前先算清楚:加这块盘是扩容量、加冗余,还是两者都不变。算不明白,就先别下单。
真正兜底的,是那份不在 NAS 上的副本
RAID 负责的是可用性,不是数据不丢。控制器烧了、误删了、中勒索了,阵列再健康也救不回来。快照如果和原数据在同一个池里,也一样。知乎
至少留两份:一份在本机,防误删;一份在移动硬盘或另一台机器上,平时离线,防整机事故。再讲究一点,放一份到异地。知乎小红书
最后一条:没有真正恢复过一次的备份,等于没有备份。每个月挑个周末,拿副本实际启动一次,看看服务能不能拉起来。