做有声书、接配音单的人,大概都体会过这种肉疼:ElevenLabs 按字符计费,用得越多账单越长,声音数据还得传到别人的服务器上。贵价档的月费能到 990 美元,还限量 credits。知乎知乎
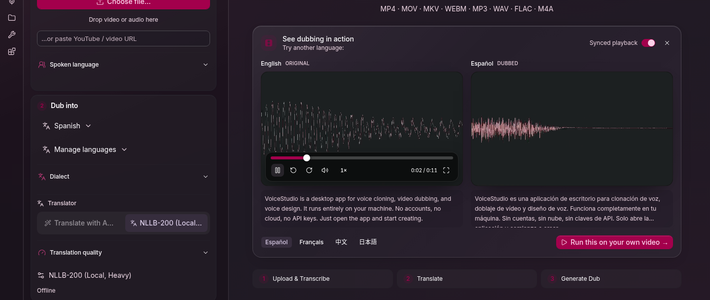
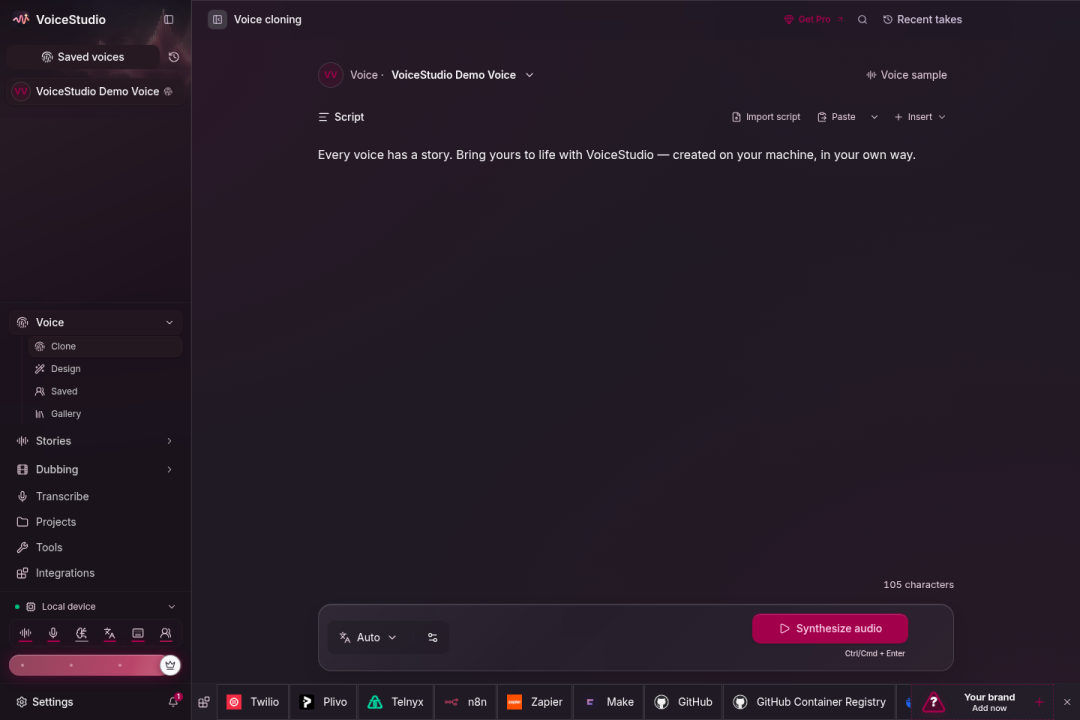
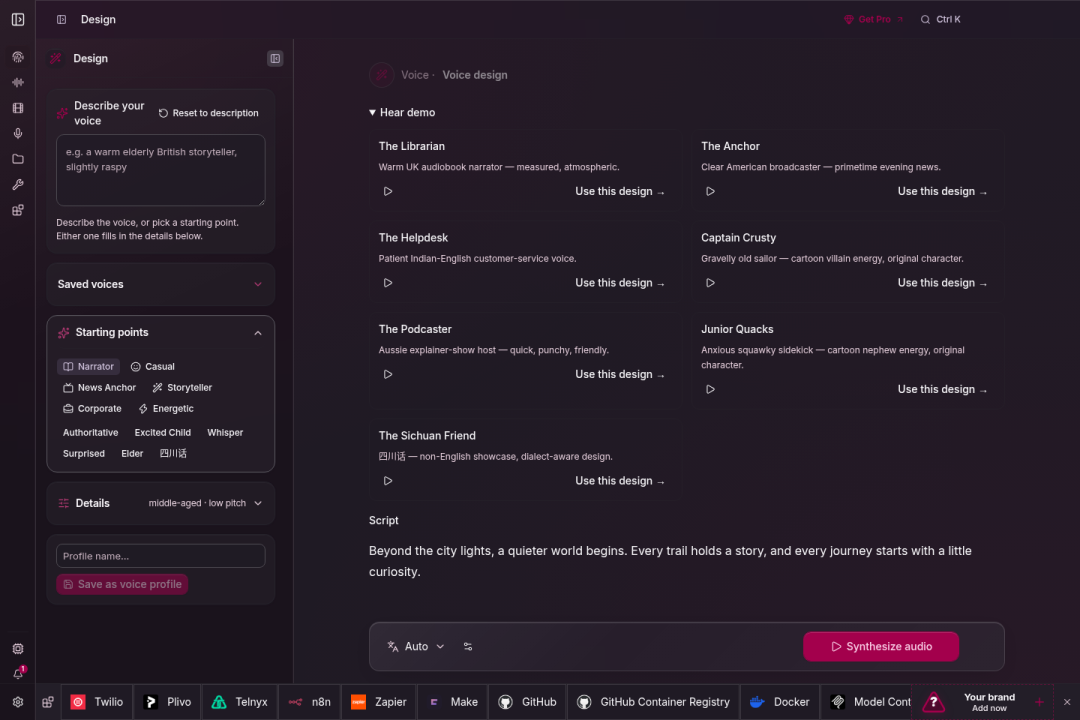
这周,一个叫 VoiceStudio 的开源项目冲上了 GitHub 热榜第一。声音克隆、用文字描述凭空设计音色、视频配音自动对齐时间轴、转录听写做有声书,号称支持 646 种语言,整条链路全在你自己的电脑上跑,数据不出电脑。不联网、不登录、不按字符扣钱。还自带本地 API 和 MCP 接口,能让 AI Agent 直接调用。知乎哔哩哔哩知乎GitHub
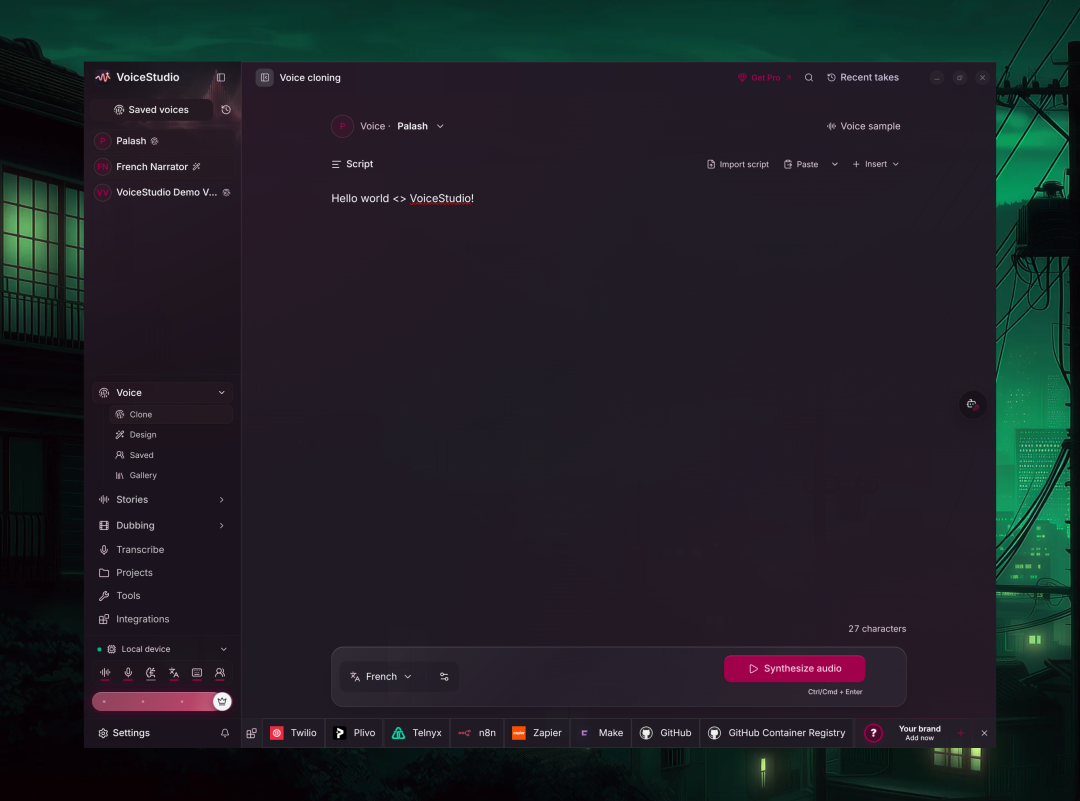
幕后是印度开发者 Palash Debnath 单人维护。仓库今年 4 月才建,现在已经冲到 8.6 万星。知乎哔哩哔哩
听着像白捡,但先别急着接商单
最大的坑不在功能,在授权。
软件本体是 AGPL-3.0,自己用免费,商用也免费;只是改了代码再当网络服务提供,就得把修改开源。真正的雷在它默认下载的引擎 OmniVoice:代码是 Apache-2.0,预训练模型权重却是 CC-BY-NC——非商用。附带的分词器还叠着 Higgs Audio 和 Llama 社区两份独立条款。知乎GitHub
翻译一下:自己录有声书随便用,但接了客户的配音单还用默认引擎,就踩进了自己不知道的雷区。
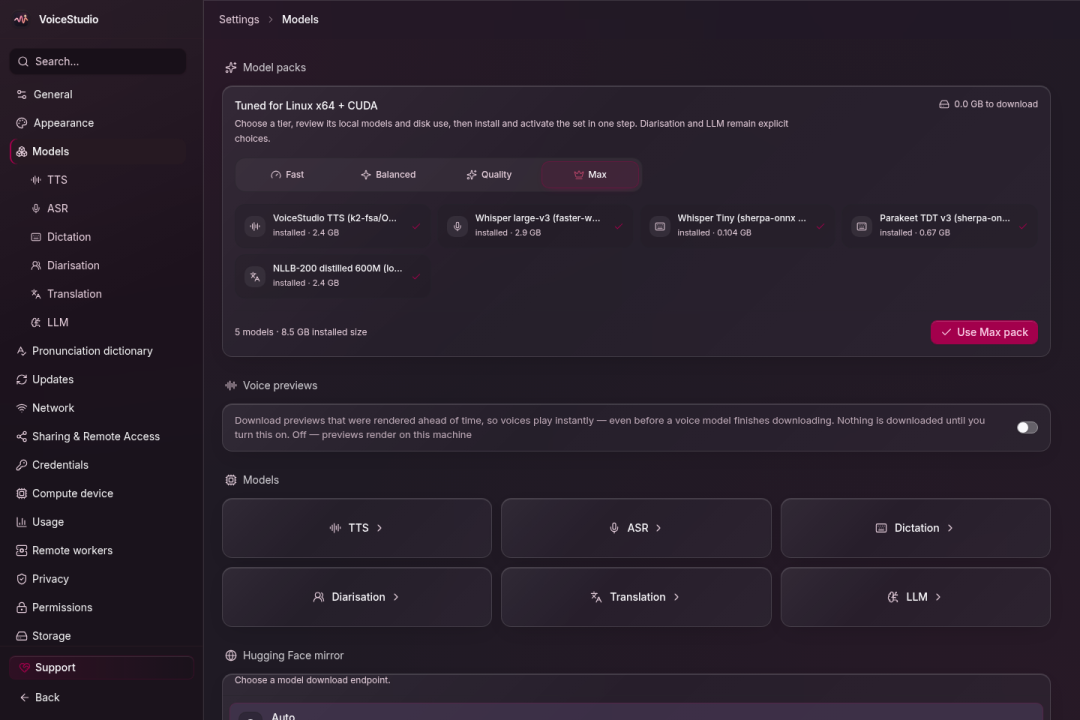
官方其实很坦诚。仓库里挂着一份模型许可清单,登记了 63 个模型仓库。目前,没有任何一个通过商用许可审查。想商用的建议是换引擎,比如 CosyVoice 3、VoxCPM2 这类宽松协议的。但注意,官方文档原话也说了:模型卡上的 Apache-2.0 标签只是上游元数据,逐个核对之前不算数。换句话说,“相对稳”,不是"已放行"。GitHub知乎
星数这事,也别太上头
它的星数轨迹很魔幻:9 月初 1.37 万,9 月底 3.1 万,10 月中 6 万,现在 8.6 万。而同一周里,不同统计源给出的数字能从 6 万飘到 7.5 万。有评论说得很直白:星数衡量的是关注度,不是用户量。知乎哔哩哔哩知乎
而且它还在 β 阶段,更新日志里躺着一串崩溃修复:Apple Silicon 的内存崩溃、Windows 的访问冲突。硬件门槛先看清:N 卡走 CUDA,苹果芯片走 Metal,纯 CPU 也能跑但慢。Intel Mac 用户死了这条心——界面能装,本地推理跑不了,只能连远程后端。知乎知乎GitHub
有一条线,碰都别碰
声音是人最私密的生物特征之一。README 里就一句话:克隆声音必须获得本人许可;生成的音频还默认打上 AudioSeal 隐形水印。给自己的视频配音、翻自己的书,没问题;拿别人的声音干活、绕过平台审核,那是法律红线,各地都在收紧。知乎
到底装不装?对号入座
产出量大的有声书、配音工作室:装,省下的字符费是真金白银,但商用前先换宽松协议引擎,再逐个核对条款;
需要小众语言、音频不能出机的合规场景:这就是为你做的,数据一步都不出你的电脑;
只想开箱即得高质量英文旁白:别折腾,ElevenLabs 的稳定是单引擎精调出来的,本地方案质量取决于你选哪个引擎、喂什么样本,差距可以很大;
Intel Mac、不想折腾环境、需要带 SLA 的托管 API:绕道。
开源平替的浪一波接一波,但"免费"两个字背后,往往藏着要你自己读懂的小字。装之前花一分钟翻翻那份许可清单,比接了单再踩雷,体面得多。