2026年10月的最后一周,三条消息前后脚砸进来。柏林GTC大会上,黄仁勋给运行AI智能体的全套软件举了个价:每块GPU每年约2000美元,但适用范围、生效时间和软件明细尚未公布。 VentureBeat三季度调研数据开始在网上传播:79%的企业受访者表示,其GPU算力至少一半时间处于完全闲置状态,这个比例连续三个月都稳定在77%至81%。 再往前几天,DeepSeek罕见公开了集群经济账:单集群日均吞吐155万亿Token,每卡小时约38美元收入(谷价)。微博36氪知乎
三个数字摆在一起,说的是同一件事:GPU的叙事已经从"抢不抢得到"切换到"跑不跑得满、划不划得来"。如果你自己买卡跑推理、微调或者Agent,这周可能是今年最适合把账本翻出来的一周。
第一笔账:79%闲置,这个数字有多硬,闲置在哪
先说数据的成色。这不是单份问卷:VentureBeat旗下研究机构把2026年7月、8月、9月三轮VB Pulse AI基础设施调查做了汇总,"GPU至少一半时间完全闲置"的比例三个月都稳定在77%到81%的高位。三轮调查共吸引了385名符合条件的受访者,全部来自员工不少于100人的机构,其中也包括替大客户作答的咨询顾问。 反复测出来的一致区间,比任何一次爆点都说明问题。知乎
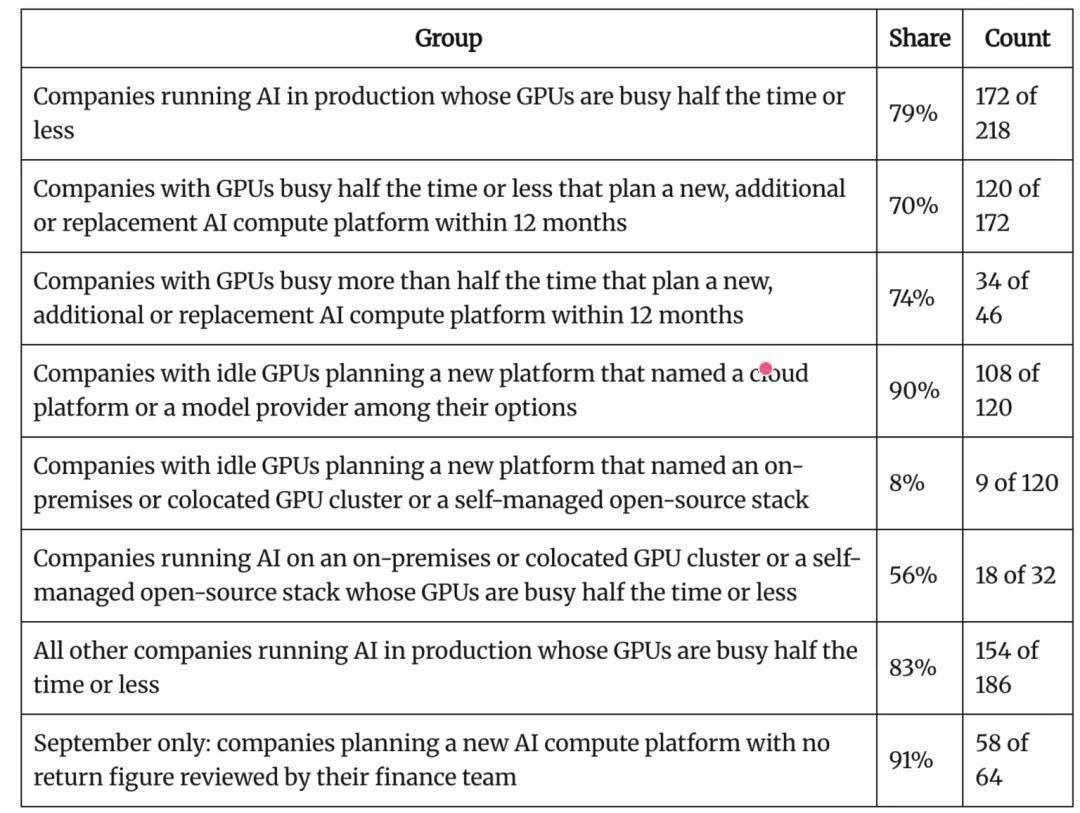
更魔幻的是后面半句:这批卡闲置过半的企业里,70%仍计划未来12个月引入、扩充或更换新的AI计算平台。36氪
但他们新一轮投入的去处,和自家存量完全是两回事:计划采购新计算平台且GPU闲置的企业中,90%把目光投向了公有云与模型API服务商,仅有8%考虑扩建本地私有集群。知乎
更关键的是财务评估没跟上投入速度:9月的调查中,在64名计划采用新AI平台的受访者里,58人没有经过财务部门审核的ROI数据,占比高达91%。 当然,没有经过审核的ROI不等于没有收益,但它至少说明:相当一部分企业在准备下一轮AI投入时,账还没算清。36氪
钱去哪了?《财富》8月报道过一个标志性案例:Uber鼓励员工尽量多用AI工具,甚至按使用量给工程师排"排行榜",结果几个月烧光了2026全年的AI预算,公司不得不宣告"Token狂欢(Tokenmaxxing)"时代终结。 一边是自建集群在机房吃灰,一边是API账单以肉眼可见的速度失控——这才是这批调研里最扎心的结构性错配:企业的真实AI需求没有消失,只是落在了旧硬件承接不住的地方。上一轮"防踏空"式的算力储备,撞上了这一轮Agent化的消费方式,两头都没接上。知乎
反证也要讲清楚:一部分闲置可能是企业有意为峰值预留的冗余,"引入新平台"也可能只是替换旧设备;385份自报问卷更不是全球企业均值。 就算把这些折扣都打满,"自建卡吃灰+API烧钱"作为普遍现象依然成立——证据强度不足以下"算力泡沫破裂"的结论,但足够给每一个准备签下一份算力合同的人提个醒。36氪
第二笔账:那2000美元/卡/年,到底会收在谁头上
先把误读拆掉。黄仁勋是在10月的柏林GTC大会公布的:配套支撑AI智能体运转的全套AI软件,年授权费约为每块GPU 2000美元,按付费授权达500万份测算,该定价模式五年有望带来500亿美元收入。 但适用范围、生效时间、软件明细至今都没公布——这不是"买了英伟达卡就自动多扣2000美元"的既成事实,CUDA和驱动也不是今天开卖。微博
但方向本身值得记一笔:收费模式正在从"一次性硬件"转向"按卡持续收费"。真按每卡计价的话,一万张卡的集群一年就是2000万美元的软件续订费。 有意思的是,把这笔钱放回利用率里算,天差地别:知乎
如果一万张卡跑出DeepSeek那种利用率,每卡每小时38美元意味着年化单卡收入超过30万美元,2000美元的软件费几乎可以忽略——为"跑得满"付费的企业不会喊疼;
如果一万张卡一半时间闲置(正好是调研里的79%常态),这2000万就是叠在折旧、电费和机房租金上的纯新增损失。
所以订阅信号和闲置数据在同一周爆出来,其实互相解释了一件事:英伟达想收的是"算力在线运转"的钱,而企业的痛点恰恰是让卡真正跑起来。对你手里的每一张卡,问题不再是"买贵了没有",而是"它值不值这2000美元/年"。
第三笔账:卡怎么跑满——DeepSeek把38美元/卡/小时算成了什么
DeepSeek那份披露之所以值钱,是因为它把"利用率"从玄学拆成了可复制的工程清单:长上下文、内容大量重复的Agent场景里,Token量和GPU需求不是线性关系,而是次线性的——命中的部分根本不用重算。具体手段包括把KV Cache持久化到SSD、降低对HBM的依赖;异步调度消掉GPU空转、变长验证加6%、负载均衡因子从1.09压到1.03。单看每一项都不起眼,叠起来是每个Token成本差出一个数量级。知乎
英伟达工程师自己给的技术指南也印证了同一条路:在Claude Code这类会话场景里,首次调用之后,后续请求约85%到97%的上下文可以靠缓存复用,而缓存读取价格可以低至普通输入Token的十分之一到四十分之一。 缓存命中已经不是模型厂商的锦上添花,而是利用率的第一杠杆。知乎
反面教材是Agent的数量账。Gartner预测到2028年,单个Agent工作流的推理成本将上升5倍以上——不是Token单价变贵(单位成本还在降),而是单次任务消耗的Token量涨得比降价更快。Vals AI的编程任务评测更直白:主Agent调度多个子Agent的方案,成本是单Agent的1.8到5.1倍,而四种测试配置里只有一种拿到统计显著的性能提升。 多开Agent不等于多产出,很可能只是让更多模型同时烧你的预算。知乎
这周还有个背景噪音值得一句:消费级30/40系显卡的开源算力解锁工具(gpu-unlock)继续刷屏,《显卡日报》这类解读视频也在连番跟进。 老卡的AI残值在被社区一寸一寸讨回来——这和"按卡收费"恰好是同一个趋势的两头:卡的账面价值,正在从出厂标称走向"实际能在线跑什么"。哔哩哔哩
不同仓位,分别怎么动
手里有集群、正在决策扩容的:签下一份合同之前,先把自己过去90天的真实利用率和P95负载摸出来——91%没有经财务审核的ROI就是行业平均水平,别拿厂商TCO计算器当自己的账本。继续盯两件事:英伟达软件订阅的明细和生效范围是否公布;若按每卡收费,把2000美元/卡/年放进三年TCO重算,和云API的价签再比一次。
中小团队自部署推理的:第一杠杆是连续批处理加上下文缓存(85%~97%的可复用率摆在那),第二杠杆是审计多Agent扇出(1.8~5.1倍的成本、四分之一有效率)。自建和API别放进一个糊涂账:Uber的教训是API成本由人的行为驱动,不会像折旧一样可预测,建议给团队AI用量单独设预算和观测,而不是混在基础设施里。
个人装机党和老卡用户:"每卡2000美元"的标题先别慌,消费级卡目前不会被自动扣这笔钱;但下一次买卡时,把"这张卡一年能在线跑多少有效推理"放进决策项,而不是只看跑分和标称算力。手里的30/40系老卡,AI残值正在被解锁工具和推理优化重新定价,卖早了可能比留久了更亏。
接下来盯什么
三个可验证的观察信号:其一,英伟达是否公布软件订阅的适用范围、定价页和生效时间;其二,VentureBeat下一季调研里77%~81%这个区间是继续收紧还是松动;其三,DeepSeek之外还有多少厂商愿意公开"每卡小时收入"这种口径——当算力行开始按小时论英雄,2027年该买什么卡、该怎么跑、要不要再等等,答案会比今天清楚得多。