用AI的人多半经历过这种事:一个助手调教了半个月,你的偏好、你的项目、你的雷区它都懂了——结果换个工具,全部清零。像换了手机,聊天记录没迁移。
10月16日,腾讯混元开源了Hy-Memory 2.0。一句话概括:它想把AI的记忆,变成可以带走的资产。微博知乎
这次开源了什么?三层
最底下是Hy-Memory-30B-A3B,一个专门负责"记忆读写"的模型:总参数约30B,激活只有3B,跑起来不算重。中间是Hy-Memory框架,负责记忆的存储、更新和检索。最上面最有意思——MemHub,一个跨AI工具共享记忆的应用。知乎
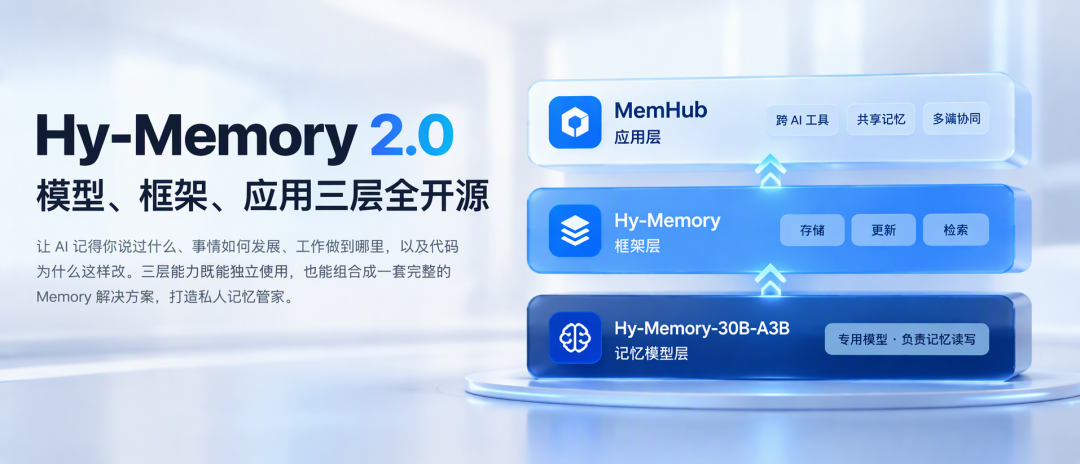
三层全部开源,可以只拿一块用,也能拼成完整方案。而且它不是实验室里的Demo:腾讯内部已经在金融、资讯、知识管理、办公Agent、游戏这些场景用上了。微博微博
MemHub能干嘛?
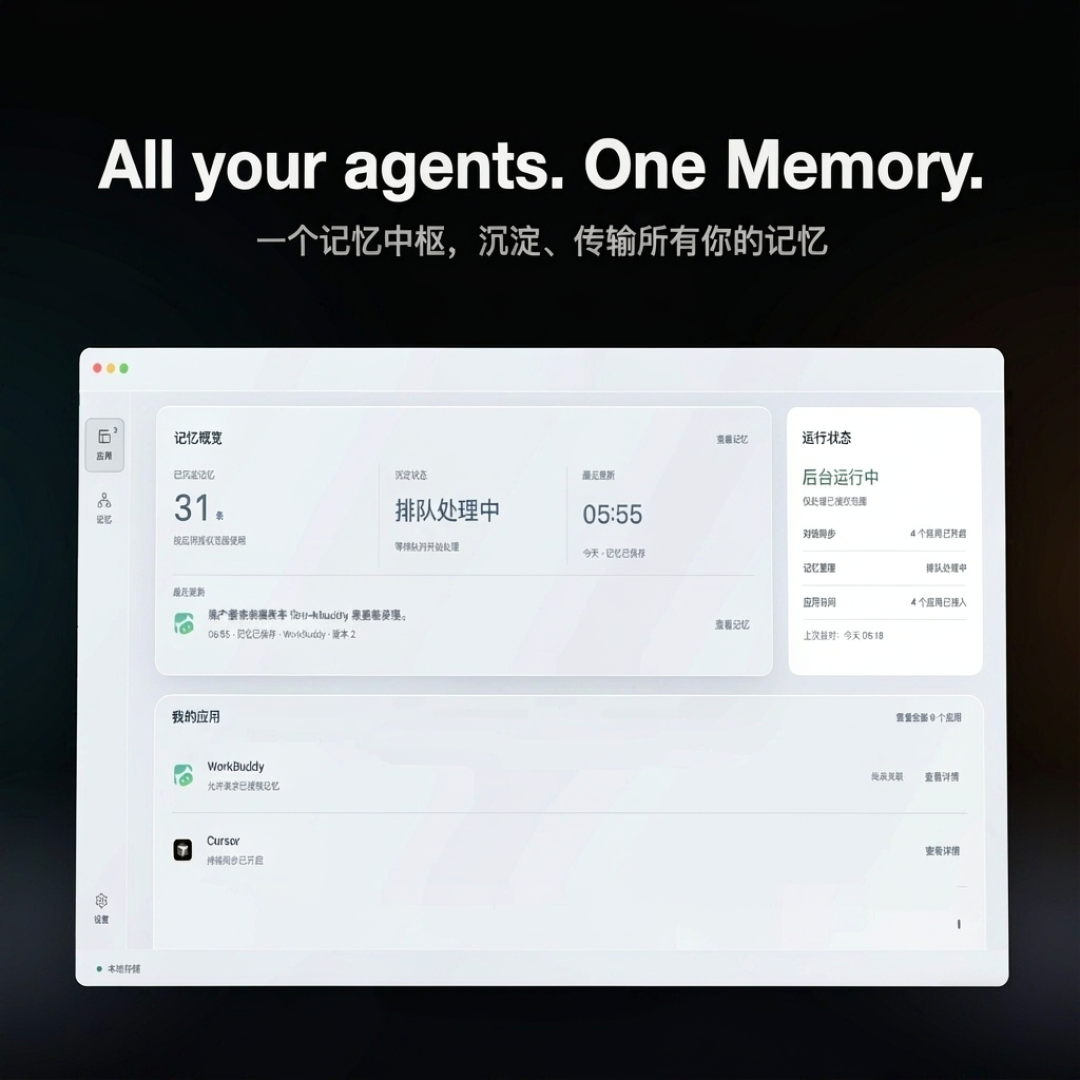
官方演示很直观:你让WorkBuddy写一份汇报提纲,它没有直接动笔,而是先查了MemHub——翻出你在Cursor里存下的汇报习惯"按做了什么、卡在哪、要什么支持来写",又找回另一个助手记录的项目各周关键进展。动笔前,它已经知道你想要什么。知乎
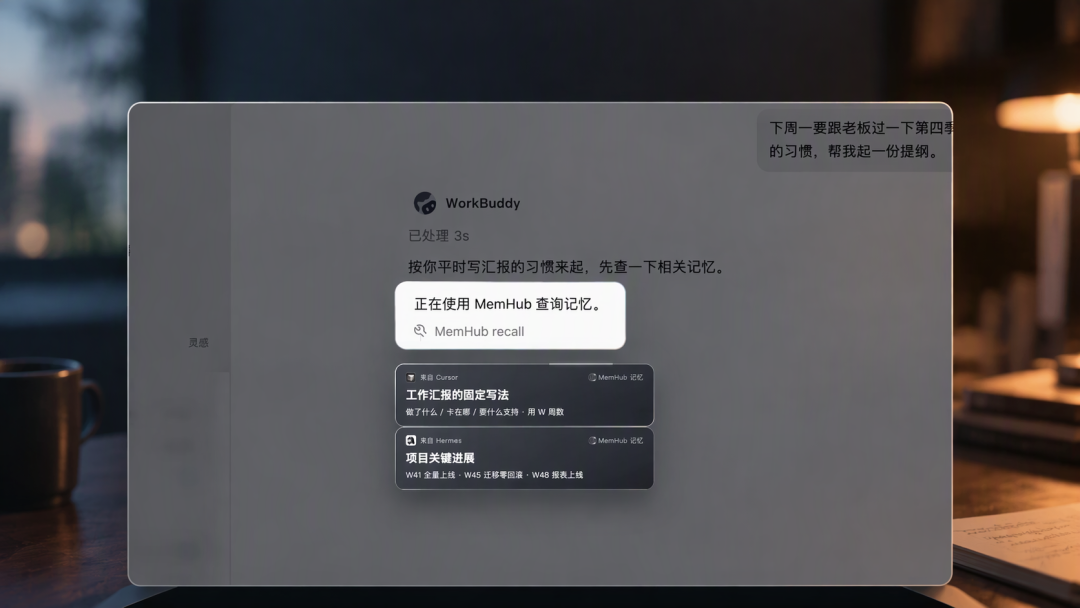
这解决的是多工具党最烦的事:确认过的要求,每换一个工具就要重新解释一遍。以前这些上下文散落在各个对话窗口里,现在至少有个地方能把它们收拢。
两个技术亮点,值得多说一句
一是记忆成了独立能力。过去的做法是让通用大模型顺手做摘要,腾讯专门训了个模型干这件事。公布的评测里,Hy-Memory-30B-A3B在四套记忆系统上综合平均分55.49,超过Claude Opus 5的54.62。这个"超过"稳不稳还要等更多第三方评测,但至少说明记忆读写值得单独训练——而且这个模型还能插进Mem0、MemOS这些别家框架里用。知乎知乎
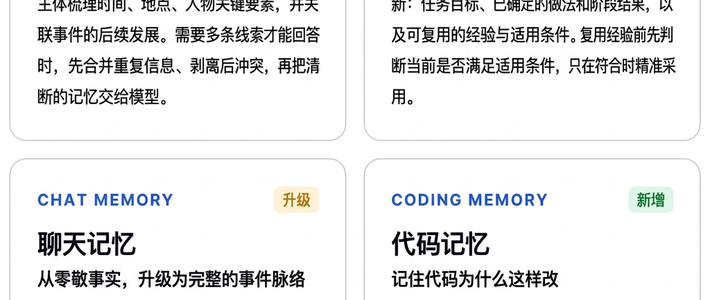
二是不光记对话,还记经验。Hy-Memory把记忆分成聊天、工作、代码三类,代码场景甚至保存改动的"演进链",包括被放弃的失败方案。知道"哪条路走不通",对AI干活同样重要。知乎
别急着装,三盆冷水
一,MemHub还在预览阶段,目前只提供Apple芯片Mac的安装包和Linux运行包,Windows用户再等等。知乎
二,开源不等于零成本:导入历史、提取和更新记忆都要调用大模型,用付费API的话会产生费用,建议先拿一小批材料试水。知乎
三,原始记录保存在本地,但如果配置了第三方模型服务,获授权的内容会发给该服务。"本地优先"不等于全部离线,接通前看清数据去向。知乎
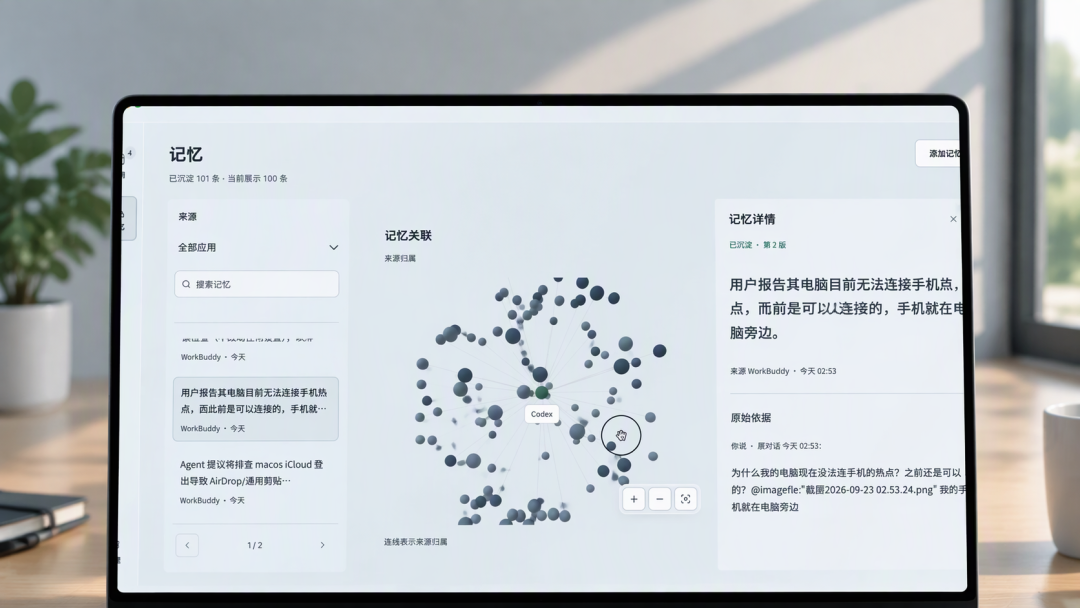
官网是 memory.hunyuan.tencent.com,代码在GitHub的Tencent-Hunyuan/Hy-Memory。
今年AI记忆赛道挺热闹:上海团队记忆张量10月20日已开源MemT-1.0系列。清华的PilotDeck 2.0也下场了,由THUNLP实验室联合面壁智能等团队共同推出。腾讯这次入局,把"AI记得住你"变成了竞争点,还是能带走的那种。知乎知乎
对普通用户,判断标准很简单:不用懂架构,拿个小项目试试——在A工具交代的事,B工具能不能准确找回来。能,就值回票价。