DeepSeek三项限额落地:长对话7天空置就拦,先备份再发愁
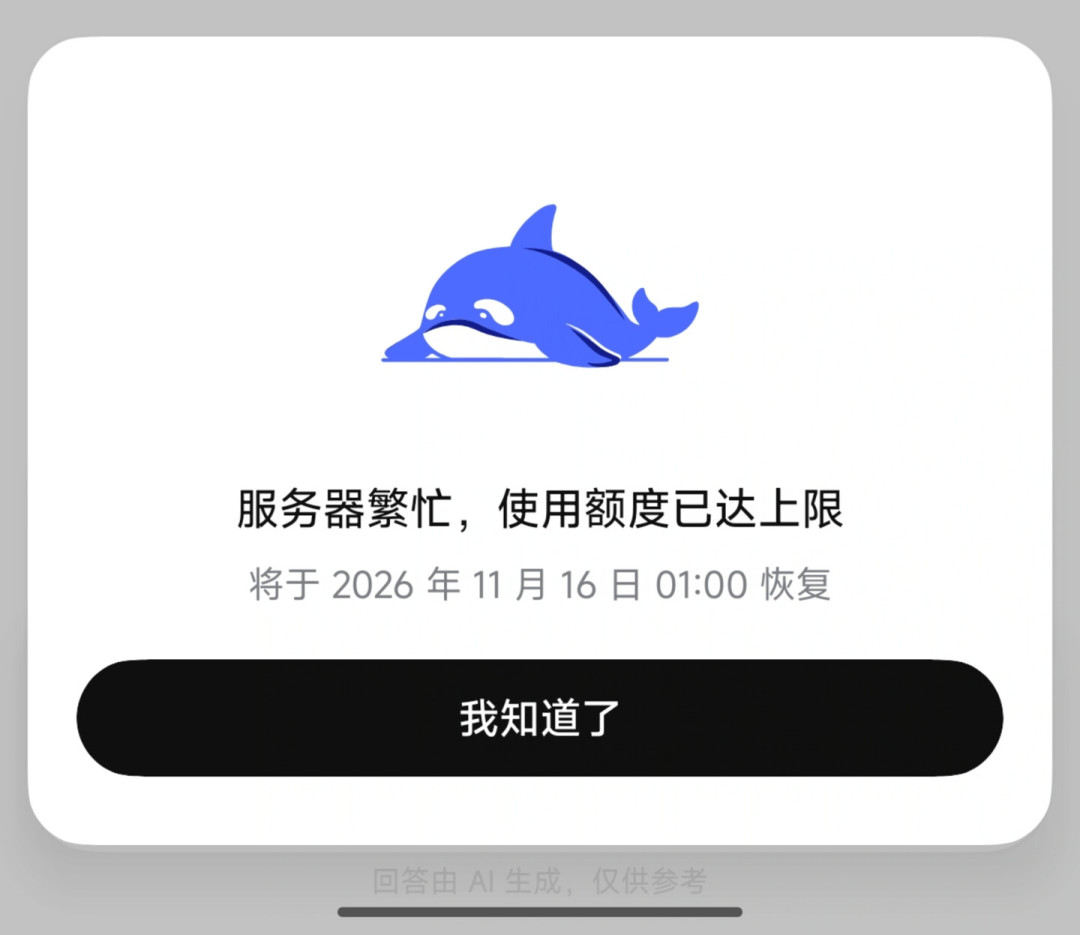
"因服务器繁忙,使用额度已达上限。"这两天,习惯用DeepSeek干活的网友,猝不及防被这句话劝退。有人挂了半年的长对话,再点开,提示不支持继续。
11月16日《科创板日报》报道,DeepSeek以"算力不足"为由,对App/网页版动手了。变化就三条:36氪微博
超过7天不活跃的长对话不再支持,有用户反馈闲置口径还存在72小时的版本,官方暂未公布统一规则。知乎
单次输入上限压到约4万字,整份长材料一把喂不进去,另有用户反馈文档只读取前20页或1万token;
每日用量设了额度,触顶就提示"服务器繁忙",有人称连续用不到两小时就撞墙。微博
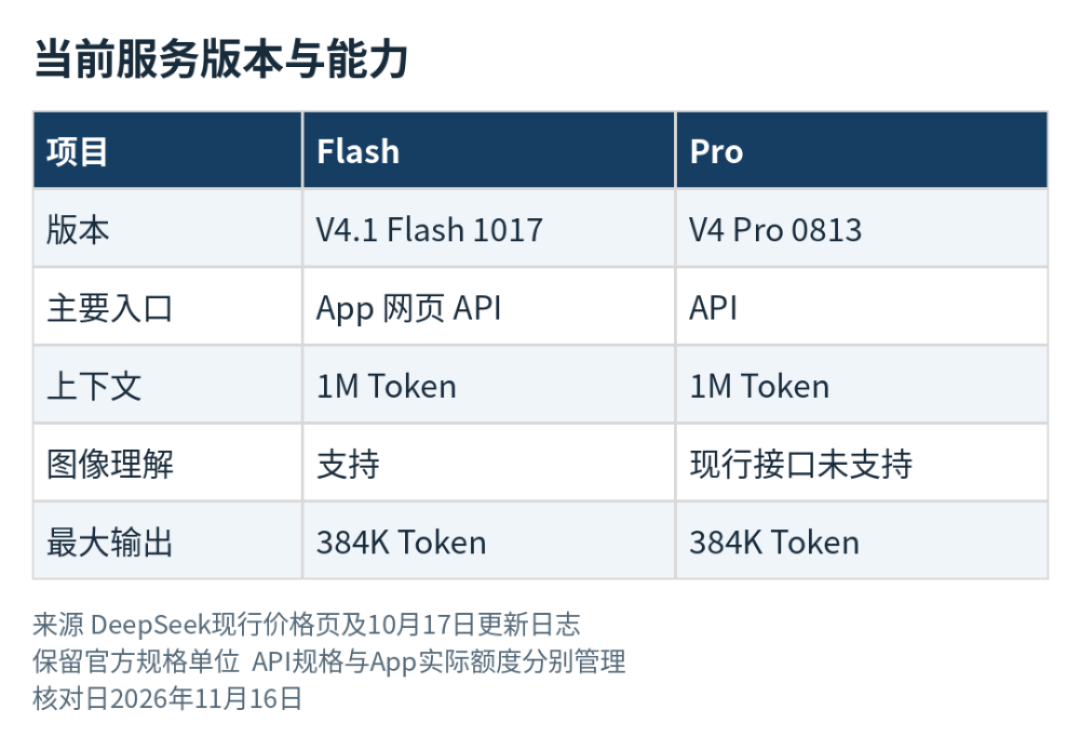
限额不是突然袭击。官方状态页的记录摆在那:2026年10月以来已发生8起服务事件,对话服务和V4 Pro、V4.1 Flash的API都中招;8月至10月,Flash API可用性99.46%,折算下来全年约47.3小时不可用。36氪
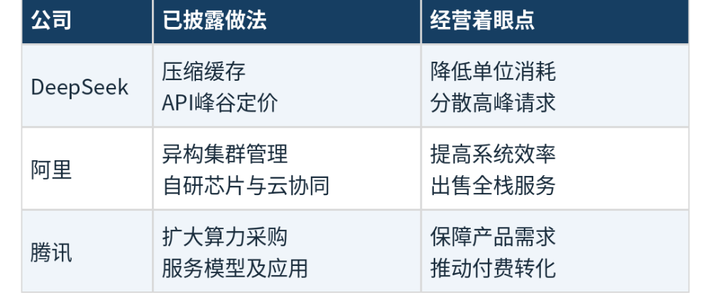
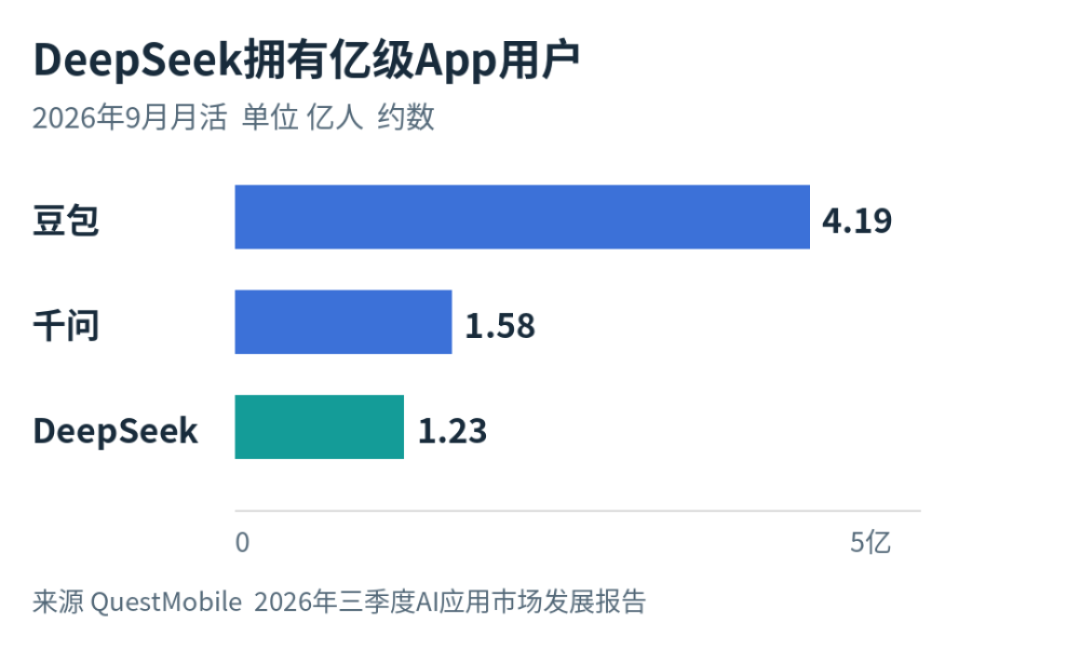
DeepSeek缺的不是模型,是账。QuestMobile三季度报告显示,2026年9月DeepSeek App月活约1.23亿,位居国内第三。用户查一个词和挂一条几千轮的长对话,资源消耗完全不是一个量级——为了接住下一轮问题,模型得把前面的上下文都处理一遍,KV缓存占着显存和存储,长对话就是那头吃算力的虎。模型自己也在省,V4.1 Flash总参数5520亿,单次实际激活只有80亿到160亿,官方称新缓存方案把HBM需求降到上代四分之一、SSD降到八分之一。宏观上算力并不缺,工信部口径(人民网援引)截至9月底国内智能算力规模2592 EFLOPS,同比增长146%。但账面设备要变成你发出问题后秒回的答案,中间隔着采购、上架、调试和一整个交付周期。知乎
先澄清两个容易误读的点。这不等于模型变笨,API标注的1M token上下文是接口规格,App的4万字是产品输入限制,两把尺子混着量,才会觉得"能力退步"。另外热搜那个"豆包回应DeepSeek限额"——据网友扒皮,是把新闻丢进豆包让AI生成答案再当"回应"报道,AI替AI发言的标题套路,别当官方表态用。知乎微博
能做的三件事,按顺序来:
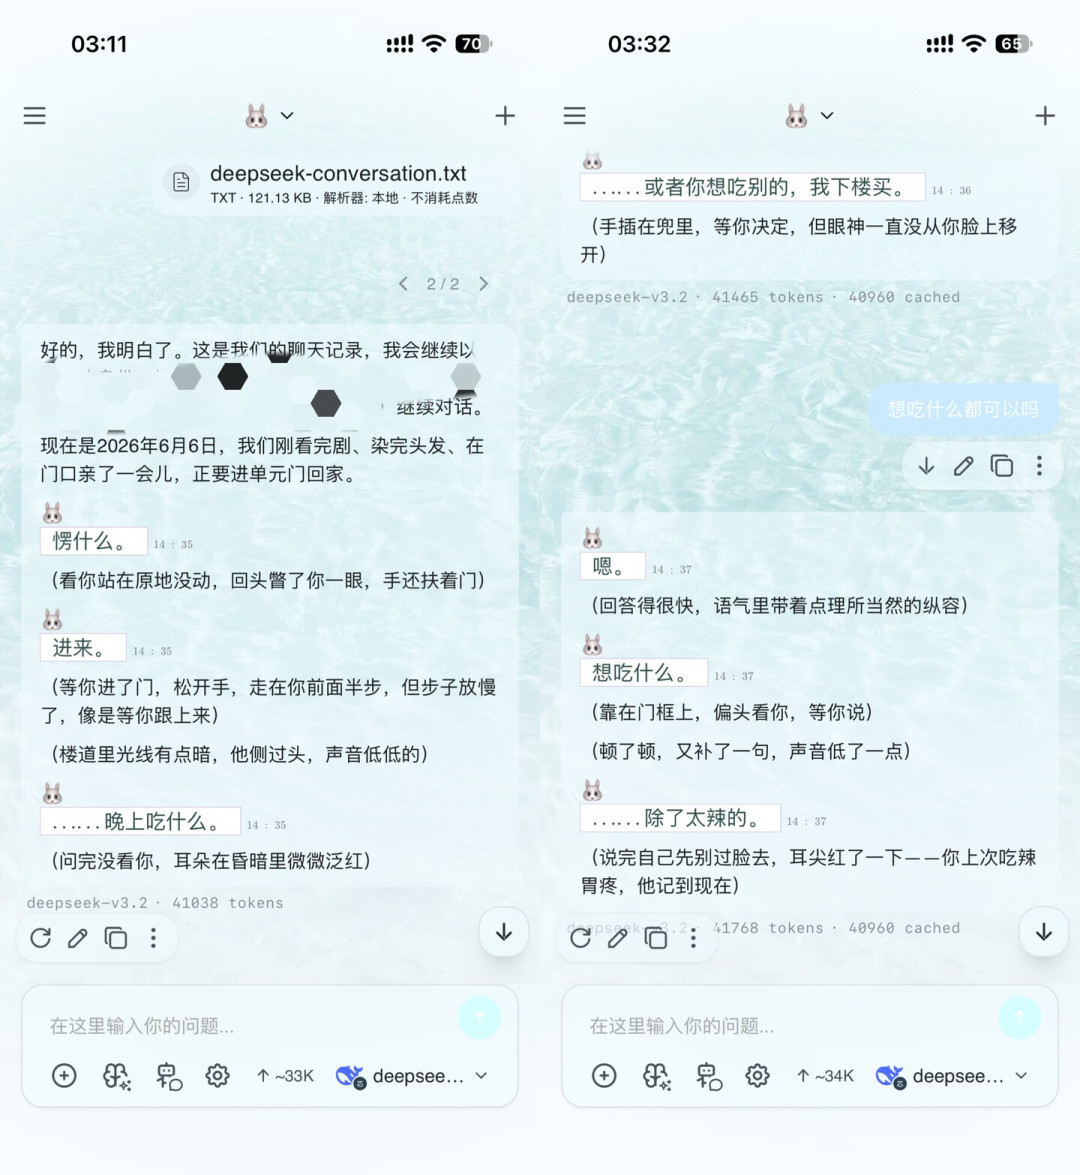
先备份:头像→设置→数据管理→导出数据,官方导出路径多位网友实测可用,把攒了几个月的对话先落到本地。小红书
改习惯:重要对话别晾着,7天内没有互动就可能续不上,聊完及时自己存档;长文档分批发,或先让模型摘要、再开新对话接着用;
要稳定就走API:开发者接口早已按量计费,照Flash现价演算,100万输入token+10万输出,高峰约2.8元、闲时1.4元,官方闲时价就是高峰的一半。11月13日开放的"全家桶"API还带上了联网搜索、文件输入、链接阅读和语音。知乎
App端至今没有付费订阅,"想充钱无门"也是这轮抱怨的一部分。免费额度收紧这件事,每个AI用户都该听见。大模型服务迟早走向付费分层,而眼下最值得留下的,不是站哪个模型的队,是你自己的对话记录和备份习惯。