






3
2
Kimi把2.8万亿参数权重开源了,1.56TB你的电脑装不下:你能拿到的是降价
2026-11-05 16:33:25
0点赞
1收藏
0评论
32秒,出一个字。这是有人不用显卡、纯靠CPU跑Kimi新模型时,公开测试记录里的速度,261.5秒,才吐出8个字。
这个模型叫 Kimi K3.1 Pro。11月4日,月之暗面把它的权重放上了 HuggingFace,仓库公开状态,直接下载,不用申请,不用填表。10月底发布时他们承诺过,最晚11月4日放出,卡着点,兑现了。
有位细心的人去翻了仓库的建档时间,11月2日,比官宣早了两天。货其实早就备好了,就等承诺的那个日子揭幕。
对用AI的人来说,不管你平时用不用Kimi,这都不是小事。整个市场的价格地板,要动了。
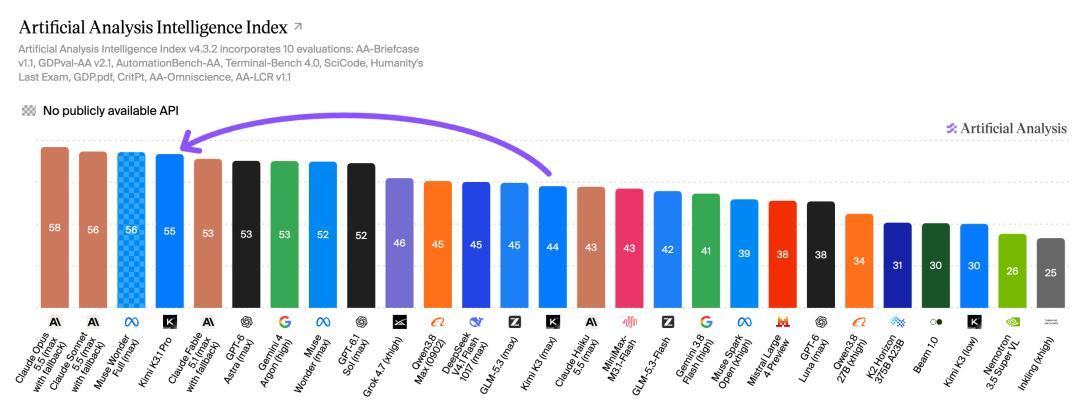
2.8万亿参数,目前开放权重阵营里参数量最大的一个。第三方评测机构 Artificial Analysis 10月底的榜单上,它综合分排215个模型里的第4,在考AI能不能连续干活的 Agent 单项里排第1。
听着很唬人。那你能不能把它搬回家用?
不能。
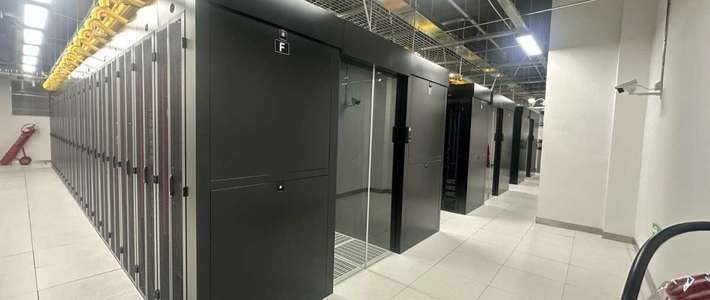
先看体积,96个文件,合计1.56TB,这已经是把精度压到极限之后的身材。光下载就得预留1.6TB的空盘,千兆宽带跑满也要按小时算。更难的是跑起来。这个模型是 MoE 架构,2.8万亿参数里,每次提问真正翻动的只有1040亿左右,像一座巨大的图书馆,每次问题只抽几本书出来读。但翻归翻,书得在你家里。光把权重装进显存,就要两台半以上每台插满80GB显存卡的服务器,这还没算真正运算时要吃的其他内存。这已经不是好电脑的事,是机房的事。
前面那个32秒一个字,已经是极端省钱的跑法了。那台测试机用的是124核的服务器CPU,硬盘每秒能读3.2GB,权重不进内存,用哪块从硬盘现读哪块,内存占用才勉强压到8GB出头。代价就是那个速度。对研究项目来说这是突破,当日子过,不值当,花的电费和耐心比会员费贵多了。
那这次开源跟你有什么关系?
跟你以后的账单有关系。开放权重不是发福利,是给整个市场重新定价。月之暗面自己先走了一步。K3.1 Pro 的 API 在发布时就比上一代降了约三分之一,输入每百万token 13元,输出68元,上一代是20元和100元。
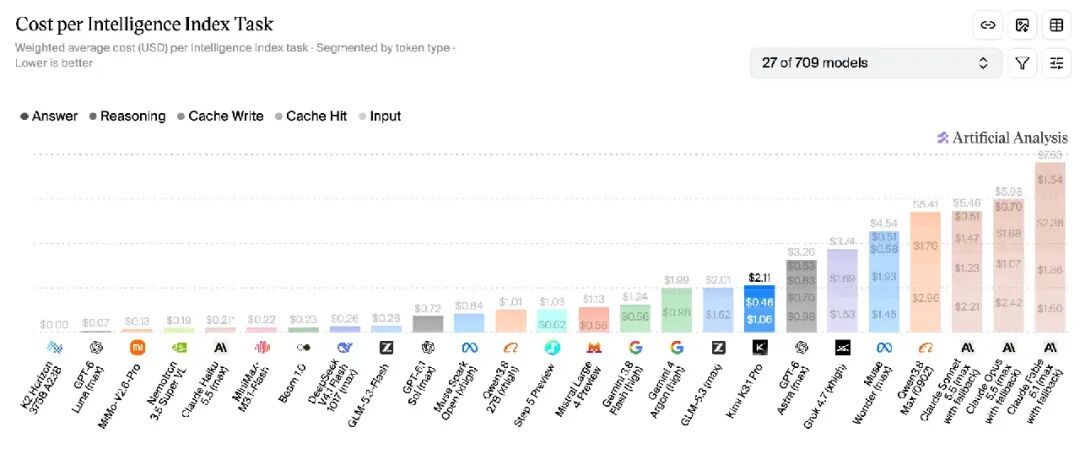
权重放出来,是第二步。大企业现在可以把这个模型部署到自己的服务器上,数据不出门,还能逐条审计,API 厂商要是涨价,随时换一家托管商。许可条款写得也大方,中小团队几乎无条件商用,真正被加了附加义务的,只有少数巨型云厂商和超大流量产品。能自建的人开始自建,卖算力和卖 API 的就只能跟着卷。这个地板价一寸一寸往下压,压到最后,接住它的就是每个用AI过日子的人。
那你自己要不要去试试?网页版和 App 里的 K3.1 Pro 就是同一个模型,普通人根本不用碰权重。但有两件事心里有数。
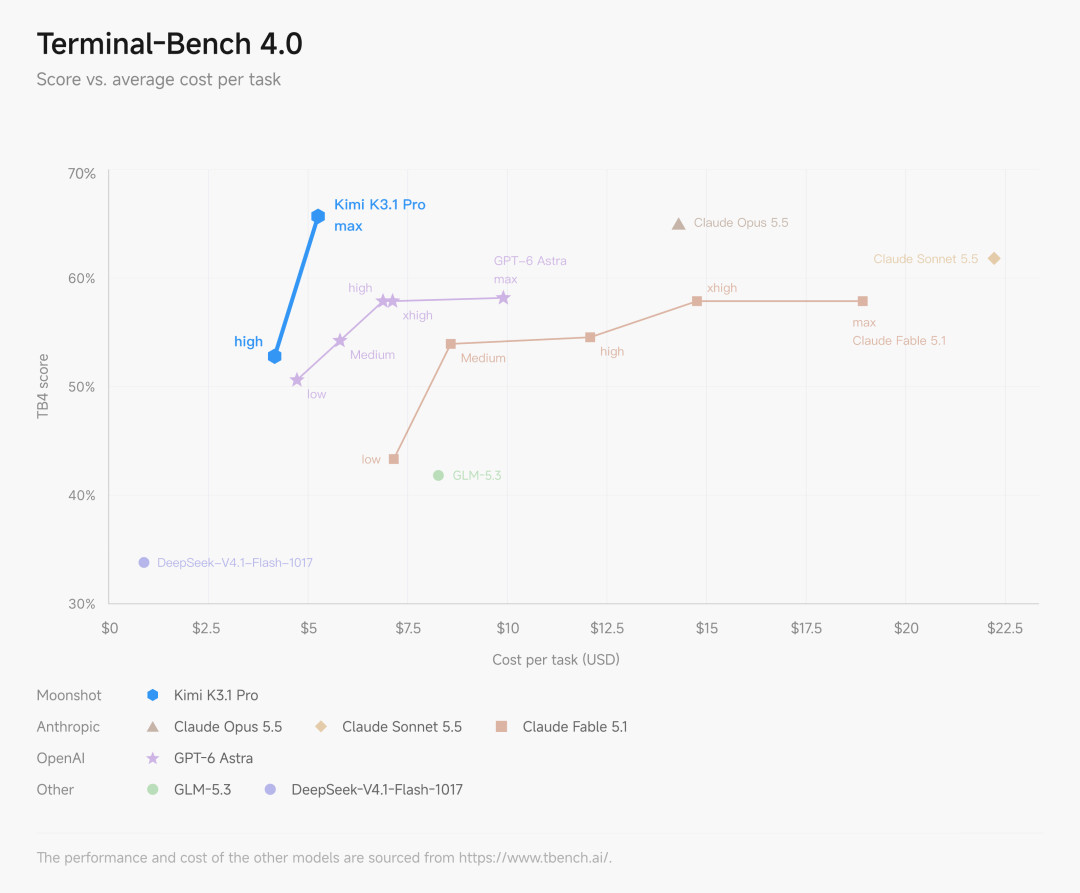
一,知道它擅长什么、不擅长什么。这个模型的长项是长程干活,终端操作、改一整个仓库的代码这类长链条任务,官方自报的成绩在第一梯队。但闭卷深度推理是短板,自报分数比头部闭源模型低了近四成。让它一步一步跑腿办事,是它的强项,指望它闲聊时变成先知,会失望。
二,管好额度。长程任务吃额度凶,Kimi 是有前科的,K3.1 Pro 上线48小时内就为额度消耗问题道过歉、补偿过25%的用量。老舅我劝你一句,派大活之前先看一眼剩余额度,长任务先切一小块试跑。另外按一位用户的实测,注册送的新人代金券碰不了 K3.1 Pro,想试新旗舰基本得实充一小笔,先把这笔账想好。
再说两个小细节。一是 Kimi 的技术报告里明确写了,用了 DeepSeek 的稀疏注意力方案,撑住100万token上下文靠的就是这门借来的手艺。二是华为昇腾一天之内就跟进了推理适配。国产大模型的开源,已经开到你借我的技术、我接你的芯片这个份上,得利的是用的人。
回到那个32秒一个字。跑出这个成绩的人,多半不缺时间,缺的是那间机房。你也不用羡慕,这次开源落到你头上的那份,从来不在下载按钮后面,在下一张降了一截的价目表上。
内容由AI生成