晚上十一点,方案改到第六版。
你把第二轮就否掉的A方案重新说了一遍,AI点点头,又把它提了回来。你以为是它降智了。换个新窗口,同一个问题,它答得干净利落。
这不是错觉。
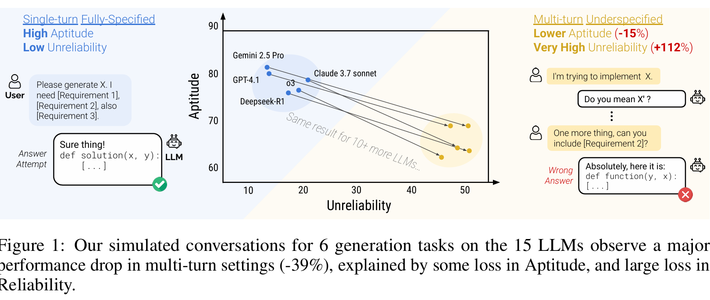
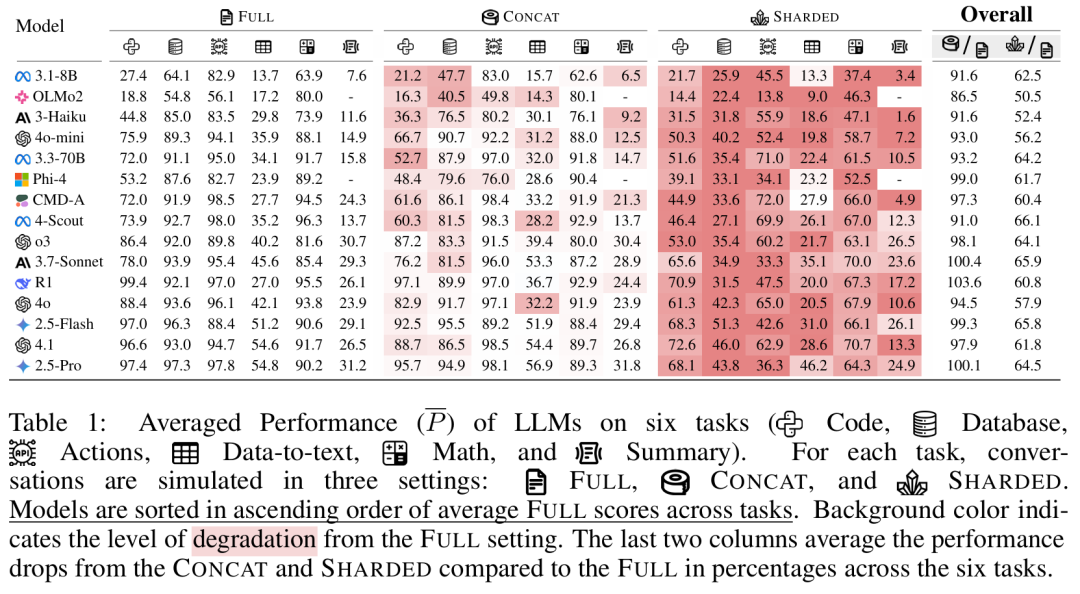
2025年5月,微软研究院和Salesforce联合做了一项研究。他们让15个主流模型跑了20多万次对话模拟,覆盖6类任务;单轮改成多轮,平均掉39%。知乎
研究者没让模型一次性拿到完整题目,而是把一条完整指令拆成碎片,分几轮慢慢给,模拟人一边说、AI一边猜的过程。
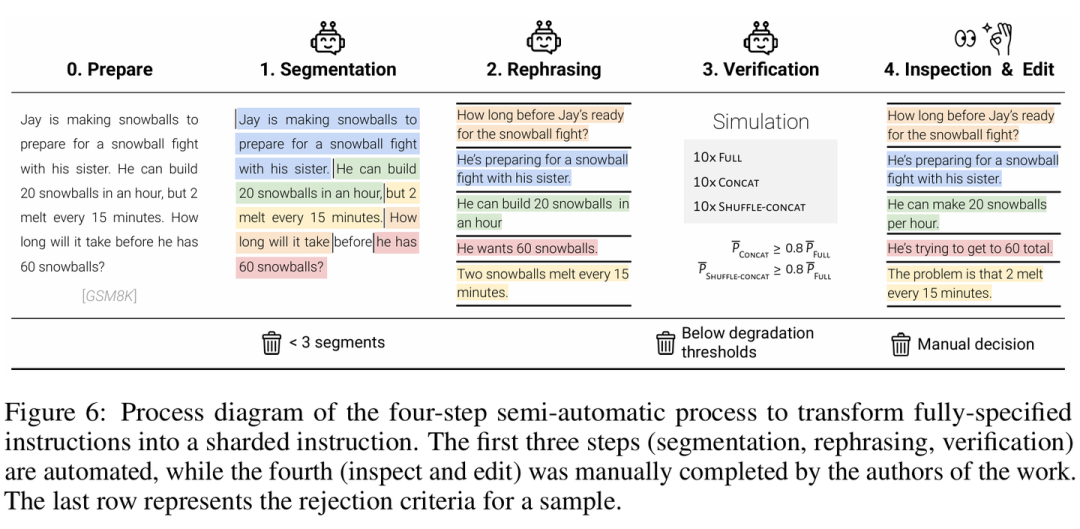
结果不是某一个模型不行。代码、SQL、API调用、数学、数据转文本、摘要,六类任务一起掉。
拆开看更有意思:能力只降了约15%,不可靠性涨了112%。知乎
说白了,它不是不会做,是开始乱做。
原因之一,是它会把前面的错答案当成事实,接着往下推。知乎
论文里写得很直白:模型在某一轮走错,后面往往回不来。arXiv
另一个原因是抢答。信息没说全,它先给结论;你后面补条件,它围着旧结论打补丁。回复也越写越长,多轮回答比单轮长20%到300%。知乎
于是很多人用错力:继续在同一个窗口里掰扯。
一位UP主拿DeepSeek V4.1和Codex做了两组小样本实测:追问“你确定吗”,120次只改口3次;空手开新窗口,DeepSeek 5遍都自己编了一套方案。哔哩哔哩
同一个窗口里越纠越偏,换了窗口又把上下文丢了。
正确的动作不是重开,是交接。先在旧对话里写一张交接单:做什么、交什么;哪些要求作废;哪些已确认、依据是什么;哪些还是推测;试过不行的路;下一步最小的一件事。别复制聊天记录,把推测和事实分开写。哔哩哔哩
只写总结不够。总结容易只留结论,交接单要留下作废项和依据,免得新窗口把旧方案又捡回来。
把它贴进新窗口,先别让它动手。要求它复述目标、约束和手头材料,确认无误再开工。
纠错时也别只说“不对”。把报错原文、反例、出处贴进去,让它对着证据改。
还有一个信号:窗口占用。
有人在自己的工作流里看到,74.5K的窗口,工具输出占了48%。小红书
日志、搜索结果、旧回复挤在一起,你的要求反而被推到中间。先看窗口里装了什么,再决定是压缩还是重开。也不用死记15轮。开始反复改口、重复自己、答非所问,就是该交接的信号。
先别急着骂厂商。多轮对话的退化,15个模型都没躲过。
但版本更新、服务端路由、限额降级,也都是真的。判断方法很简单:同一个问题,新窗口再问一次。新窗口好、旧窗口差,是上下文;两个都差,才是模型或版本。
新开对话不是认输。
你要带过去的是结论和约束,不是几十页聊天记录。