这周 AI 圈最热闹的事,不是哪家又发了新旗舰,而是一个"不会说话"的模型。
9 月 15 日,隐身两年的 TypeSafe AI 正式亮相,同日官宣 DCVC 领投的 4000 万美元种子轮。 创始人 Diogo Almeida 是前 OpenAI 研究员、InstructGPT 论文作者之一,媒体喜欢叫他"ChatGPT 共同发明人之一"。他这次干的事,恰恰是对自己老路线的反水:RLHF 让模型学会取悦人类,却在自动化场景里极其不可靠,这是他公开承认的判断。爱范儿极客公园
Jev 的答案,是把模型做成卡尼曼《思考,快与慢》里的"系统一":输入一段上下文加一组问题,不生成任何文本,一次并行采样直接返回三种结果——Choice(最多 255 个选项里挑一个)、Score(量表打分)、Noul(0 到 1 的概率判断),每个答案都附带概率分布和置信度。硅星人Pro
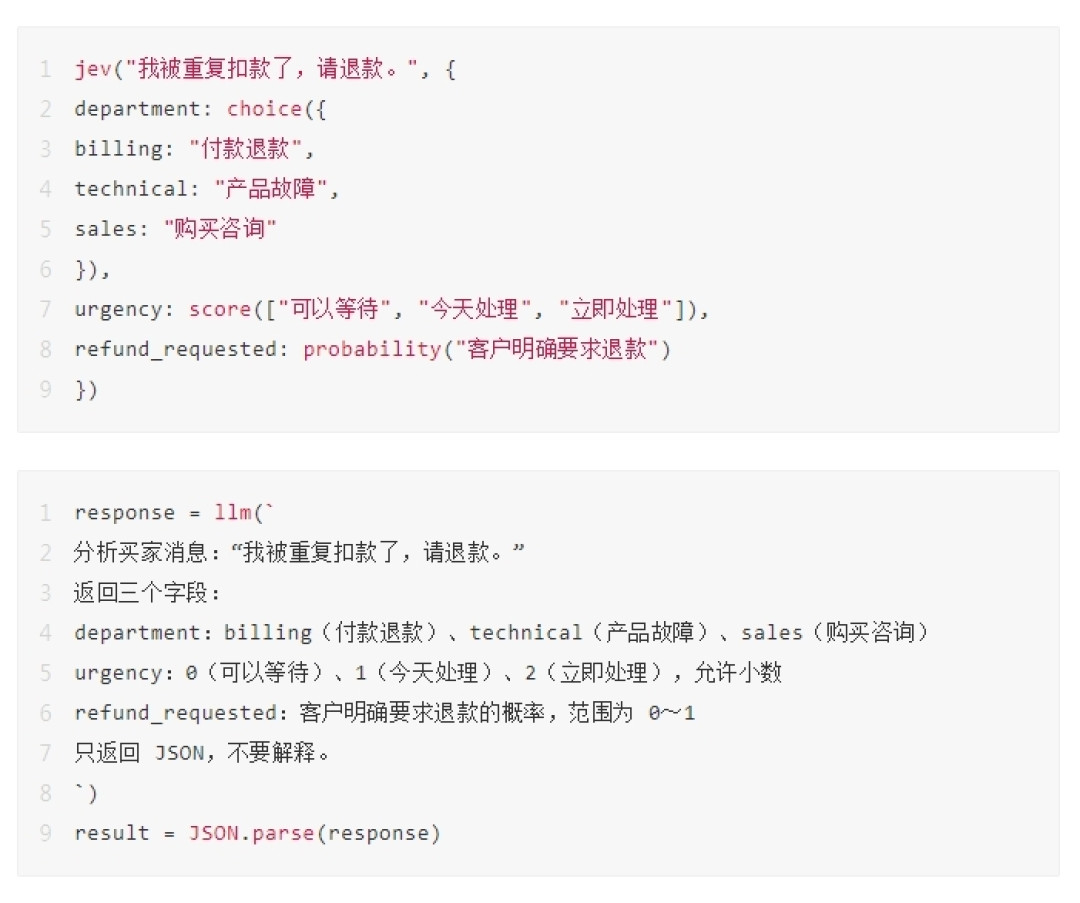
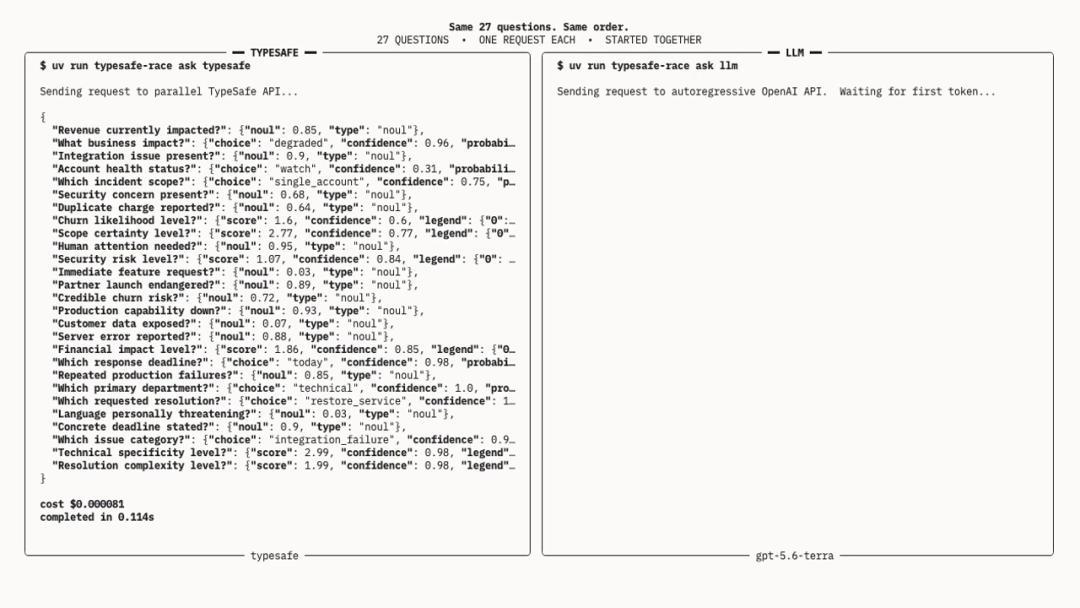
官方口径:端到端延迟 70~500 毫秒,官方称比前沿大模型快 20~200 倍,极客公园的报道里写的是 40~200 倍——同样的活,前沿大模型要 3~329 秒。刷屏数据也很吓人:发布不到 36 小时,约 14 万开发者涌入内测,全面开放当天,API 一度被挤宕机。 接入 Vercel AI Gateway 后 24 小时内,近 13% 的付费团队已经用上,是 Vercel 史上采用最快的模型发布。新智元
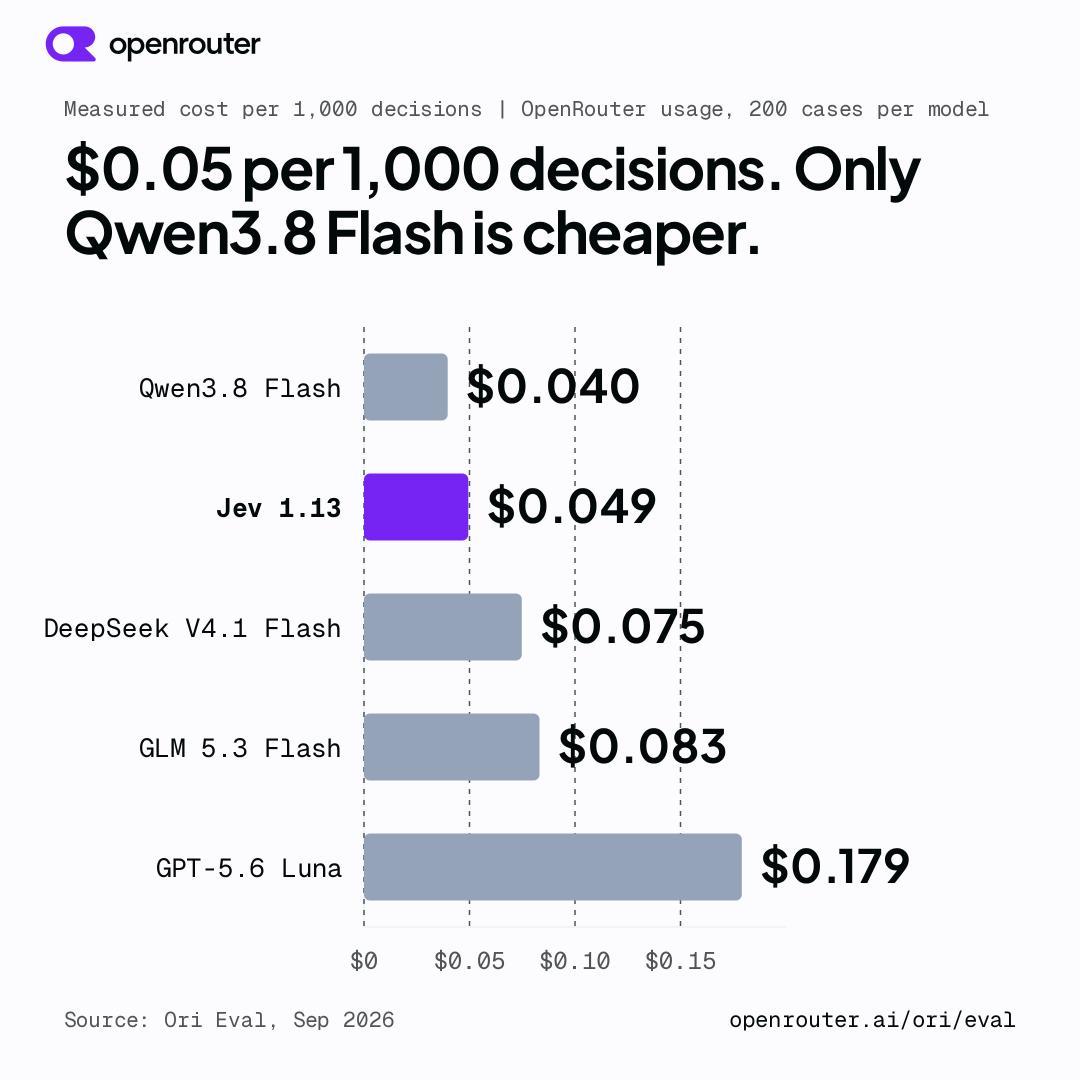
价格则是这波狂欢的燃料:输入 $0.042/百万 token,输出永久免费,官方原话是"便宜到根本不值得计费"。 OpenRouter 上的实测账本也差不多:每 1000 次决策的成本 Jev 是 $0.049,全场只有 Qwen 3.8 Flash 比它更便宜。新智元爱范儿
但先泼一盆冷水:第三方实测不支持"更聪明"
“快 193 倍、便宜 444 倍"的说法在中文圈疯转,但它的原始出处是 TypeSafe 的内部评估。 更微妙的是,基准真值是用竞品模型(GPT-6 Astra、Claude Fable 5.1)生成的,所有基准测试全部来自内部自评、无第三方复现,极客公园直接批评这是"自证闭环”。 官方自测四个企业工作流准确率 67.8%,对比 GPT-5.6 Terra 的 67.9%,基本打平。知乎极客公园硅星人Pro
真正值得看的是 36 氪(硅星人Pro)做的第三方实测:50 条中文电商客服消息,每条做 4 项判断(紧急度、售前概率、处理类别、严重度),四项全对才算分。结果:Jev 完整准确率 64%~65.2%,在便宜小模型组里只排第二,比 DeepSeek V4 Flash 还少 1.2 分;对旗舰组垫底,MiniMax M3 多答对约 5.4 题。它赢的只有两项:每题 0.73~0.75 秒(全场最快),50 题总成本约 $0.002(全场最低)——DeepSeek V4 Flash 每题要 5.58 秒,成本约 2.5 倍。实测结论原文很克制,就一句"很难支持 Jev 是更聪明的模型"——它是一组具体取舍:快、便宜、接受一定的准确率差距。硅星人Pro

实测还挖出一个很实际的坑:阈值附近失分。人工标注严重度下限是 2.00,Jev 给 1.99;紧急度 0.75,它给 0.71~0.72。如果你的业务规则是"达到 2.00 转人工",那 1.99 和 2.00 就是完全不同的两个信号。同一批题重复测试 15 次,有 3 题出现通过/失分交替——这种抖动在高频自动化场景里是要命的。硅星人Pro
顺带说清"零幻觉"的准确含义:它指不会输出 schema 之外的类型错误(A/B/C 里不会蹦出个 D),但选项内照样可能判断错,官方自己也是这么解释的。把它当"永不出错的裁判",是这波传播里最大的一处误读。
开源平替三天就来了,但实测很残酷
Jev 刷屏仅三天,印度独立研究者 Nandakishor Mukkunnoth(他自称 2025 年 3 月就在 arXiv 发过同类论文)开源了 Laya:421M 参数,基于 ModernBERT-large,Apache 2.0 协议权重全公开,GitHub 三天 6693 星。 卖点很狠:单题 33ms,CPU 也能跑(200~500ms/题),Kaggle 免费 2xT4 微调一个 checkpoint 只要 4~5 小时,还有人在 AX8850 NPU 上做了端侧适配——敏感数据不出本地。知乎知乎
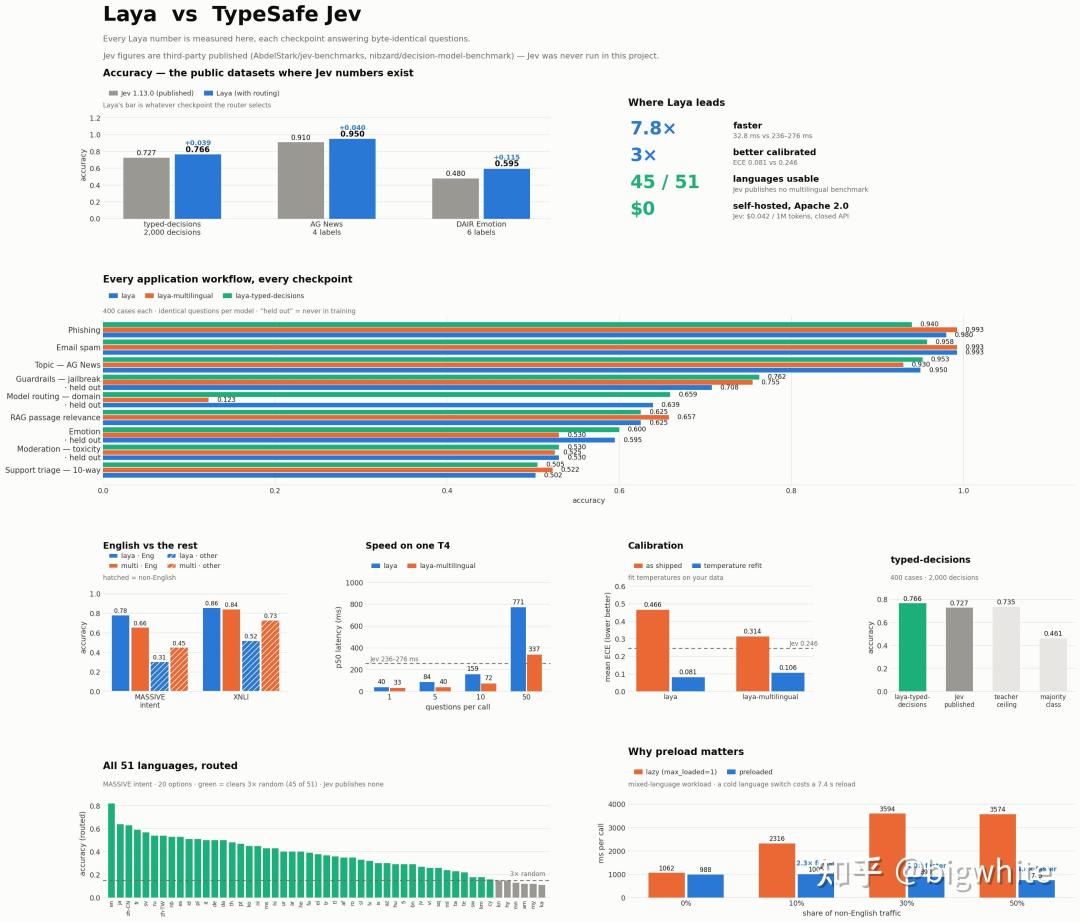
但微博博主美泡君在真机上跑了个对照:100 条消息判断,Jev 100/100 全对,Laya 只有 53/100。 Laya 自己也承认几个硬边界:基础模型不微调,准确率接近瞎猜;超过 20 个选项就打不过 Jev(Banking77 测试 0.425 vs 0.870);高棉语上英文 checkpoint 准确率 0% 但置信度 95.2%——置信度门控救不了,必须推理前路由。微博知乎
知乎上对 Laya 的评价反而比较正面:敢把"我的基础模型接近随机"写在显著位置的项目,比把分数放大到首页的可信得多。 决策赛道的问题,也从"要不要买 API"变成了"开源还是 API"的经典选型题。知乎
什么活真适合它,什么活会翻车
适合的,全是"高频、边界清楚的小判断":模型路由、Agent 要不要继续执行、工单分类、内容审核、输出质检、大数据打标。LangChain 拿它当裁判(Jev-as-a-Judge)跑了实验:0.44 秒/次、$0.00035/次,100 次重复评分稳定性突出。 最出圈的玩法是 Jev + GPT-6 Astra 组队,8 分 43 秒速通《我的世界》击杀末影龙,总账单 $0.97——131 次 Jev 决策加 35 次 Astra 调用;人类随机种子世界纪录是 6 分 39 秒,普通玩家平均约 90 小时。知乎新智元
翻车现场也很典型。知乎网友 Karminski 拿迷宫对抗测试:纯随机数发生器 892 步、不到 300 毫秒就通关,Jev 跑了 2306 步,其中 2295 步困在同一个拐角原地打转到超时——给了历史轨迹和启发式都不听。 他的结论:Jev 是极速单步结构化判断器,不是规划器。写作聊天、数学证明、代码生成这些重推理活更不用想,数学推理"顶多 GPT-4 水平",强监管领域(金融、医疗、法律)还有可解释性合规问题。Hugging Face 研究员 Niels Rogge 也被这波热度惊到了,直呼我们是处在泡沫里。知乎极客公园
普通玩家现在值不值得花时间
好消息是门槛基本为零:9 月 21 日 Jev 已废除候补名单全面开放,邮箱注册就送 $5 额度,约合 1.2 亿 token——按输入价算,够你跑几万次判断。 接入方式任选:官方 Playground 在线体验、Python/TypeScript 一行安装、HTTP 直连,第三方走 Vercel AI Gateway、Cloudflare Workers AI 或 OpenRouter,价格与官方一致。爱范儿
我的建议按人群分:
如果你有具体的高频判断场景(工单、审核、打标):值得立刻花一小时试,反正 $5 不要钱。重点测两件事——你的场景里它的阈值抖动有多大、和你在用的便宜小模型差几分。别只看准确率总分,看阈值附近的方差。
如果你只是个人用户、想让它帮你写东西:省省,它不输出文本,这个产品不是给你的。
如果你是端侧/隐私党:别急着接 API。Laya(421M)加 Kaggle 免费微调是更对你胃口的路;再等等类似 NanoJev(Qwen3-0.6B 底座,2GB 内存手机可跑)的开源复刻——已经有人把轻量决策架构移植到苹果 ANE,内存占用 800MB、60FPS、功耗降 64%。知乎
如果你担心这又是一波泡沫:记住开发者 Harsha Gundala 的狠话——他们隐身开发了两年,我隐身开发了两个小时;他用 Qwen2.5-1B 两小时零训练就拼出了复现版。 真正没被复现的只有 RLCD 校准层,这层到底值不值一家公司,接下来三个月看第三方基准就知道了。极客公园
最后给个观察清单,什么时候这波从"热闹"变成"真趋势":一是出现第三方复现的校准数据(说 90% 对就真九成时候对);二是大厂在模型路由层面跟进同类原语;三是你自己的账单里 token 成本真的开始疼了。在那之前,把"快 193 倍、便宜 444 倍"当营销文案看,把 64% 完整准确率和 1.99/2.00 的阈值抖动当工程事实看——这两件事同时成立,就是这周 AI 圈最值得学会的一课。