













20
24
自媒体录音整理有多耗人?聊聊音频转写里那些踩不完的坑
2026-09-22 20:59:40
0点赞
0收藏
0评论
做内容久了,录音几乎是日常标配:访谈对话、即兴口播、多人圆桌交流,很多想法来不及写稿,就先录下来,想着之后整理成文字再打磨。可真正上手处理音频,才发现看似简单的 “把声音变成文字”,藏着一堆消耗精力的痛点。
最头疼的永远是复杂环境下的识别问题。线下访谈难免有环境杂音,背景里的人声、环境噪音混在录音里;再加上日常说话不会像播音员那样字正腔圆,带一点地方口音、口语化的口头禅、语速忽快忽慢,机器很容易把词句识别错。尤其是行业里的专属说法、圈内术语,同音错字层出不穷,最后拿到的文稿错漏一堆,要逐句对照音频反复校对,有时候十分钟音频,校对就要花半小时以上。
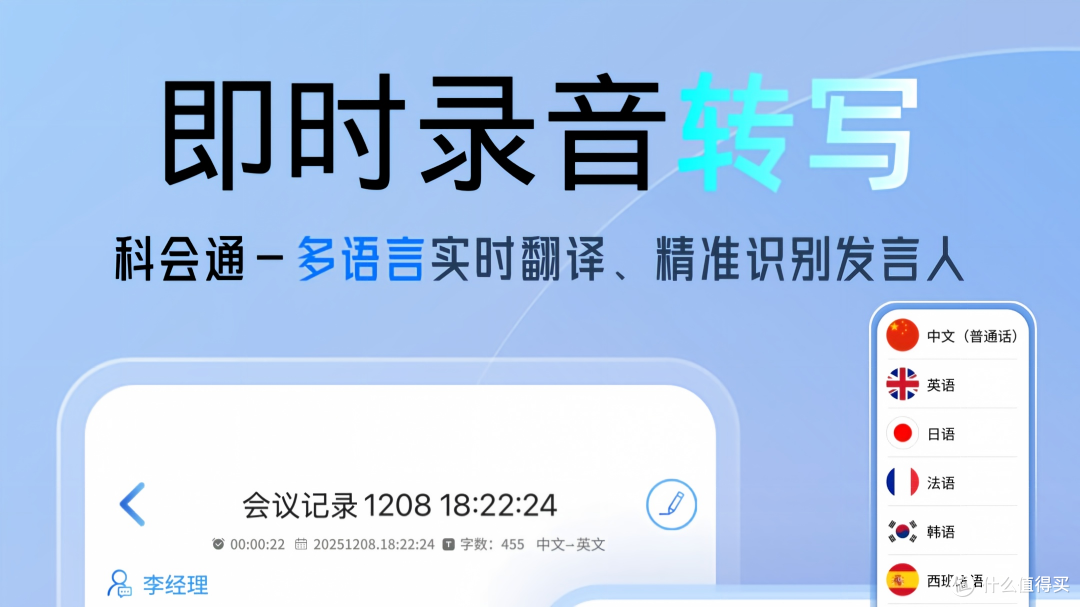
多人对话场景更是重灾区。几个人一起聊天讨论,声音交替重叠,没有清晰的分界。原始转写文稿全部堆在一起,分不清哪句话是谁说的。想要梳理对话脉络,只能一边反复拖动音频进度条,一边手动划分发言段落,分段、标注发言人的过程非常繁琐,多人长访谈经常卡在这一步。
跨设备办公的创作者,还会遇上文稿同步的麻烦。很多时候录音是出门用手机、平板随手录的,回到电脑上再整理文稿。有的工具只能单端使用,音频文件、改好的文稿没法自动同步,需要手动来回传输文件;有时候手机上改完一段文字,电脑端看不到更新,得反复刷新、重新导入,打断整理思路。
还有不少工具的使用体验会打断创作节奏。有的基础转写要等很长时间,音频上传之后必须停留在页面等待处理,切出去别的页面就容易中断任务;也有一些免费额度有限,或者导出文稿要额外看广告,临时急用的时候处处受限。
也有不少人会考虑完全本地处理的方案,不用上传音频。但这类方案门槛很高,需要自己搭建运行环境,没有代码基础很难独立部署,而且大多只能输出纯文本,缺少在线校对、标记重点的功能,转写完成后还要导出到别的文档里修改,流程链条拉得很长。
我们整理录音,本质目的是解放精力,把时间留给脚本创作、内容策划,而不是耗在反复听音频、改错别字、拆分对话这种重复性工作上。
没有一套方案能适配所有人。如果以中文访谈、口播录音为主,经常在手机、平板、电脑之间切换,优先选择识别适配口语方言、支持发言人自动区分、多端同步流畅的一体化工具;如果在意数据本地留存,能接受较高的学习成本,再去尝试本地部署方案;团队有大量内容摘要、语义梳理需求,则可以侧重大模型能力更强的产品。
选工具的核心,从来不是追求功能最多,而是看它能不能解决你最常遇到的那几个录音整理痛点,减少无意义的重复劳动。