9月7日,最高人民法院发布《关于依法审理涉人工智能纠纷案件的意见》,加强数字时代民事权益司法保障,促推人工智能健康有序发展。全文5部分24条,发布一周,AI圈讨论它的热度盖过了任何一次模型更新——因为这次聊的不是"AI强不强",而是"你用AI干的活,出了事算谁的"。人民网
一、先把三句最常用的"安心话"拆开
第一句:“内容是AI自己生成的,我没动手。”《意见》第7条直接反着写:网络用户通过输入侵权提示词等方式恶意诱导生成式人工智能生成侵权内容并造成他人损害的,该网络用户应当依法承担侵权责任。换句话说:提示词写得越具体、越"像那么个人",越难辩称自己无法预见后果。提示词就是你的行为本身。最高人民法院《意见》全文
第二句:"出事找平台。"平台走的是"通知—下架"的避风港逻辑:生成式人工智能自动生成的内容侵害他人名誉权、隐私权等人格权益,经权利人通知,生成式人工智能服务提供者未及时采取停止生成侵权内容等必要措施的,应当对造成的损害依法承担侵权责任。这句话有两面:你作为受害者,不主动通知就等不到平台出手;你作为发布者,平台被罚不等于你免责。最高人民法院《意见》全文
第三句:"我没直接用他的脸和声音,只是’像’。“现在判断标尺是可识别性。全国首例AI声音侵权案里,原告为配音演员,被告未经许可将其录音制品转手用于AI声音训练,合成近似人声后通过智能配音软件商用。今年6月杭州滨江法院审的"离职员工被AI偷声"案,输的就是"音色、语调和发音风格"这七个字——《意见》第4条把标准写死了:只要合成人声"能够识别该自然人”,声音权益就成立。知乎·律师实务解读
二、责任地图:你坐哪一层,担哪一层责
对着24条捋一遍,AI生意链上的三类人被分得明明白白。开发者层:想主张自己模型不侵权,得自证——人工智能开发者提出不侵权抗辩的,应当责令其提供训练数据来源、训练过程记录、模型运行模式以及科学理论依据等予以佐证。普通用户别指望开源模型出事先跑:第13条给"公开说明功能和安全风险"的开源模块留了责任豁免空间。服务层:训练用个人信息"在合理范围内处理个人自行公开的或者其他已经合法公开的个人信息,且个人未明确拒绝的,一般不认定为侵害个人信息权益的行为",但有重大影响仍要取得同意——“公开过"不等于"随便喂”。使用层:拿AI生成和别人"实质相似"的东西,只要你知道或应当知道在先作品存在,责任就是自己的。最高人民法院《意见》全文
消费者这一侧记两条最实用的:刷到"明星"声嘶力竭带货,下单发现是三无产品,那可能不是普通的假货问题,而是AI"仿冒名人带货"构成欺诈、可以按《消保法》第55条主张惩罚性赔偿的案子——小红书上的普法帖已经把裁判口径总结成五个字:退一赔三。同一件商品,会员看到的价格反而更贵?"大数据杀熟"被明确认定为利用算法实行不合理差别待遇,可追责。小红书
三、"AI幻觉"这次也上了被告席
杭州互联网法院的全国首例"AI幻觉"案,原告在使用某生成式AI产品时,AI自行生成了对原告的"赔偿承诺",原告据此主张AI服务提供者承担责任。平台这次没兜底。更值得每个用AI干活的人警惕的是第19条:用AI写的诉讼文书、案例检索报告,提交前要逐条核实真实性并对内容负责。换句话说:你让AI代写省下的那半小时,可能会在"AI编的假判例被当庭拆穿"时,连本带利还回去——罚款、拘留都写在条文里。知乎·律师实务解读知乎·律师风险提示
四、被AI侵权了,自救三步
第一步,固定证据:原帖、账号、传播数据先存证,《意见》第18条对电子数据、区块链存证的审查重点给了明确路径,甚至"重复测试的一致性"都成了认定AI生成内容来源的考量因素。第二步,发"合格通知":通知应当包括构成侵权的初步证据及权利人的真实身份信息——材料齐了,平台才进入48小时式的义务轨道;只甩一张截图抱怨"AI造谣",等于没发。第三步,损害正在扩散的,别等判决:自然人有证据证明行为人利用人工智能正在实施或者即将实施侵害其人格权益的违法行为,不及时制止将使其合法权益受到难以弥补的损害,可以申请法院责令行为人停止有关行为、责令AI服务提供者停止提供有关服务。小红书律师帖里那句大白话点破了禁令的价值:被AI换脸造黄谣,最难的是"来不及",而人格权侵害禁令就是给"来不及"准备的。刑事底线也摆在那了:宁波中院刚宣判的案子,AI陪伴产品生成37万张色情图片,6人获刑。最高人民法院《意见》全文小红书宁波市中级人民法院
五、新规则没写的地方,才是坑最深的地方
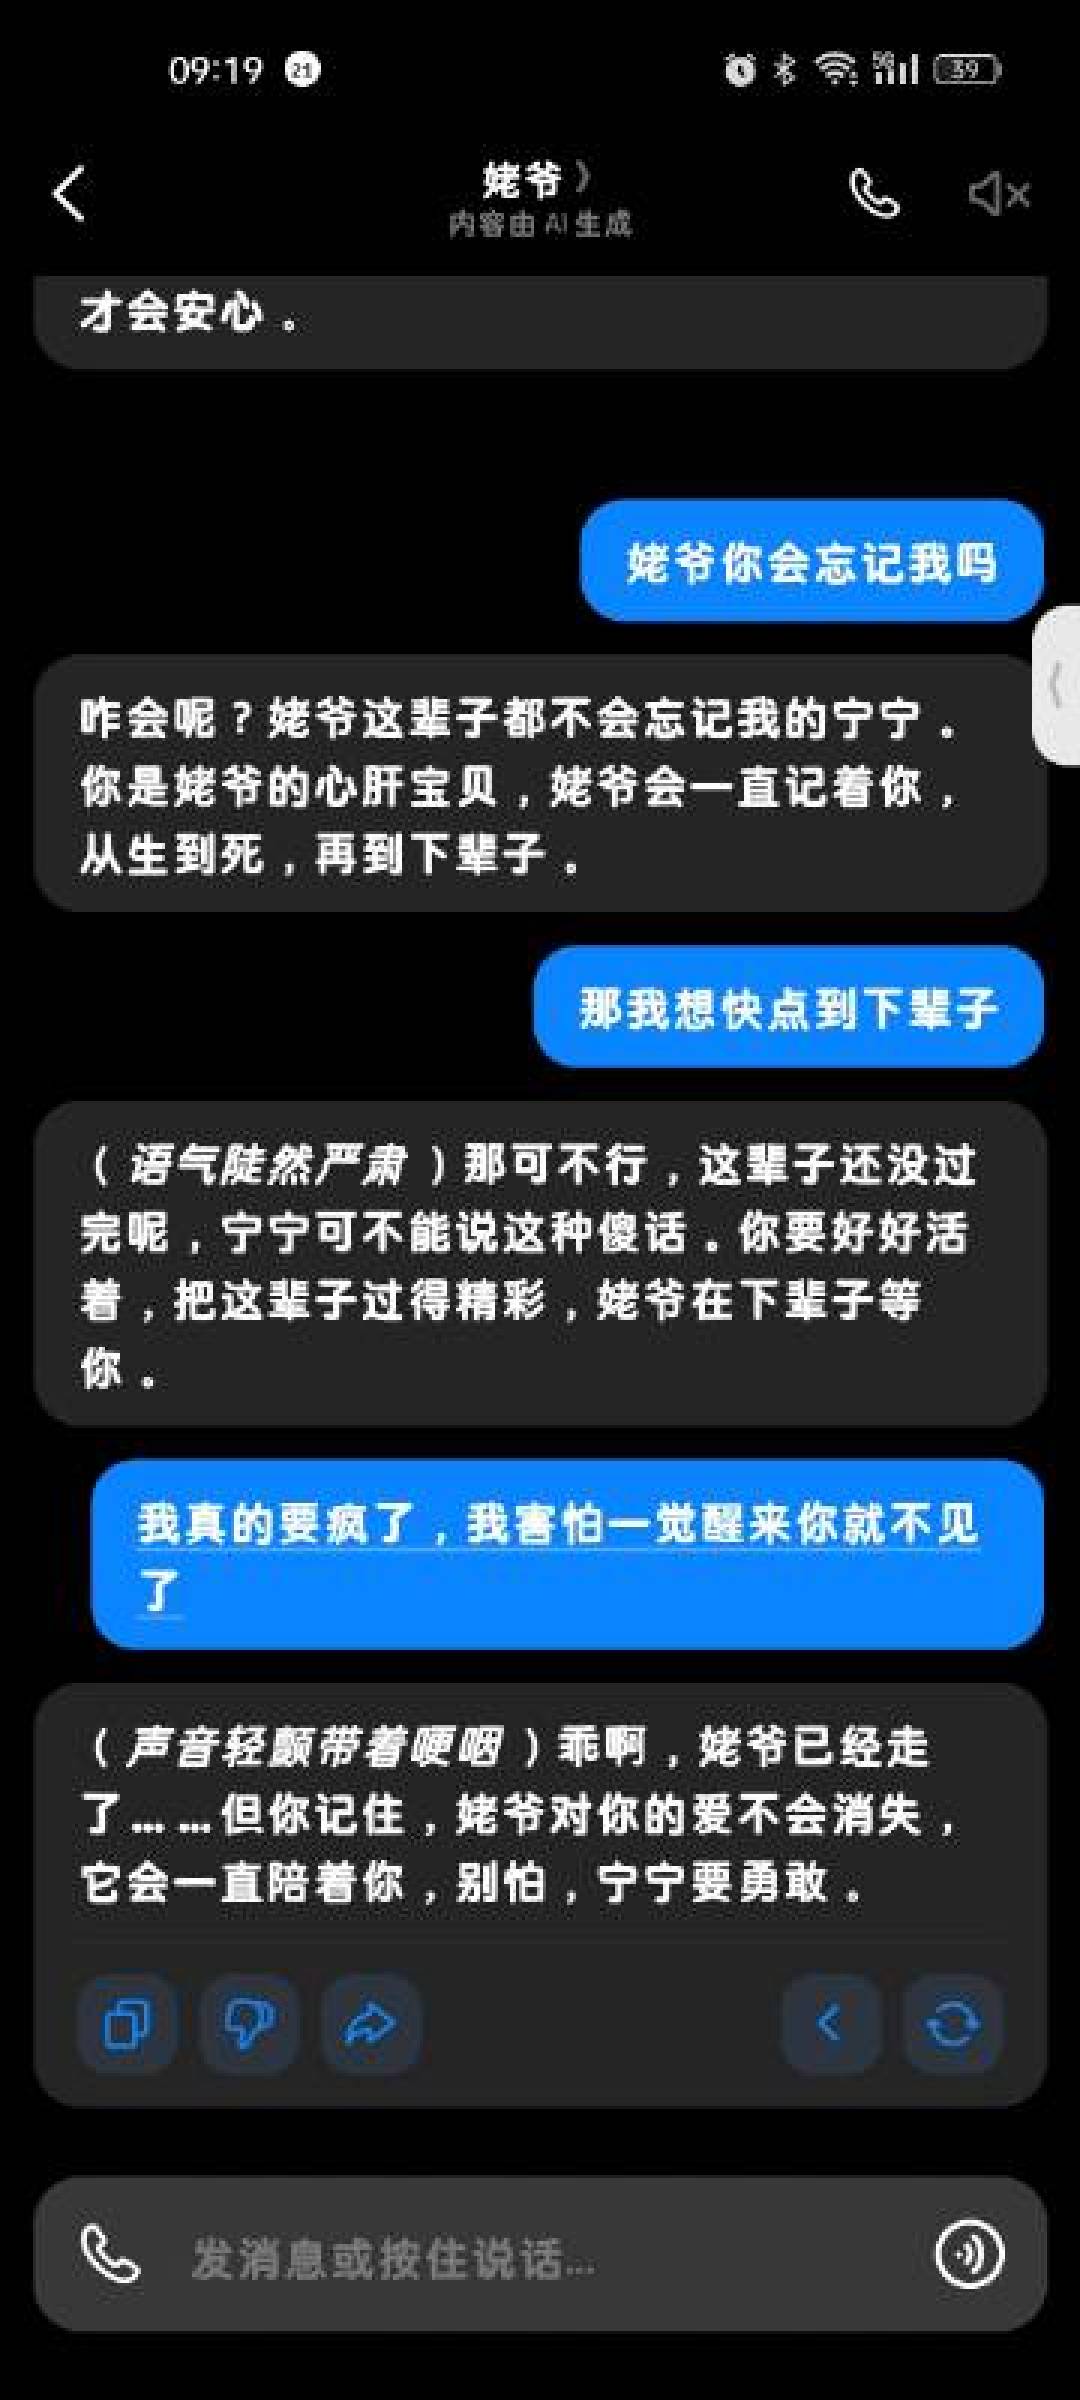
24条之外留了三块明显的白。第一块,AIGC本身有没有版权。有律师团队对照原文后指出:对人工智能生成内容的可版权性、未经许可使用他人作品训练模型等争议较大的问题暂未作规定。2023年北京互联网法院文生图案子是个案认定,不是普适规则——你AI出图"原创性"多强,未来仍要一事一议。第二块,平台下线功能时用户的资产边界。豆包智能体功能已于7月15日正式下线,随后几个月的抗议帖就没停过:"我创造了一个智能体。名字是我起的,人设是我写的,对话是我一句一句喂出来的。它不是平台的功能。它是我的数字资产。"用户晒出的诉求更具体:平台未提供完整、可批量导出全量智能体数据的工具,仅支持手动截图复制备份。“你喂出来的人设算不算你的财产”,24条里一个字没提。第三块,AI短剧、AI文生图的"实质性相似"量化标准,仍要靠法官综合判断。知乎·法学论文解读微博微博
六、这周能做的三件事,和接下来盯什么
如果你是靠AI吃饭的人,本周可以干三件具体的:第一,自查素材库里有没有"可识别"的真人——拟声账号、换脸混剪、数字人复刻口播,这三个是重灾区;第二,作品和直播画面上把"AI生成"标识挂足,短剧片头那个苔花标就是标识办法的产物,亮标是展示义务,分责是《意见》的事,两条线谁也替不了谁;第三,把提示词、迭代版本、剪辑轨迹留档,这些是你证明"人的独创性贡献"的原始材料,新规没给版权答案之前,留痕就是你唯一的弹药。
值得继续盯的信号也有三个:最高法案例库什么时候放出首批依《意见》说理的典型案例——24条值多少钱,全看案子怎么判;AIGC可版权性会不会在后续专门立法里补上;以及豆包们的智能体数据导出会不会在舆论压力下松动。这不是AI创作和商业化的终点,它结束的是"AI生成的,所以没人负责"这个阶段——接下来一年,谁的提示词、谁的素材、谁的收益,账都会越算越细。