9月15日,量子位报道了一件事:北京中关村学院的7名博士生,用一个暑假从零训出7.39B稠密大模型ZGCM-1,然后把各阶段权重、中间checkpoint、训练代码、分阶段数据与配方、W&B日志全部开源。GitHub仓库、HuggingFace模型和数据集卡片当天就能下载,arXiv技术报告(编号2609.13356)里连并行配置、每卡吞吐、事故记录都写了。量子位arXiv
炼丹圈看到"从零训7B"第一反应通常是两件事:钱够吗?人够吗?这篇值得停下来,恰恰是因为它把这两个问题第一次完整摊开在桌面上——而且给出了一个反直觉的答案:人不够,这个暑假是被几百个Agent填上的;但Agent顶到了哪一格、哪几格顶不动,报告里评级写得明明白白。知乎
先把账算出来:这是一炉"学校级"的丹,不是"家门级"的
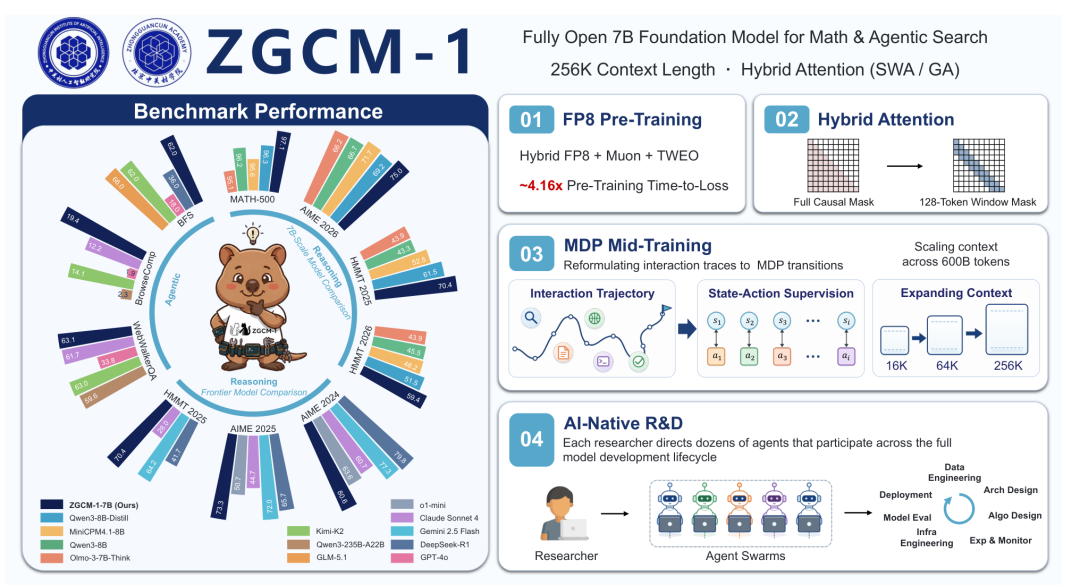
报告给出的硬数字:预训练约4.19T token(Stage 1课程学习0.99T + Stage 2完整混合3.20T),中期训练约600B token,上下文从16K逐级扩到64K、256K。硬件是H100集群,16K预训练生产跑的并行配置为TP2/PP1/CP1/DP96,合计192卡,每卡稳定在约585 model TFLOP/s——对H100的BF16密集峰值算,约60%等效MFU。GitHub
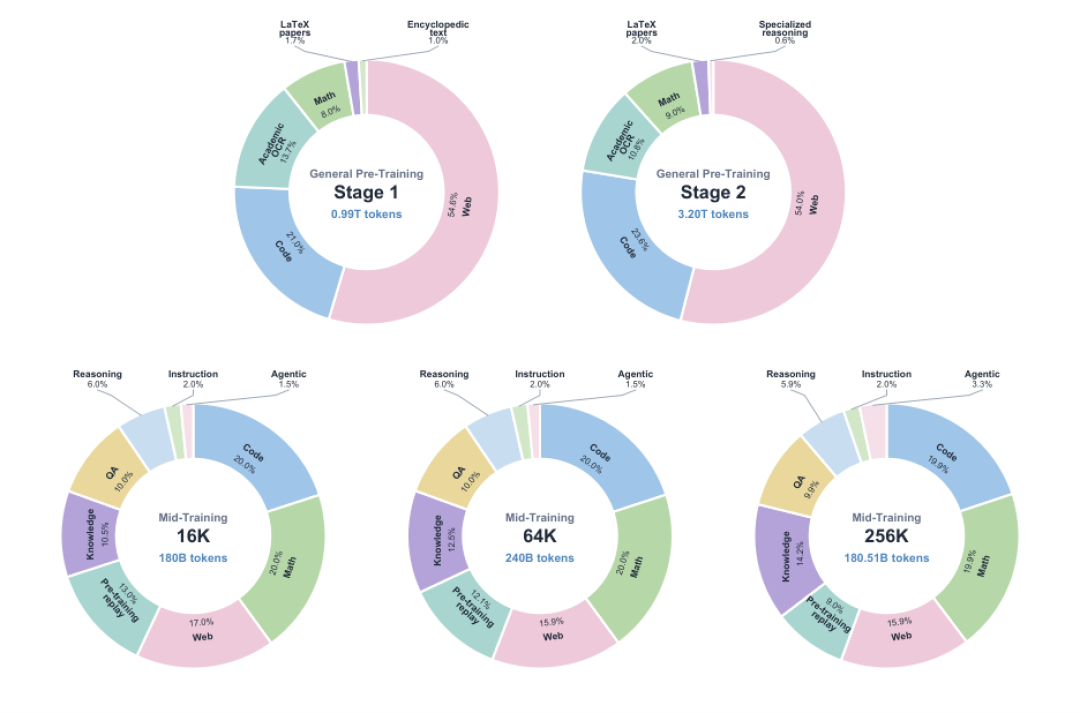
按6×参数量×token数的标准算法换算:4.19T token × 7.39B参数 × 6 ≈ 1.86×10²³ FLOPs,除以585 TFLOP/s/GPU,预训练一项约8.8万H100卡时;192卡满负荷跑,约19天。这还只是最贵的单项:中期训练、SFT、RL、消融实验另算,总账只会更大。注意两点:一是这个吞吐是FP8+Muon把效率堆上去的结果——报告称同等loss下16K预训练比OLMo 3式BF16/AdamW基线快约4.2倍,256K下混合注意力比全注意力多3.94倍吞吐、KV Cache降到约1/6;二是"约19天"意味着不是租19天卡就完事,数据、清洗、调度、故障重启都发生在这19天的缝隙里。 所以这炉丹的正确定位是:学术级。对个人炼丹党,它不是"我下暑假也来一炉"的可行性证明,而是"完整配方+全量日志第一次可以逐行抄"的资源证明——8.8万卡时你大概率凑不齐,但0.3B代理模型搜数据配比、分阶段课程、FP8稳定性这套方法论,一块消费级卡就能照着跑通。量子位
几百个Agent到底干到了哪一格:99次评级,只有1次给了L5
比"7个人训出7B"更值得细读的是报告第6章:他们把研发拆成11类任务(数据清洗、数据获取、合成数据、架构设计、算法设计、实验与监控、基础设施、评测、部署等),请9名核心参与者按L1–L5自主性框架逐项打分。共识结果——知乎
层级 | 任务 | 含义 |
|---|---|---|
L4 | 实验与监控、部署工程 | 人给定目标与约束,Agent独立规划、执行、按反馈迭代 |
L3 | 其余7类任务 | Agent能自适应干活,但关键决策要人批 |
L2 | 模型架构设计、学习算法设计 | 只做既定方案的实现和预设实验,且9人打分里没有一项高于L3 |
全部99个打分中仅1个L5,没有任何任务被评到L4以上。报告特意强调:这是贡献者主观评级,不是标准化测量。但即便是主观的,分布也足够说明问题:AI4AI当前吃掉的是"运维+执行",没吃掉"研究品味"。人剩下的工作是提目标、设约束、做关键判断——以及他们自研ZGent平台干的事:把会议讨论、决策沉淀成共享上下文,把验证过的脚本、debug经验沉淀成可复用Skill,后加入的Agent接着前人经验干活。arXiv
上个月大家还在讨论某大厂押注全自训练能省多少,这7个人用一个暑假给出的工程结论更接地气:流程里哪几格已经能外包给Agent,哪几格外包了会出事。
loss会骗人:三个坑值得直接抄进你自己的checklist
有了Agent团队,该翻的车一辆没少。报告里的事故记录,恰好是个人炼丹最容易原样踩中的:
坑一:曲线正常,能力退化。一次训练loss持续下降,模型能力却明显退步,最后追到底层数据分片和shuffle环节——实际进炉的数据比例在波动,模型吃进去的并不是配方上那份。他们此后的做法:更密地保存checkpoint、直接评测基座能力,并建了ACE原子能力评测——18类能力、183项、2503个探针,86%用确定性判分,一轮内部诊断两三分钟。启示:只看loss和验证集是不够的,能力探针要跟着checkpoint走。量子位
坑二:数据配比靠拍脑袋。他们在0.3B代理模型上烧约30B token迭代搜配比,loss和各域评测信号反馈调整后再定7B配方;课程阶段把通用文本按词汇复杂度从易到难排序,代码、数学单独交织——对照实验里coding的BPB从随机顺序的1.99降到0.81,但MMLU这类通用评测反而略升0.03–0.09 BPB,课程加速的是特定域,不是万能。
坑三:SFT数据宁缺毋滥。同一基座、同一任务池,按过滤严格度分三档做对照:只做格式规范的、去掉差评样本的、只过最严质量关的——最严格档效果最好。这条基本推翻"数据量堆上去就行"的直觉。
“打平Qwen3-8B、敢碰235B”:这话要按报告的原文理解
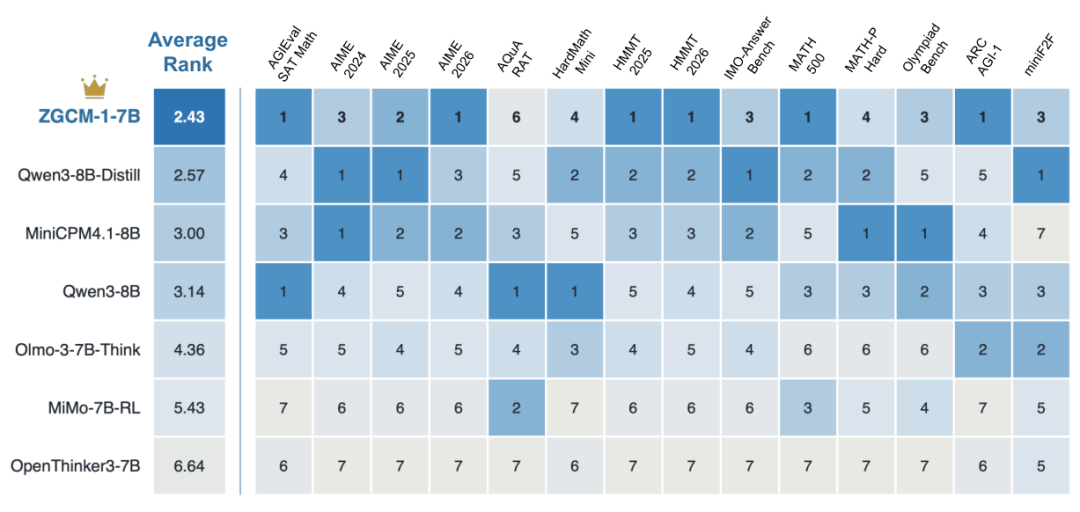
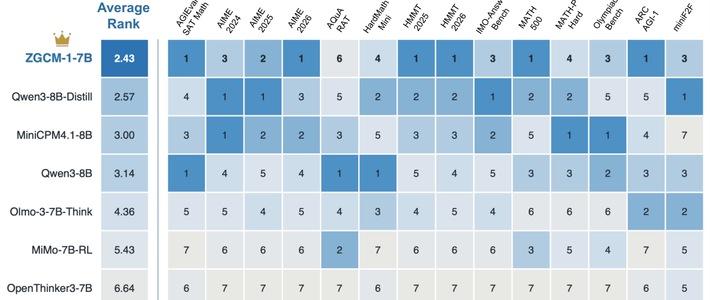
评测部分保持清醒。ZGCM-1确实强:MATH-500拿97.13%,AIME 2026拿75.00%,HMMT 2025拿70.42%,是报告14个推理benchmark对照的7B–8B组里平均名次最好的。但"相近""比较"不等于碾压:AIME 2024上它80.62%,低于DeepSeek-R1蒸馏Qwen3-8B和MiniCPM4.1的83.33%;"可与Qwen3-235B-A22B、GLM-5.1比较"仅指部分数学推理和agentic搜索评测。BrowseComp 19.43%、GAIA纯文本42.52%——能跑多步工具链是真本事,离"小模型吊打大模型"很远。报告自己的Limitations第一条就写着:7.39B的静态知识容量有硬上限,闭卷、强记忆型任务天然追不上大得多的模型。它的核心命题本来就是:装不下的知识,靠多想+主动搜索补。GitHub量子位
谁该收藏、谁该绕路
带学生做全链路、或在评估"下一个项目要多少人多少卡"的研究者:这篇报告是目前最完整的"人数×算力×Agent分工"实证,8.8万卡时、192卡、7人、3个月四个数放一起,就是你的预算下限模型;ACE探针体系和checkpoint级评测是能直接抄的工程件。
还在消费级卡上炼丹、做过LoRA/SFT的进阶玩家:别抄4.19T,抄它的路径——0.3B代理搜配比、三档SFT数据质量对照、能力评测前置。先参考MiniMind这类4块钱两小时训64M的仓库把全链路跑通,再谈规模。微博
看热闹的:记住一条就够——这炉丹最值得吃的不是分数,是那套全开源的日志和配方;至于"7个人=大厂几百人团队",报告自己承认:设计那几格,还是人在干。
接下来盯三件事:复现者用同一配方在更小算力上能复现出多少;社区基于ZGCM-1权重继续训练会不会出现"蒸馏禁令"之外的第二条自训练路线;以及团队说的"下一步探索更大规模",什么时候来、要多少卡。
(文中卡时为按报告token数与每卡吞吐的换算估计,未计注意力开销与非满负荷时段;评测数字引自技术报告表格,含团队自述的适用条件。)