11月3日,科创板日报报道,DeepSeek 下一代大模型 V5 计划基于昇腾芯片进行预训练。报道还提到,此前昇腾在 DeepSeek 体系里主要承担推理。微博
财闻的说法更具体:V5 的核心训练算力是昇腾950,项目指向明年落地,双方的核心研发对接团队常驻杭州。知乎
把这两句话放在一起,变化才清楚:以前是模型训完,再放到昇腾上跑;现在要把“训”这一步也搬过去。
这一步比看上去难。推理可以切分、排队,卡多了就是吞吐大;训练更像一条生产线,几万张卡在几个月里只做一件事,任何一处停顿,全线都要等待。36氪
卡数越多,一次故障拖垮整轮训练的概率越高。通信库、故障恢复、调度这些工程能力,比单卡峰值算力更决定成败。
DeepSeek 为这一步铺了很久。9月30日,它开源了面向昇腾的基础设施组件,编译工具、计算库、通信库与英伟达版本一一对应。知乎
更早的验证在后训练环节。深圳河套学院等团队用昇腾910C集群完成了1.6万亿参数 V4-Pro 的全参数后训练,但那次仍不涉及基础预训练。半导体产业纵横
硬件这边,昇腾950DT 的 FP8 算力约1PFLOPS,约为英伟达B200的两成多。36氪
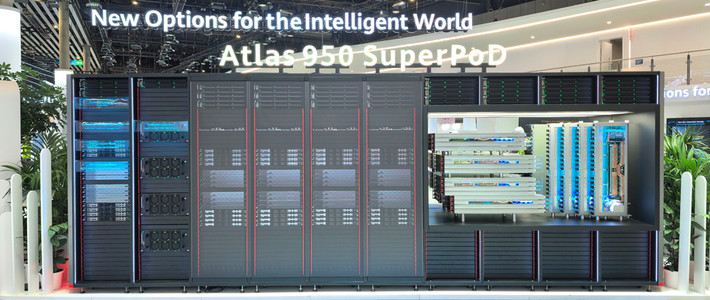
单卡弱,就用集群补:1024卡的昇腾950超节点支持统一内存编址,面向万亿级模型训练。第一财经
代价是卡数。要凑出同等算力,昇腾需要的卡数约为英伟达方案的四到五倍。机房、供电、运维也会跟着放大。36氪
真正的约束在产能。950DT 的规模供货要等到今年年底或明年年初,卡住交付的又是 HBM。知乎
长鑫的 HBM3E 比国际三强落后一代,上一代 HBM3 的综合良率估计只有25%左右。训练集群还要面对万卡级故障恢复和通信调优。36氪
所以“明年落地”是一个很紧的时间表。报道本身也留了口子:确切时间取决于模型训练进度。
报道里有个容易被忽略的词:“核心训练算力”,不是“全部训练算力”。V5 仍可能采用混合集群,昇腾承担其中一部分。
如果跑通,它回答的是一个此前没有答案的问题:中国顶尖大模型能不能在国产算力上完成预训练。36氪
这比“又多了一个国产芯片适配”重要得多。适配是让模型跑起来,预训练是让模型从零长出来,国产芯片的角色也会从推理支撑变成训练主力。
但在此之前,它仍然是一个计划。消息来自产业链人士,不是双方公告,参数、能力和发布节点仍是内部信息。微博
接下来要看的是950DT的实际交付、超节点的集群稳定性,以及V5的训练有没有按节奏推进。