今年双11,迷你主机的吆喝声变了。以前大家问的是“3A大作能不能跑”,现在问的是“大模型能不能跑”。
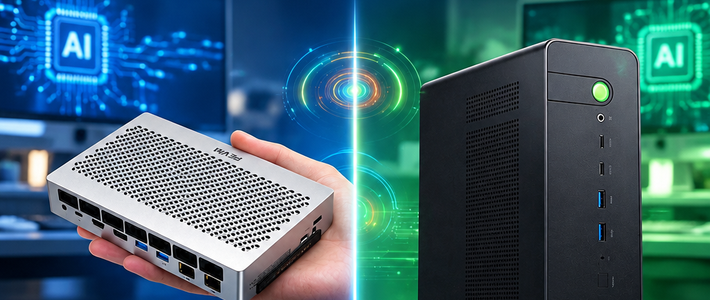
10月9日,极摩客联合AMD和京东在深圳开了场发布会,主角是一台书本大小的EVO-X5 Pro:192GB统一内存,号称能本地离线跑3200亿参数的大模型,首发价46999元。紧接着,奋微FAEX2也杀进擂台,两台同为AI Max+ Pro 495处理器加192GB内存,标价差了4400块。AMD自家的Ryzen AI Halo同样已在海外开卖,官方定价6799美元。迷你主机集体转身,变成了“AI超算中心”。知乎哔哩哔哩知乎
是真需求还是噱头?别急着下结论,下手前先把这三笔账算清楚。
第一笔账:装得下吗
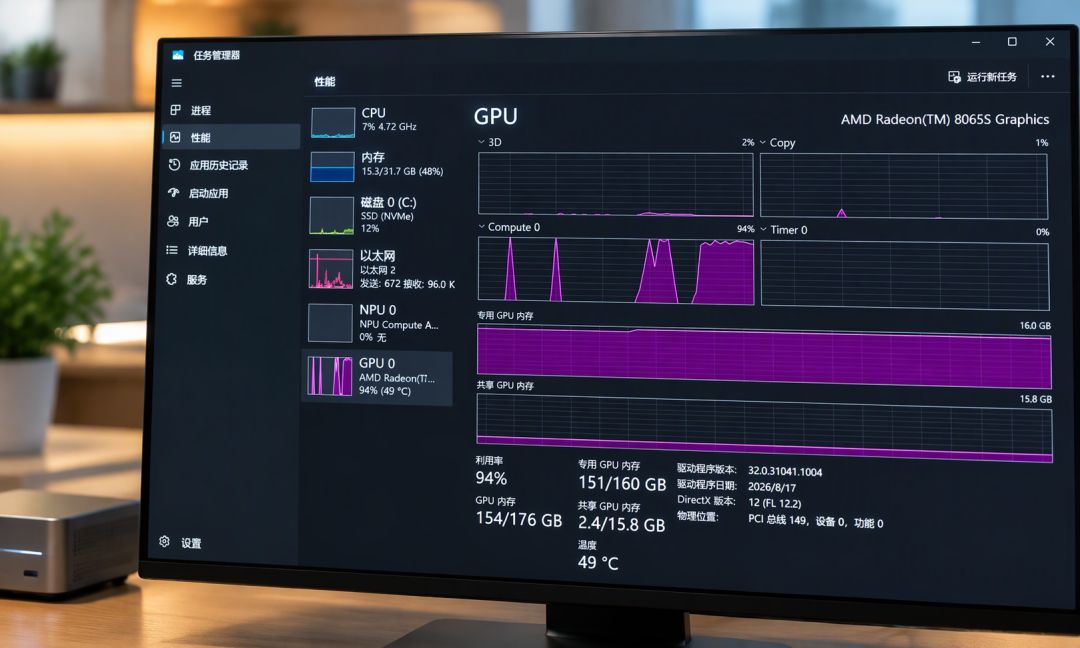
敢在本地跑大模型的底气,来自统一内存——CPU和GPU共享一个大内存池,装进内存的都能当“显存”用。4bit量化下每1参数约占0.6字节,320B模型的权重逼近190GB。上一代锐龙AI Max+ 395最高只支持128GB,实测里DeepSeek-V4-Flash在395机器上根本启动不了。这就是新款AI Max+ PRO 495把内存一口气拉到192GB的原因。知乎知乎
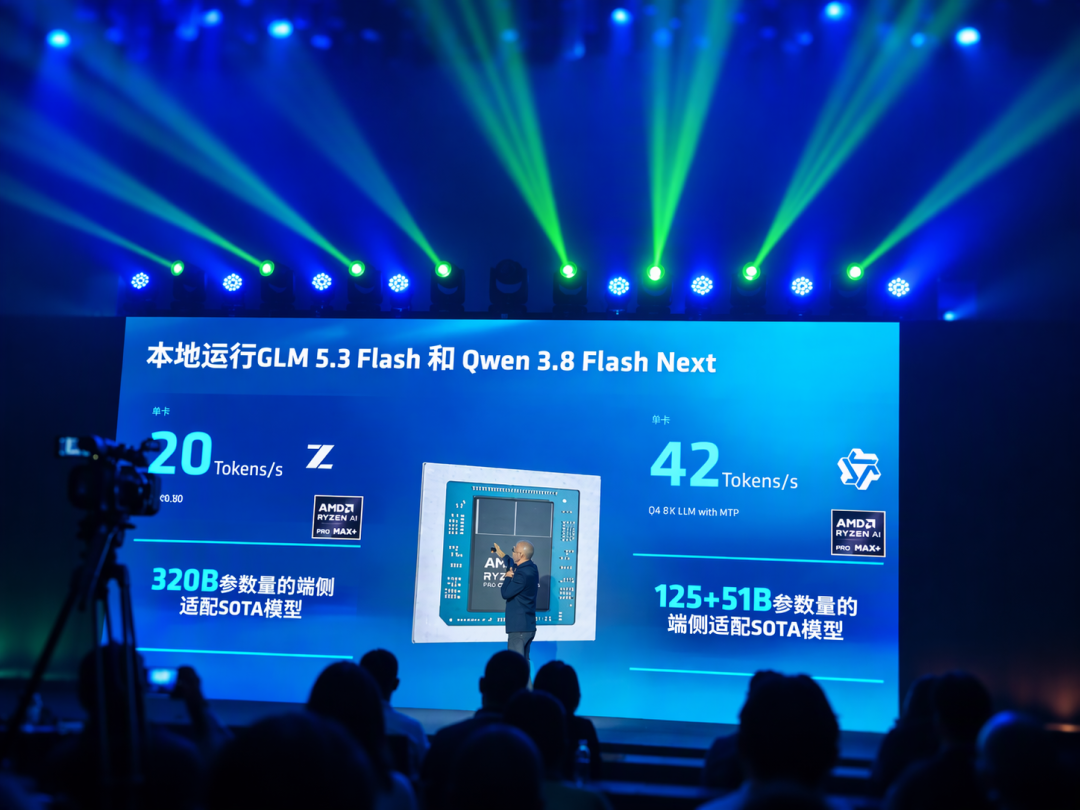
模型也在往这个方向卷。10月底开源的MiniMax M3.1 Flash有4280亿参数,社区量化版被压到了约144GB——128GB的机器塞不进,192GB的机器绰绰有余。这64GB的增量,就是“能跑”与“跑不了”的分水岭。知乎小红书
第二笔账:跑得快吗
装得下只是入场券,出字快慢要看带宽。模型每吐一个字,都要把参与计算的权重完整读一遍,速度上限=带宽÷要读的字节数,和算力几乎无关。495这一代的带宽约273GB/s,发布会受邀博主的实测很说明问题:DeepSeek-V4-Flash级的大模型每秒只出14个token,“能用,但长上下文的首字等待需要一点耐心”。换成轻量的MoE模型Qwen3.6-35B,每秒能出90个token,已接近云端体验。一句话:这类机器适合跑30B级和MoE模型,想高速驱动千亿参数大模型,带宽是物理天花板,调优也改不了。知乎知乎
第三笔账:值不值
192GB的新机适合谁?合规有硬性要求的企业和机构:数据不能出内网的医疗、金融、政企——EVO-X5 Pro预装本地推理环境,46999元开箱即用,省下的是部署人力和云端账单。个人玩家想跑个30B级量化模型玩agent、写东西,不必一步到位192GB:上代395的128GB整机已经掉到2万元上下,阿迈奇M1A Pro+的128GB+2TB卖过19199元,比新机便宜一半还多。至于主要办公、打游戏的你,别为AI溢价买单,核显机型依然更香。知乎哔哩哔哩
最后说两句
迷你主机能不能跑大模型,两年前还是机房话题,现在被塞进了桌面铁盒子里,门槛确实在降。但“能跑”不等于“该跑”。双11被“AI超算”营销带着走之前,先问自己三件事:你要跑什么模型、要多快、你的数据值多少钱。算完账,答案自然就有了。