10月23日,Nemotron 3.5家族的最小成员准时上桌:NVIDIA-Nemotron-3.5-Bolt-E4B-4GB。官方口号很直接——“把自然对话与多轮智能体能力装进低至4GB的内存”,目标场景写的是GeForce RTX、Jetson和RTX/DGX Spark上的快速本地语音助手、交互式游戏角色和嵌入式界面。消息一出,B站和小红书上"老显卡别扔"的教程一天内就铺开了。4G、6G、8G显存的老卡党确实有理由激动:过去本地小模型最大的毛病不是跑不动,是"不会干活"——不听指令、不会调工具。这次英伟达专门训了一个会干活的。知乎哔哩哔哩
但先别急着点下载。名字里的"4GB"既不是文件大小,也不是你要花的钱;官方跑分表里最亮眼的数字,还不是你我实际跑的那个版本拿的。按下下载键之前,把这三个数读完。
第一个数:文件6.18GB、显存3.5GB,"4GB"是目标负载口径
官方Q4_K_M量化版的单个GGUF文件标的是6.18GB(约等于5.8GiB,两个说法差在单位换算,不是两个版本)。名字里的"4GB"指的是目标工作负载下最低约4GB的资源占用,不是让你把一个4GB的文件塞进4G显存。知乎小红书
官方实测条件给得很全,这点比多数跑分海报诚实:RTX 5070(12GB显存)、Q4_K_M量化、batch 1、llama.cpp CUDA、AIPerf测量——3K输入、50输出时显存占用3.5GB,首字延迟548ms,生成速度133.4 tokens/s。注意,这是NVIDIA自己的测试机,没有4GB显卡的实测数据。模型本身是80亿总参、40亿激活(E4B即Effective 4B,和Gemma 3n的命名惯例一致),64K上下文,纯文本输入输出,基座是Gemma 4 E4B-it做后训练。小红书知乎
对你的老卡来说,3.5GB是"净占用",还没算KV缓存随对话变长的增量、系统显存开销,以及你同时开着的浏览器。4G卡党看到6.18GB文件的第一反应应该是:它装不进我的显存,得靠CPU卸载,速度另说。
第二个数:它补的是"工具调用"这块短板,但输在哪也写得明明白白
把官方基准表拆开看,这模型的对位关系很清楚:
对自家上一代Nemotron 3 Nano 4B:工具调用4项基准全部更高,Tau2-Bench从29.2拉到55.1,接近翻倍。这是真提升,说明后训练的方向对了。
对Qwen 3.5 4B:Tau2-Bench 55.1对75.1,BFCL-v3 68.5对70.9,ToolSandbox 68.8对69.5——三项全输,Qwen还是小模型里最能干活的那个。E4B唯一赢的是When2Call-MT(判断该调用工具、该追问还是不该答),63.4对37.8,但官方自己注明这个评测集要之后才公开。小红书
一个关键注脚:上面这些分数全部来自BF16全精度版本的成绩,不是那个压到3.5GB显存的Q4_K_M量化版的成绩。量化版会掉多少,官方没说,要等社区实测。小红书
B站有UP主自测称指令遵从IHEval拿到84.79,同尺寸的Gemma 4 E4B只有67.04、Qwen 3.5 4B是60.57——单项来源,还没被交叉验证,先记着别当结论。小红书首发帖的定性比较公道:它不是"全面赢了同级小模型",而是把显存压到4GB左右的同时,保住了一部分工具调用能力。哔哩哔哩小红书
第三个数:E4B不是这张表的上限,24GB卡党有另一个答案
英伟达这次不是发一个模型,是按内存档位把Agent铺满了全栈:Ultra管最难推理,Lightning管高吞吐,SuperVL(120B-A12B)管企业级多模态常驻,Bolt 74B-A9B压进24GB管桌面日常,E4B管嵌入设备里那一个。所以不同显存的本地部署党,该抄的作业不一样:知乎
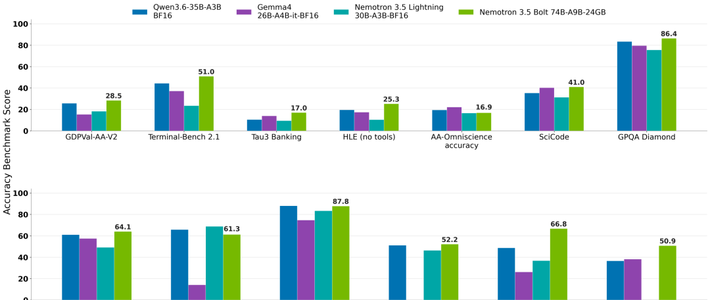
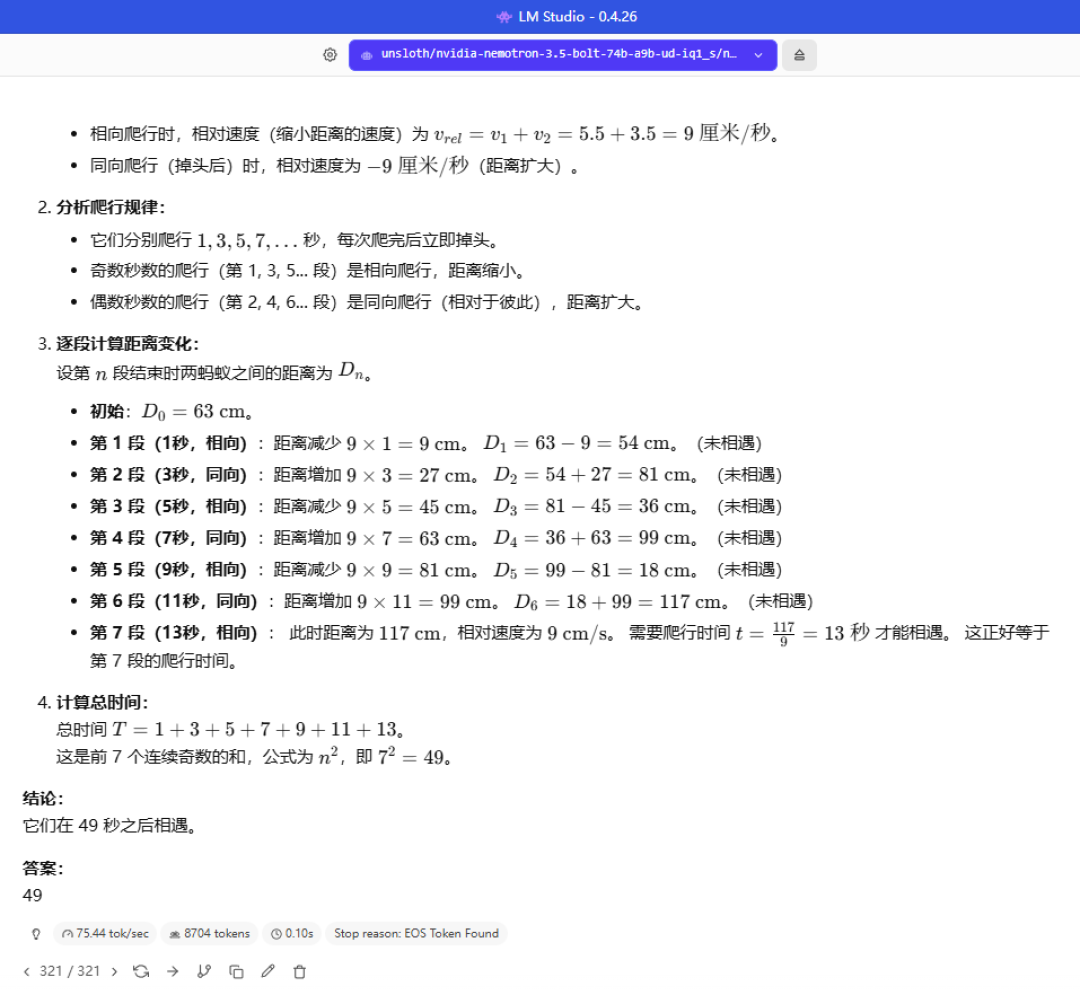
24GB及以上(3090/4090/7900XTX):看Bolt 74B-A9B的24GB档,官方IQ2量化版对比三个BF16对手,12项基准赢9项——Terminal-Bench 2.1拿51.0,对面Qwen3.6-35B-A3B是44.4、Gemma4 26B-A4B是37.2;BrowseComp 66.8对48.7;RTX Spark实测84 token/s。但官方也直说输的两项:AA-Omniscience和非幻觉率,2比特压缩牺牲的正是参数里存的"百科全书"。要知识面别要它。社区unsloth的IQ1_S量化版文件约17.2GB,有人用LM Studio在自己的机器上跑通,GPU占用20.12GB、生成速度75.44 tokens/s,属于"能跑,但离24GB红线不远"的真实水位。知乎知乎
12GB(5070/4070这一档):E4B按官方口径跑起来绰绰有余,就是3.5GB那个数。
6-8GB老卡:官方"低至4GB"口径之内,教程里说插上就能跑,等批量实测再动手。
4GB卡:文件6.18GB,先解决"装得下"再谈聪明。
装完之后:本地助手不免费
首字548ms不等于任务完成。一个"下班前把今天笔记里的待办列出来"的流程,实际是理解请求→生成工具调用→等文件读回→再生成整理结果,每一跳都在加等待。工具调用能力解决的是"模型会不会提动作请求",能不能落到你的电脑上,取决于应用层给多少:文件搜索、权限检查、错误提示,都得你自己搭。建议从最小闭环开始——限定一个目录、只读权限、每条待办带出处,错了也只是建议错,不会替你改文件。
隐私也要沿链路查:本地推理只是模型不出门,如果你的搜索工具接了在线服务、语音识别在云端,数据照样离开设备。
落地的正确姿势
许可是OpenMDW-1.1,商用可用,这点厚道;渠道上HuggingFace、Ollama、LM Studio都写了,社区GGUF在ggml-org和unsloth仓库也有镜像。有个坑必须提:模型发布头两天模型卡还是gated状态,部署栏写着"llama.cpp recipe pending",和研究页"可通过Ollama、LM Studio获取"的说法不一致——装之前再回去看一眼模型卡。小红书小红书
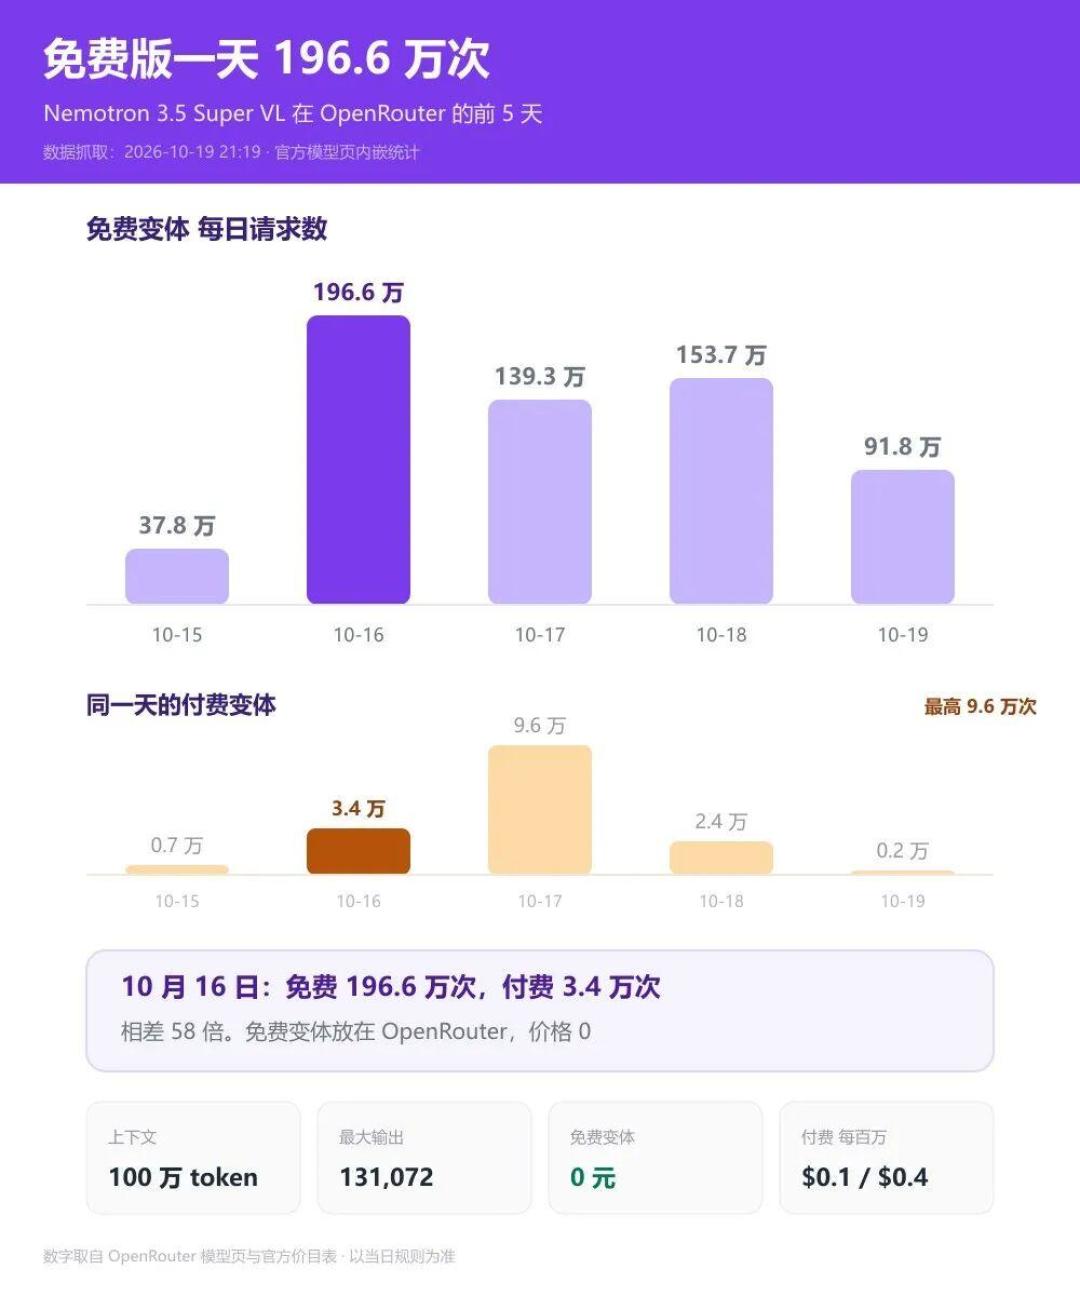
不想先占硬盘的,可以顺着家族在OpenRouter挂出的免费变体端点先试能力,白嫖验证已经是这个生态的标准动作。知乎
下载后的验收动作也给你排好了:先跑通一轮完整工具调用(查库存、改日程这种短流程),确认量化版在你机器上的真实显存和速度,再决定要不要挂那个737MB的DFlash推测解码草稿模型压延迟。复杂长推理、想替70B以上大模型干活的,别指望它。小红书
双11前想看卡的人,这是今年最便宜的"前置考试":先在你现在的旧卡上跑一轮E4B,再决定要不要为本地AI花一分钱。它跑不动的原因如果是显存溢出,你算的是内存账;如果是任务本身就完不成,换什么卡都没用。
值得继续盯的三个信号:官方模型卡补齐llama.cpp配方、给出E4B量化版自己的跑分;6GB/8GB/4GB老卡党晒出交叉验证的实测;还有那个赢麻了的When2Call-MT评测集什么时候真公开——目前它是全表唯一"单方面宣布"的项目。