
















7
8
DeepSeek开源推理引擎:给了一半,缺的三块最要紧
2026-10-20 21:13:12
0点赞
0收藏
0评论
今天 DeepSeek 把内部推理框架 DeepInfer 放到了 GitHub 上,Apache 2.0 协议,默认权重就是它自己线上在跑的 V4.1 Flash。通稿的说法是"大模型普惠",可我翻完仓库 README,看到的是另一句话:这次放出来的是离线推理,一套能对外接客的在线服务还缺三块东西,它自己明写了没放进来。
这件事的看点不在"开源"两个字,而在切开的那条线划在哪。
推理引擎,才是决定成本的那一层
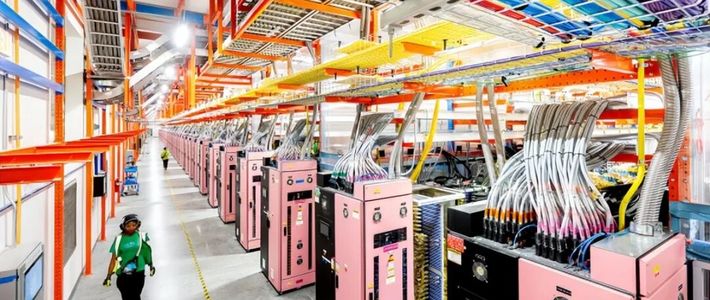
模型给的是能力,引擎给的是单位成本。同一张卡、同一份权重,调度写得好坏能差出一倍吞吐,而压测数字就摆在仓库里:输入侧用 4 张 SM100 就能打满,输出侧要 64 张。
差 16 倍的原因很实在,生成阶段每吐一个字都要把 KV 缓存重读一遍,时间几乎全耗在显存带宽上,算力空着等数据。推理框架干的活因此很具体:把一批长短不一的请求拼成一个批次,算出哪些 token 能复用、哪些必须重算,再决定哪张卡跑哪几层专家。分得粗一点,账单就高一截。
放出来的这一半,参数级都能对上
支持的模型只有一个,DeepSeek-V4.1-Flash。听着窄,但这正是他们线上真正在服务的那一版,不是拿老模型凑数。
并行策略给了 Attention DP 和 balanced CP,MoE 走专家并行加 EPLB,也就是动态重排专家,避免热门专家全挤在一张卡上。解码加速那部分叫 DSpark,走投机解码路线,默认草稿长度 5,用 DEEPINFER_USE_NEXTN_DECODE 可以调。
有个细节挺能说明工程口味:处理超长输入时,它不去重算整段,只回放一个够用的尾巴,默认只保留最后 140 个 token,开关写作 DEEPINFER_YOCO_PREFILL_KEEP_TOKENS=140。
另外两个开关只在 NVIDIA 上生效,一个是批不变推理,同一句话不管跟谁拼在一批里,输出完全一致;一个是确定性采样,固定 seed 后逐 token 可复现。做过评测和回归的人知道,这两个值多少钱。
没给的三块,恰好是最难补的
README 里那节写得很直白,一套完整的推理服务还需要三样,本次不包含:KV 缓存系统、Prefill 与 Decode 分离、数据并行副本之间的负载均衡。
KV 缓存是显存账本,命中率直接决定你能塞多少并发;这套东西各家都自己攒,跟机房拓扑、存储池和请求长度分布绑死在一起,就算开源出来,别人也未必接得上。PD 分离要解决的是两类负载抢同一张卡的问题,拆开之后得有一条独立传输链路搬 KV,工程量大还吃网络。副本间负载均衡平时看不出毛病,长尾请求一来就现形,某个副本堆了两百个超长上下文,其他副本在空转。
所以"全面开源"严格讲指的是引擎本体,不是一套开箱就能赚钱的服务。这不算藏私,更像是把可复用的部分和绑在自己机房里的部分切开了;但对想照抄的人来说,剩下三块得自己补。
顺手支持了昇腾,这步信息量不小
仓库写明的加速卡有两种:NVIDIA SM100 和华为昇腾 950 NPU。编译时导出一个环境变量切换后端,DEEPINFER_ACCELERATOR=nvidia 或者 ascend,两套后端共用同一份调度代码。
这一点比开源本身更值得记一笔。推理框架是最贴硬件的一层,同一套代码能同时喂两家的卡,说明国内的算子库和通信库已经接得住主流 MoE 模型的形状了。
README 的致谢里也承认,它最初主要基于 vLLM 建起来,另外参考了 SGLang 和 TensorRT-LLM。真正属于 DeepSeek 的增量是那几个自研 kernel:FlashMLA、DeepGEMM、DeepEP、TileKernels、DeepSelect。
自建推理栈的门槛,从"看懂几千行 kernel"降到了"补上三块工程"。可这三块里,KV 缓存最不讲道理,它不看你会不会调模型,只看你的机器怎么摆、盘有多快。真打算在自己机器上跑 V4.1 Flash 的话,第一件事不是下权重,是先算清楚缓存放哪、放多大、命中率怎么测。你手上的场景,打算用哪套缓存接?
作者提示含AI生成内容。作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~