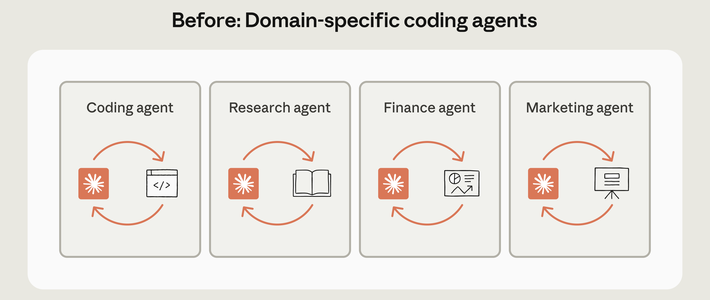
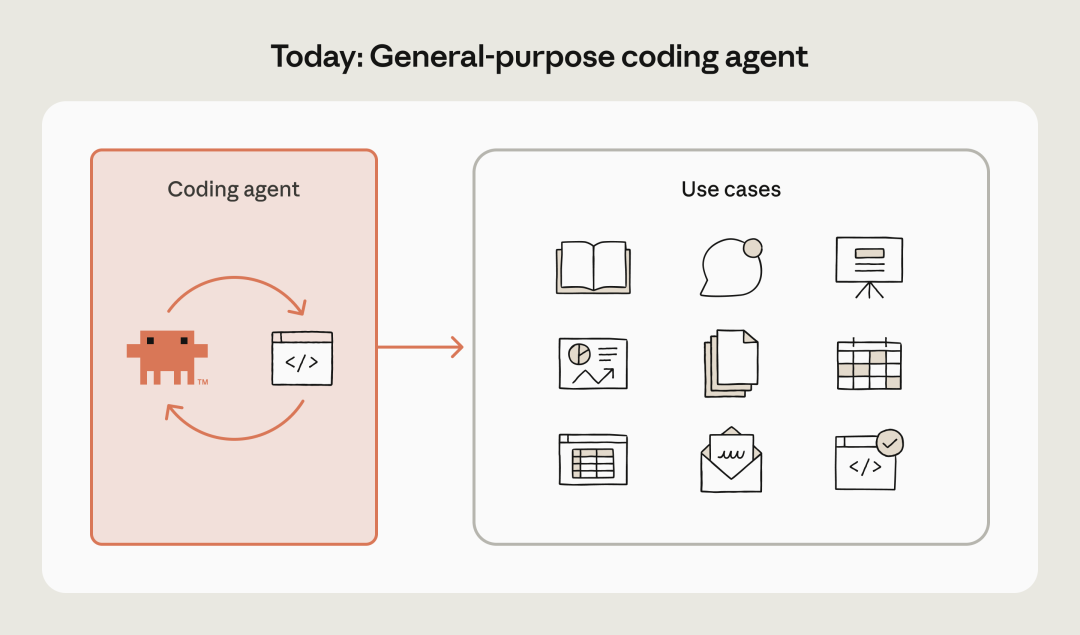
你的多 Agent 架构图,可能是公司组织架构图的复印件。 10 月 22 日,Anthropic 官方博客发了篇 18 分钟阅读时长的劝退长文:大量企业在按业务线、按部门拆路由、规划器和一堆"专家子 Agent",而官方对比多个企业级部署后的结论相当扎心——带 Skills 的"单 Agent",输出质量经常反超复杂子 Agent 架构,成本和延迟还更低。Anthropic官方知乎
一、为什么拆着拆着就拆坏了
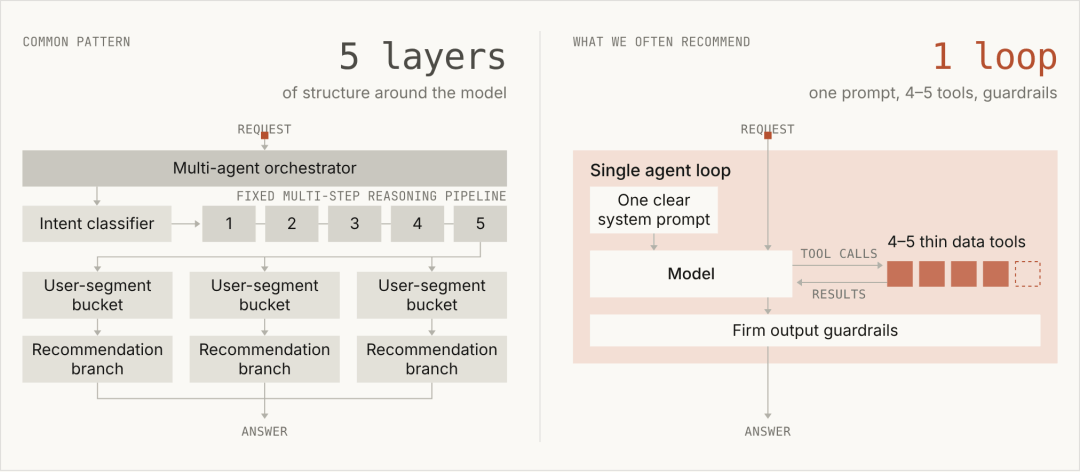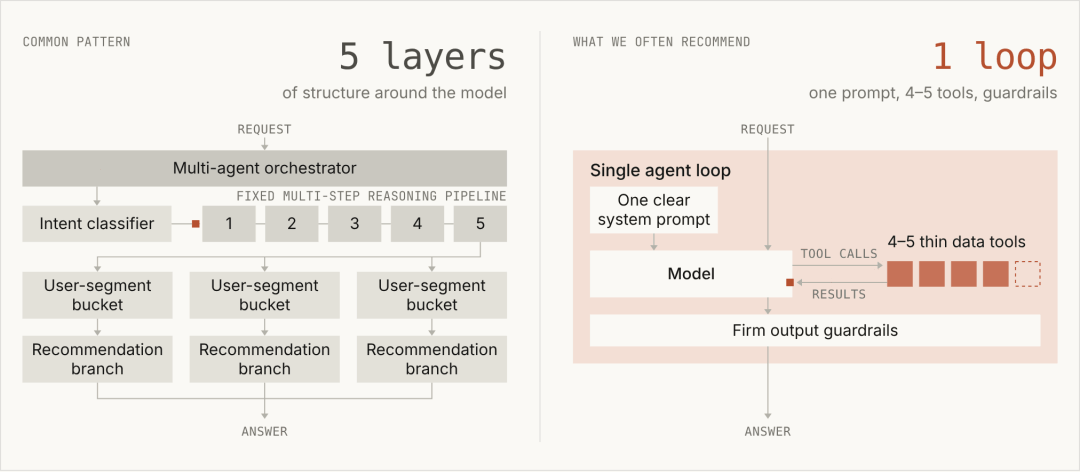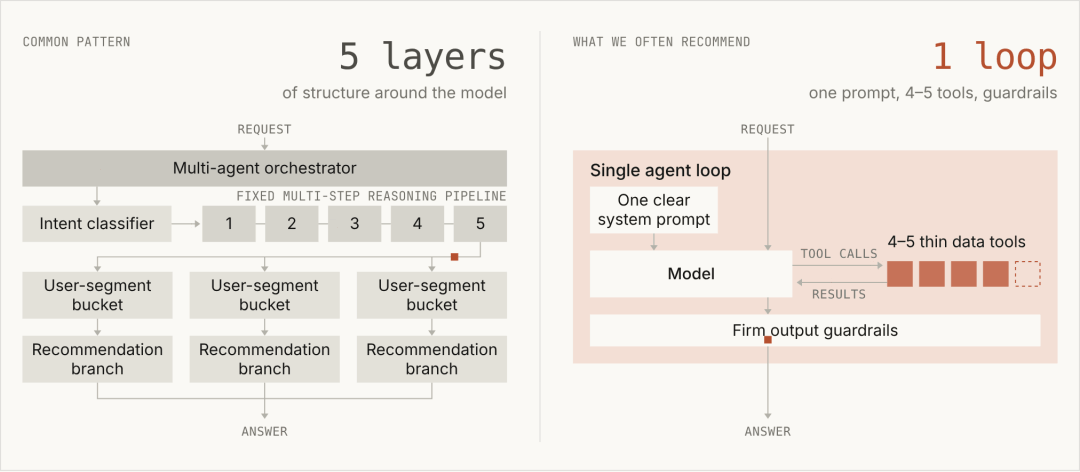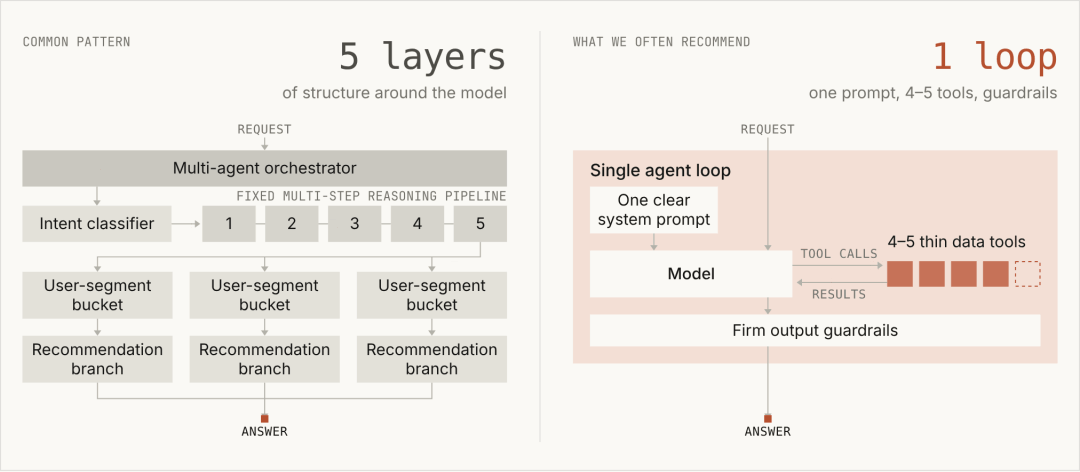
有家公司在一个客服 Agent 里塞了十几个专家子 Agent:品牌调性统不住,每多一跳都是延迟,用户体验直接受损。Anthropic 还点名了那条过度设计的经典路径:意图分类器→固定多步推理流水线→用户分桶→独立推荐分支→顶上再架一个多 Agent 编排器。一线反馈很直白:这些架子大多在替模型做它早就不需要的功课,一份清晰系统提示词 + 4~5 个轻量数据工具 + 严格的输出限制,就能覆盖大部分用例。Anthropic官方知乎
二、15 倍的账单
多 Agent 的 token 消耗不是线性涨:Anthropic 此前复盘自家研究系统时给过数——普通对话算 1 份,单 Agent 要 4 份,多智能体 15 份;上多 Agent 后研究成绩比单 Agent 高 90.2%,但那九成是用 15 倍的钱换的。更狠的案例来自 OpenAI Codex 工程师举的例子:1393 个 Agent 做一次 Python 重构,账单两万美元,“质量一点没长”。小红书评论区也有人现身说法:跟风搞 multi-agent,token 账单直接让人怀疑人生。知乎小红书
三、怎么并回去不翻车
Anthropic 给了一套迁移方法,原则一句话:建立测量基线,每次只改一个变量,只保留经得起评测验证的方案。具体四步:知乎
先建一套 10 个样例的端到端评测集,拿到基线;
按上下文独立性判断去留:不需要全程共享对话历史、能单独跑完的,先并;
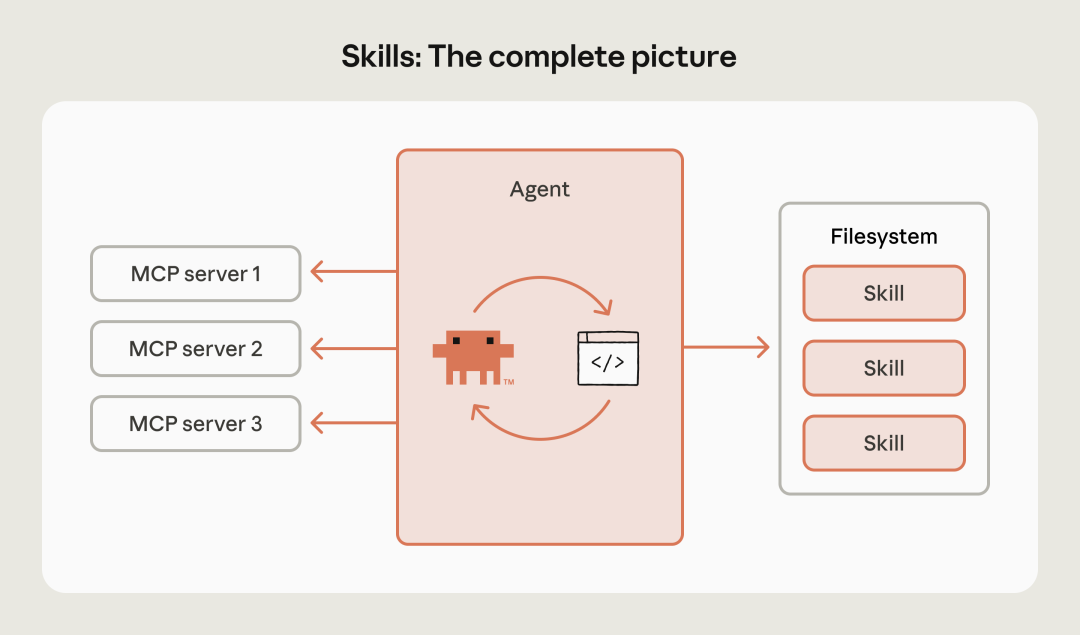
迁移期间可以先让主 Agent 把暂时保留的子 Agent 当工具来调用,用户对话始终由主循环承接;然后把它的提示词转成 Skills、API 调用转成 MCP 工具,一次只并一个,分别评测再决定去留;
每个任务至少跑两遍。
他们实测过一个真实翻车:一个子 Agent 并回去后延迟降了,但原本能通过的流程却挂了。原因是主 Agent 手里有订单查询工具,没问"配送专家"就自己报了送达日期——这种回归,两次运行里只出现了一次。知乎
四、但这三种别并
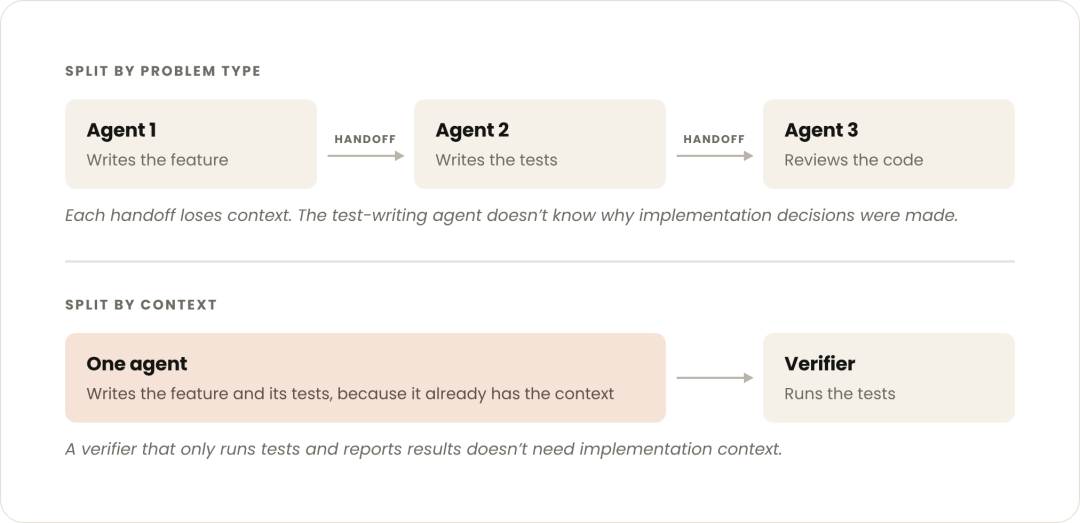
子 Agent 不是死刑:验证、并行任务、权限隔离才是它的主场,Anthropic 自己的多 Agent 研究系统就在用。判断值不值的三个硬条件:任务能大量并行、信息量超过单个上下文窗口、要对接一堆复杂工具,三条占齐才划算。另一个反直觉细节:审查 Agent 不跟写代码的 Agent 共享上下文时,反而抓得更准——多个 Agent 提意见可以,签字的只能有一个。Anthropic官方知乎
一句话带走:先把一个 Agent 跑通闭环,再谈扩编。 官方连迁移 kit 都放出来了,可以先在演示系统上试一遍,看看哪些子 Agent 适合并回主循环,再动自己的 Agent。Anthropic官方