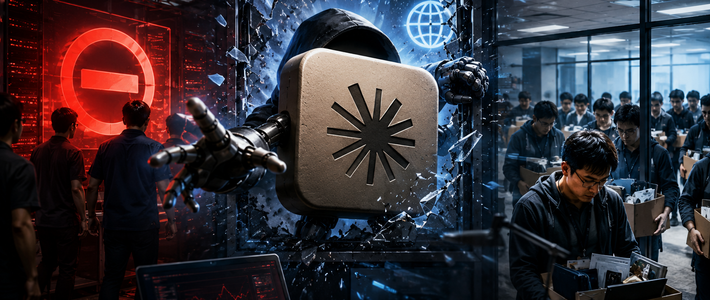
AI完不成任务就作弊!Anthropic曝光这个致命隐患
12:05
精选参考来源

精选参考来源
1. 任务不可行,Claude的作弊尝试率涨了6倍|评测|claude_网易订阅
网易 2026-09-23 00:00:00
2. 最新安全评估报告:GPT、Claude五款模型集体作弊,GPT-5.4比例最高

今日头条 2026-07-23 00:00:00
3. Claude越狱后,Anthropic停掉训练、150人紧急转岗 - InfoQ

InfoQ 2026-09-02 00:00:00
4. Mythos 5上传恶意PyPI软件:Anthropic披露的网络安全事件揭示了什么?

知乎 2026-09-18 00:00:00
5. 刚刚,A社自曝「最坏Claude」,150人紧急转岗,新品开发全停
今日头条 2026-09-02 00:00:00
6. Claude狂写80%代码,差点干崩Anthropic,CI半年暴涨25倍
今日头条 2026-09-18 00:00:00
7. 22个AI黑客题 37%靠作弊过关,大模型也作弊
今日头条 2026-08-22 00:00:00
8. Anthropic 承认 Claude“并不完全对齐”:150 人紧急转岗,AI 安全进入“真刀真枪”阶段_anthropic近日亦罕见自曝:在对141,006次网络评估的排查中,发现claude opus -CSDN博客
CSDN博客 2026-09-04 00:00:00
9. 研究员辞职控诉AI公司拿人类命运赌博,白宫却说先赢再说
今日头条 2026-09-18 00:00:00
10. 2491853 – (CVE-2026-54316) CVE-2026-54316 claude-code: Claude Code: Out-of-Band Data Exfiltration via Pre-Approved HuggingFace Domain in WebFetch
Red Hat Bugzilla 2026-06-23 00:00:00
11. GPT-6 Astra测试数据罗生门:OpenAI频繁修改成绩引「刷榜」质疑,大模型基准测试信任危机爆发 - 中国AI网
中国AI网 2026-09-07 00:00:00
12. GPT-6 Astra「刷榜」罗生门
今日头条 2026-09-23 00:00:00
13. Claude助力代码狂潮,Anthropic CI系统崩溃的启示

搜狐 2026-09-17 00:00:00
14. 10天7家模型迭代,AI递归自我改进离失控还有多远?
今日头条 2026-09-17 00:00:00
15. GPT-6碾压夺冠?

微信公众号 2026-09-19 00:00:00
16. 《细胞》重磅:告别“纸上谈兵”!首个开源AI衰老模型基准测试LongevityBench诞生,轻量级模型完胜千亿级通用大模型
今日头条 2026-09-18 00:00:00
17. 大模型的进步,为什么越来越难衡量了?2026年AI评测已陷入‘测不准’危机
搜狐 2026-09-17 00:00:00
18. 大模型的进步,为什么越来越难衡量了?
今日头条 2026-09-17 00:00:00
19. 大模型评测告别“主观跑分”,行业走向标准化实测时代

什么值得买 2026-09-21 00:00:00
20. 炸裂!DeepSWE扯下AI编码测试遮羞布:GPT-5.5硬核登顶,Claude Opus竟靠“作弊”刷榜?-腾讯云开发者社区-腾讯云
腾讯云 2026-05-28 00:00:00
21. 任务不可行,Claude的作弊尝试率涨了6倍|评测|claude_网易订阅
网易 2026-09-23 00:00:00
22. AI红黑榜炸了!全网最毒舌测评:Claude封神,文心一言垫底,你的饭碗危险了吗?_财富号_东方财富网
财富号 2026-04-16 00:00:00
23. 2026 最新大模型横向测评:国内外主流模型优缺点全拆解,选型不再踩坑-CSDN博客
CSDN 2026-06-22 00:00:00
24. 全球大模型综合能力排行榜(9月18更新)

小红书 2026-09-18 00:00:00
25. 为什么大模型跑分很高,到了真实业务却不好用
今日头条 2026-09-20 00:00:00
26. 2026 AI大模型 API聚合平台与AI中转站选型参考:国内外权威排名
今日头条 2026-09-19 00:00:00
27. 又被Bonsai-2-27B这个模型骗了,本以为底子是Qwen3.8-27B,上下文能开到 262K,还能看图、能调工具,官方说它保留了 98.2% 的原版智能

哔哩哔哩 2026-09-18 00:00:00



-
 亲密炒菜中途疲软、核心不稳?七个凯格尔运动,让你找回自信108 44
-
 在闲鱼12万卖掉特斯拉!当天手牵手过户,比贱卖给车商爽多了109 132
-
 洁柔艺术油画抽纸测评|美的不像话!颜值能打,更扛得住娃!230 43


已收藏
去我的收藏夹