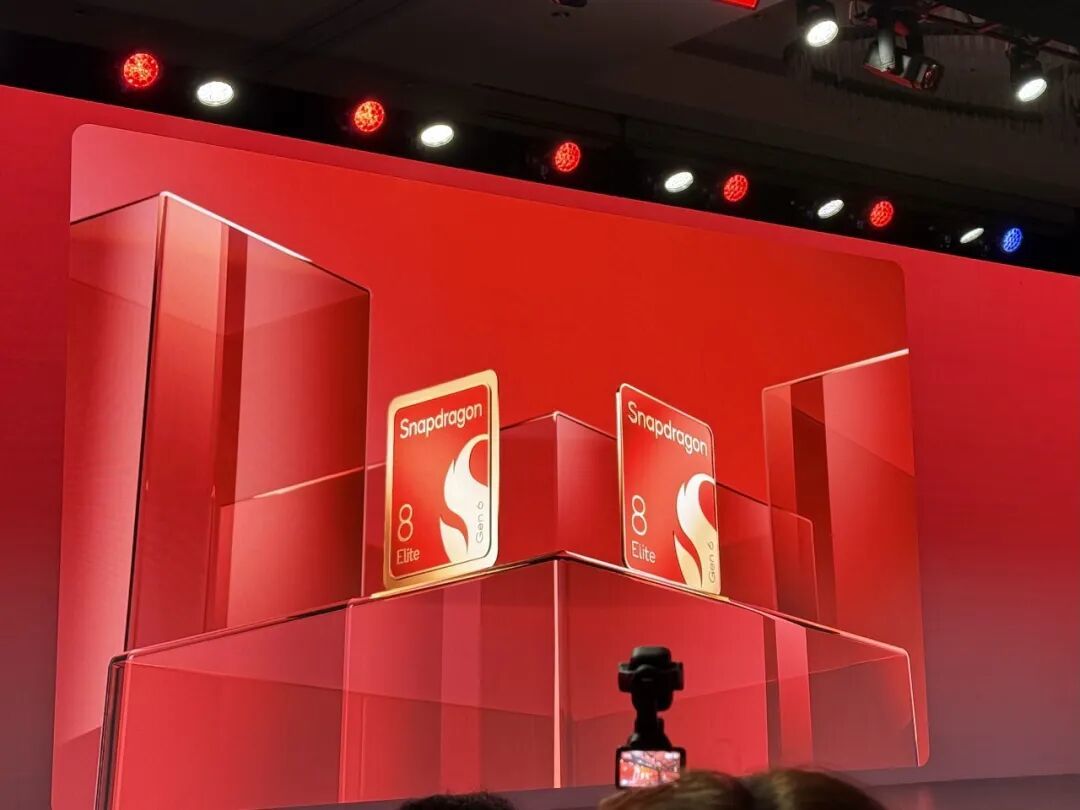
9月23日的夏威夷骁龙峰会上,高通CEO安蒙把第六代骁龙8至尊版/超级至尊版定调为「以智能体为中心」。现场被媒体和KOL反复转述的高光时刻,是一块手机芯片全程不联网跑完了一个300亿参数的MoE大模型。36氪微博
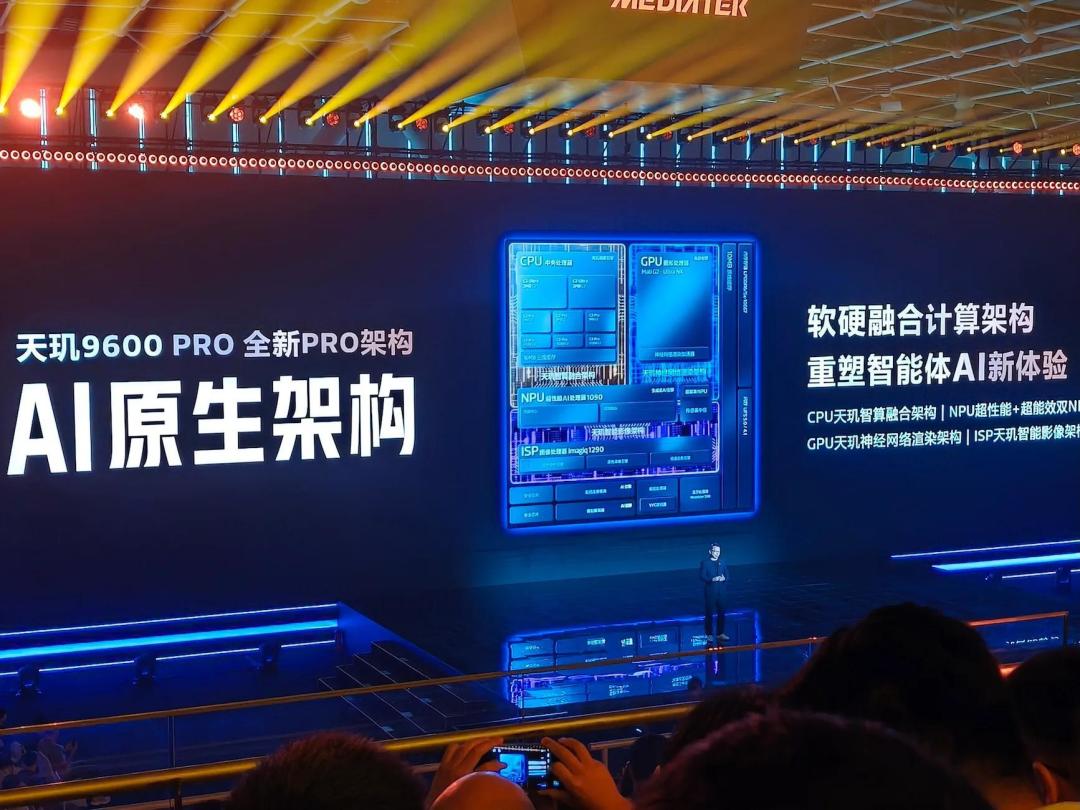
先别急着喊「端侧元年来了」——往前倒半个月,9月15日联发科天玑9600发布时,说的是几乎同一句话:端侧最高可运行30B的MoE模型,NPU预填充性能提升51%,每瓦生成词元最高提升55%。知乎
两家做手机芯片的巨头,两周内先后官宣「手机跑30B」。当一个说法从单独厂商的PPT变成两家的共同口径,对三个月内加过卡、换过模型、踩过显存涨价坑的人来说,这件事就值得拆开看:这次它们到底改了什么,又有哪些东西没改。
先承认:上次「手机30B」是标签,这次的活儿是真的
我们前阵子刚拆过手机侧的「30B」话术:标称30B稠密跑法,实际干活的只有1-3B激活参数。这条规则今天依然成立——30B说的仍然是总参数,真正上班的还是激活的那一小部分。变了的是另一件事:过去把「总参数」塞进手机,卡在一堵内存墙上,这次这堵墙被实打实动了三刀。
第一刀在NPU内部。 新一代Hexagon NPU新增了专门面向生成式AI和Transformer负载设计的Element Accelerator单元,INT4模型预填充速度提升50%,并给开发者保留了INT2到FP16的完整精度阶梯。更关键的是大容量共享内存最大扩容达50%,官方口径是把上下文和KV-cache留在NPU片内,不再每生成一个token都去挤DDR带宽。NPU从「跑CV小模型的协处理器」改成了「为LLM重设计的主设备」,这是架构层面的表态。36氪
第二刀更狠:总参数干脆不常驻内存了。 峰会上那台真机的30B MoE,不是高通一家干的——高通官宣携手阶跃、无量火、江波龙开展四方合作,基于第六代骁龙8超级至尊版把300亿参数MoE模型跑在手机端侧,官方还给了「首个词元毫秒级生成」的说法。江波龙的iSA调度方案把MoE权重以流式方式从闪存按需调取,对外口径是运行内存需求降低超50%,这也成了中端机型有可能承载端侧大模型的底气。换句话说,手机这次玩的是「总参数住UFS、激活专家住内存」的编排——MoE的稀疏性第一次被端侧硬件当成了卖点,而不是当遮羞布。高通开发者社区微博
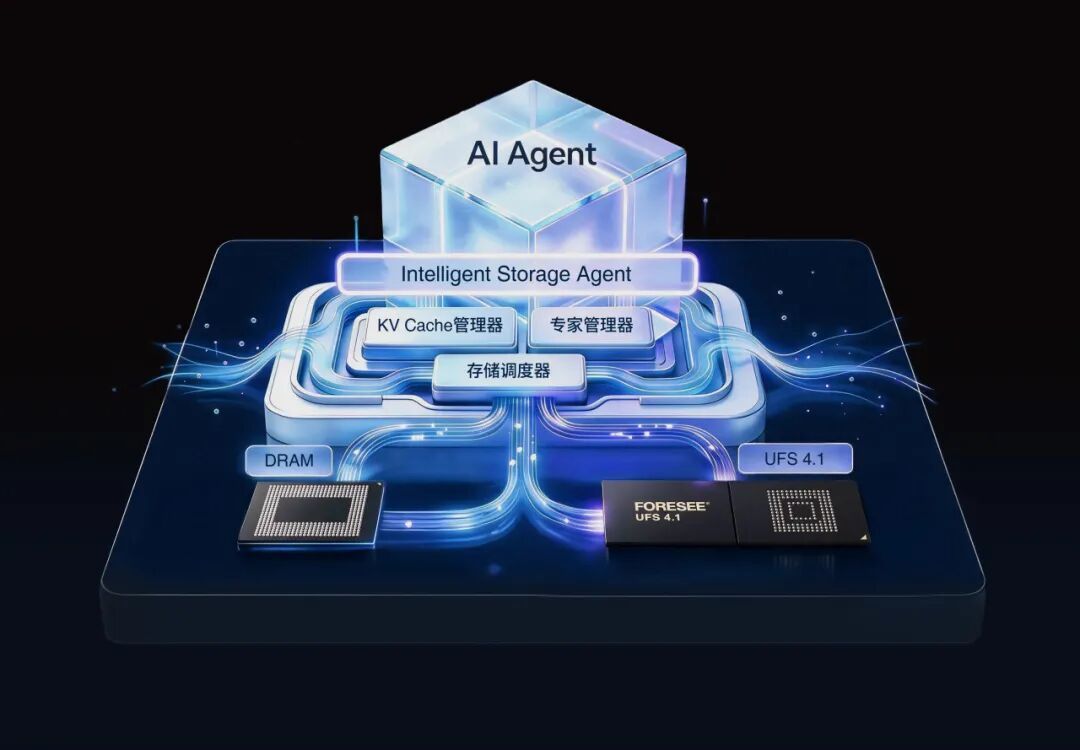
第三刀是联发科跟进。 天玑9600的双NPU路线同样主打大模型预填充和每瓦词元数。两家在两条技术路线上各自宣称解决了同一个瓶颈,端侧AI过去「叫好不叫座」的症结是内存这件事,已经被行业当成了共识。
但没倒的墙,和倒的墙一样实在
墙一:速度和散热没倒。 KV留在片内、权重从闪存流——这两个方案本身就是在承认带宽和功耗的天花板还在。目前公开信息里最实在的手机端侧速度参照,来自开源项目PocketOrca-LLM的说明:骁龙8 Elite上Qwen2.5-7B Q4量化在NPU引擎下稳定10 token/s,1B模型约23 t/s。7B稠密就是这个体感,30B MoE的真机解码速度,截至发稿没有任何第三方实测——各平台流传的所谓Step-5-preview实测,跑的是API版本的对比,不是端侧那份权重,模型也没有开放下载。发布会demo、KOL现场体验、「全程不需要联网」,和「你每天愿意在它上面干活」之间,隔着一整个量级。知乎
墙二:工具链搬不上手机。 显卡党攒机器不是为了聊天,是为了那套服务形态:给全家设备开OpenAI兼容API(我们写Ollama公网裸奔那篇的教训,本质就是「服务」引来的风险,手机端侧反而给不了你这个服务)、挂长上下文知识库——把27B用卸载方案塞进12G显存、跑出128K上下文、decode 50+ t/s的极限实测都已经出现。再往外是ComfyUI文生图(图像模型比语言模型更吃显存)、LoRA微调、多模型并发、全天候跑批。这些没有一样能装进一台被动散热的手机。知乎
墙三:控制权是别人的。 权重不开源、量化格式自己定不了、什么时候换模型取决于那四家供应商。经历过Ollama截断、换工具「控制权之争」的人应该清楚:端侧手机不是「更小的本地部署」,而是一台把控制权全部交回去的黑盒。它解决了「能不能跑」,没解决「听谁的」。
对显卡党,真正的信号不是「卡过时」,而是两端在走同一条路
把手机这次30B的戏法翻译成显卡党的语言:总参数放低速介质、激活专家进高速介质、KV尽量不占外部带宽。这不就是PC本地圈这两个月一直在玩的东西吗——同一张12G的3060跑35B-A3B MoE实测30t/s上下已经成了常规操作,3.6万星标的纯C推理引擎更是把744B模型流式塞进了消费级机器。手机侧的「30B」不是显卡党的对手,是同一条路线的邻居,只是它的存储从SSD换成了UFS。知乎哔哩哔哩
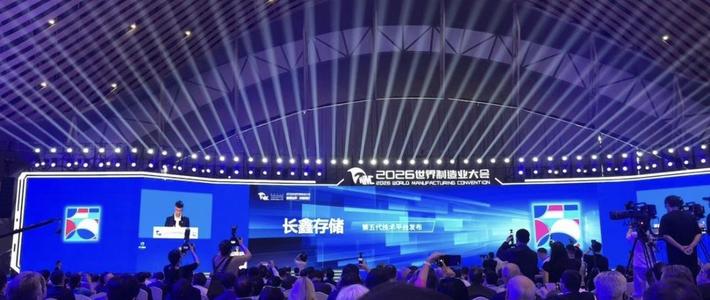
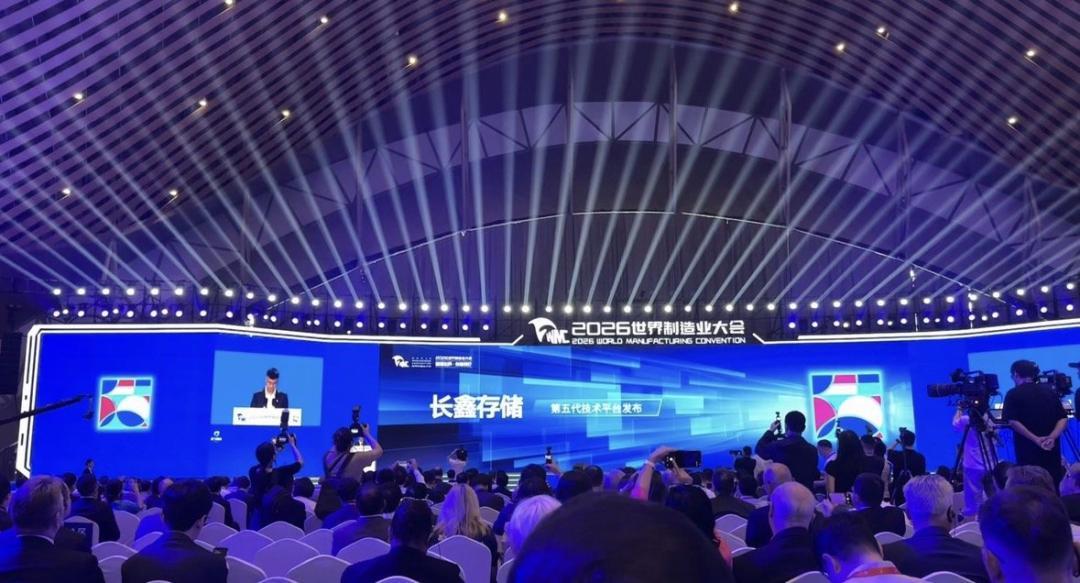
路线合流之后,买卡选机的结论也跟着收敛:容量和带宽优先于纯算力。显存需求表摆在那里,8G、12G、16G档卡在35B-A3B这级,24G显存及以上才跑得稳Q4量化的27B,27B往上直接断层到95GB级显存需求的180B档。(有本事用低比特量化和卸载的,能把27B塞进12G甚至8G,但上下文和稳定性另算账。)偏偏这轮存储还在涨价:同样256GB的iPhone Pro今年比去年要多备1000元,而供给端刚有点动静——长鑫9月20日在世界制造业大会上宣布第五代DRAM技术平台量产,新平台每片晶圆的裸片产出较第四代提升至少50%。这种情况下还要动预算,钱应该花在「装得下、取得快」上,不是「算力再高一档」上。知乎36氪
这本账的三条边界,和三类再等等
手机该接走的:随身轻智能体——语音、翻译、摘要、日程调度、隐私敏感的快问快答、离线救急。这部分本来也不该占你的显卡。
显卡机该守住的:整网API服务、长上下文RAG、文生图/视频、微调、多模型并发、跑批。这部分的护城河这次不但没被削,反而被证明得更清楚了——芯片巨头要绕三道弯才够到MoE的激活参数,你的机器上35B-A3B已经跑了大半年。
下单前先等这三件事的:
等权重——阿里9月22日官宣了Qwen4四款模型(Max、Flash、Plus和27B),暂未透露发布时间,其中27B档被社区普遍解读为「留给本地跑的那一个」。急着为新模型升级硬件的,先等开源权重和真实显存需求落地;哔哩哔哩
等速度——端侧30B的首批第三方真机实测(decode、发热、续航掉多少)没出来之前,「手机跑30B」在你的预算表里只算新闻,不算变量;
等生态——小米18系列配套的MiMo-V2.6-Distill-Qwen-9B已经开源上站了,如果后续端侧蒸馏模型持续开放权重,手机那端才真正进入「本地部署党」的账本。
总结成一句:这次高通和联发科真的把内存墙凿开了一道缝,但速度墙、工具墙、控制权墙都还立着。显卡党不需要因为一场发布会改主意,但值得把这条缝记进观察清单——端侧和PC共用同一套MoE玩法的时代已经开始了,先想清楚自己要哪一头的控制权,再决定钱包往哪头动。