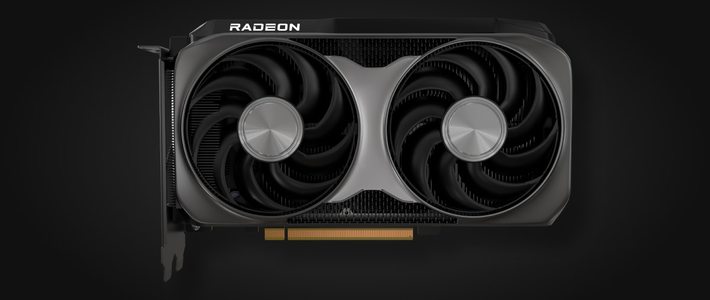
9月13日深夜,r/LocalLLaMA上一个叫"CUDA for AMD on Windows"的社区项目更新了验证记录:开发者Speedstu用公开的ZLUDA加AMD HIP组件,让一张RX 9060 XT在Windows上完整跑通了一个约222万参数PPO强化学习网络的推理、学习和参数更新。第二天(9月14日),YouTube博主Fahd Mirza跟上了一期手把手教学视频,B站当晚就有搬运。哔哩哔哩
对手里攥着一张A卡、早就想跑点CUDA系任务但每次都被"这软件要CUDA"劝退的人来说,这条消息的分量不用解释——这是A卡第一次在Windows上有人给出可复现的CUDA训练验证。但"能跑"和"你可以拿它干什么"之间,隔着三本账。这篇文章就是来把这三本账对完的。
第一本账:验证的到底是什么
先把范围钉死,这是全网转述最容易丢的部分。
这份验证的运行组合是:Windows x64、ZLUDA v6-preview.69、HIP SDK 6.4、LibTorch 2.3.0+cu118。注意版本号里的"preview"——它不是稳定版,作者用的是预览通道。跑通的对象是一张RX 9060 XT、一个约222万参数的PPO网络,覆盖的是推理、学习、参数更新这条完整闭环。小红书
222万参数,说小一点,比很多老游戏里的过场AI模型都不算大。它的意义不在规模,在"闭环":CUDA程序在Windows的A卡上不是"能启动",而是能完成训练-更新-再推理这个循环,且配置公开、别人可以照着复现。这是它比此前所有"ZLUDA让A卡跑CUDA"讨论都更进的那一步——此前A卡跑CUDA的可复现配置基本集中在Linux侧,Windows侧的训练闭环,这是第一次有人把版本号级的配置公开贴出来。
还有一点要拎清楚:这是社区项目的自发验证,不是AMD官方宣布全面兼容CUDA。消息源本身(国内搬运最快的帖子之一)也把这句话写在了正文里。
第二本账:跑得动,不等于跑得更快
对照实验也放出来了,口径很细:同一张卡、同一训练配置,公开上游方案与作者恢复的定制方案各跑两轮、每轮五次迭代,剔除各轮首次预热后各保留八个样本。每秒步数的中位数,一个是约13,278,另一个是约12,876——定制方案反而慢了约3.03%。 这个数字要连着一句话一起读:这不是AMD与英伟达显卡的性能对比。它比的是"两种转译方案之间"的差距,不是"A卡对N卡"。所以别指望从它推出"转译损耗只有3%"这种结论——那是对着两行数字脑补一整张价格表。小红书
另外,作者仓库里留存的历史高吞吐数字来自不同配置,和本次结果不能直接比较。这条是原帖自己声明的,转述的人多数没抄。
第三本账:边界比标题重要
这份验证自带一张失败清单,比"跑通了"三个字有用得多:
验证配置里没有cuDNN。依赖cuDNN的软件,在这个环境里可能直接失败——而现实里大量训练脚本、推理框架默认就要它。
只验证了RX 9060 XT这一张卡、这一个PPO任务。其他AMD显卡能不能复制这个结果,目前没人交作业。
部分CUDA接口、自定义扩展可能不兼容。CUDA十多年的API面,转译层覆盖到哪一格,只有具体任务撞过才知道。
所以"边界"的真实画幅是:一个能跑通的点,而不是一张铺开的面。
时间线:从"已经GG了"到Windows,这个开源项目走了六年
这条线为什么值得关注,是因为它前阵子刚死过一次。
ZLUDA的底层逻辑是拦截应用程序的CUDA API调用、重定向到AMD的ROCm/HIP环境——相当于在N卡和A卡之间装了个翻译。它由波兰开发者Vosen从2020年起一个人用Rust重写整个CUDA运行时,六年攒下14000+ Star、900+ Fork,Apache 2.0开源。 中途项目一度停摆,停到什么程度?8月初还有科技博主在公开帖子里断言"之前有个ZLUDA……现在也已经GG了"。哔哩哔哩微博
然后是两段回血:
去年12月,ZLUDA正式适配ROCm 7,被外媒包装成"破局英伟达CUDA护城河"。IT之家
今年6月29日,ZLUDA v6首个正式版发布,加上了NVIDIA 32位PhysX支持。这里有个圈内已经笑过的名场面:RTX 50系砍掉32位PhysX后一堆老游戏变砖,结果《四海兄弟2》在锐龙9950X3D+RX 9070 XT上,未启用ZLUDA只有26.2帧,启用后飙到80.2帧——NVIDIA不要的功能,A卡用开源转译层接住了。快科技
再往后,就是9月13日深夜这份Windows验证和9月14日的教学视频。
也就是说,这个生态位一年内完成了从"GG了"→适配ROCm 7→v6正式版→Windows训练闭环可复现的四连跳。跳得是快,但每一步都踩在"社区项目"四个字上,没有一步是官方承诺。
分人算账:这篇到底改变谁的决定
手里有A卡、想玩玩小规模训练/强化学习实验的人——可以动。照着那份公开配置(Windows x64 + ZLUDA preview通道 + HIP SDK 6.4 + LibTorch 2.3.0+cu118)复现一个自己的小任务,成本是几个晚上,收获是"我的卡到底行不行"的第一手答案。预期管理做好:你现在拥有的能力边界是那三个限制条件画出来的。
手里有A卡、目标只是ComfyUI生图和跑本地大模型的人——这篇跟你关系不大,别被标题吓到去折腾。原生路线早就铺好了:ROCm 10这一版重点调优了SDXL Base、FLUX.2 KLEIN和Wan 2.2。 9月14日小红书上有AMD工程师团队的实跑帖,SDXL默认工作流直接跑通,GPU利用率和显存曲线都在动。你的瓶颈从来是显存和耐心,不是CUDA。小红书
还没买卡、在N卡和A卡之间犹豫的人——这篇不改变你的答案。一次222万参数的PPO验证,填不平CUDA生态的墙;决定你买哪张卡的,还是你那个具体软件列不列表支持ROCm。反过来说也一样:如果你的任务清单里只有推理和生图,A卡的性价比账(9070 GRE渠道价已经到3600元档)早就算完了,不需要ZLUDA给你新理由。
继续盯什么
这件事有没有"下一次跃迁",看四个信号就行:cuDNN支持有没有补上(决定依赖它的框架能不能活);验证模型有没有从百万参数爬到亿级、十亿级(决定"训练"两个字的含金量);显卡覆盖有没有从9060 XT扩到RDNA3老卡(决定存量用户的覆盖面);以及最重要的——AMD对第三方CUDA转译的态度,是继续装没看见,还是写进官方文档。
至于"AMD全面兼容CUDA"这种标题,在四个信号凑齐两个之前,见到当乐子看就好。
你现在手里是哪张A卡?有没有一个"这软件要CUDA"卡了你很久的任务?评论区报个型号和任务名,看看这次验证配置能不能接得住你的活。