德国国庆日,Aleph Alpha 高调发布"主权AI"旗舰 Kolibri。热度没过一个月,就有人翻出189页技术白皮书的第3.1.1节:2200万条训练样本里,31.7%的重写数据和32.1%的自主生产数据,由中国开源模型深度加工。数据猿知乎
西班牙的同行 Quasar 坦率得多,官网直接写明"Quasar 438B 是一款基于 Z.ai(智谱)开源权重模型 GLM-5.2 构建的压缩模型"。知乎
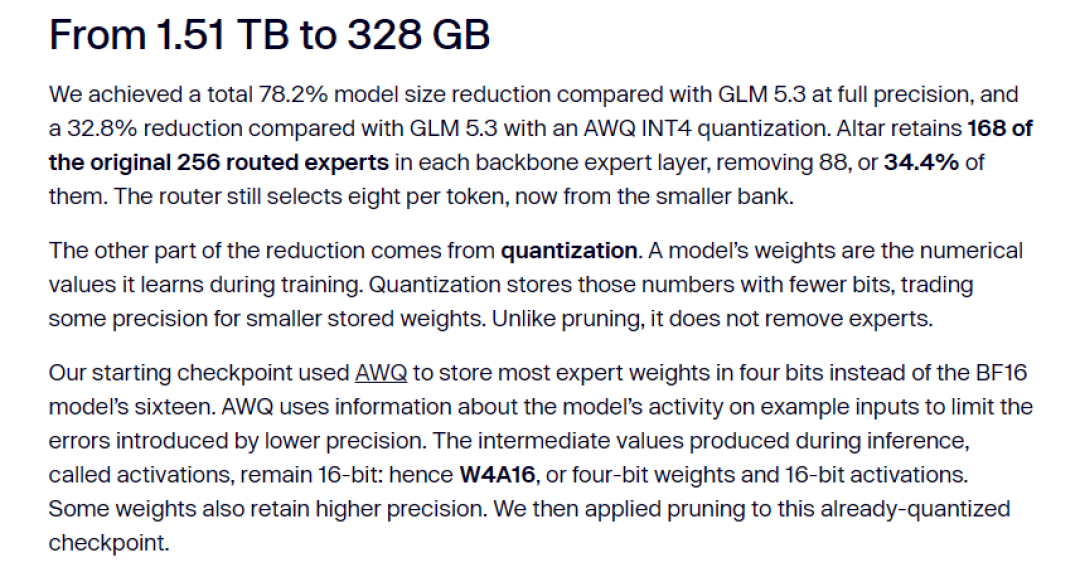
比利时 Aikido 的 Altar 也在发布文章里落笔"我们以 GLM-5.3 作为基础底座"。知乎
这个十月,欧洲"自研"大模型接连被拆开:壳是主权,芯是中国造。热闹归热闹,国内开发者先别急着笑——同一时间,量你的那把尺子也在换。
一、"自研"叙事会塌,许可证和数据链不会
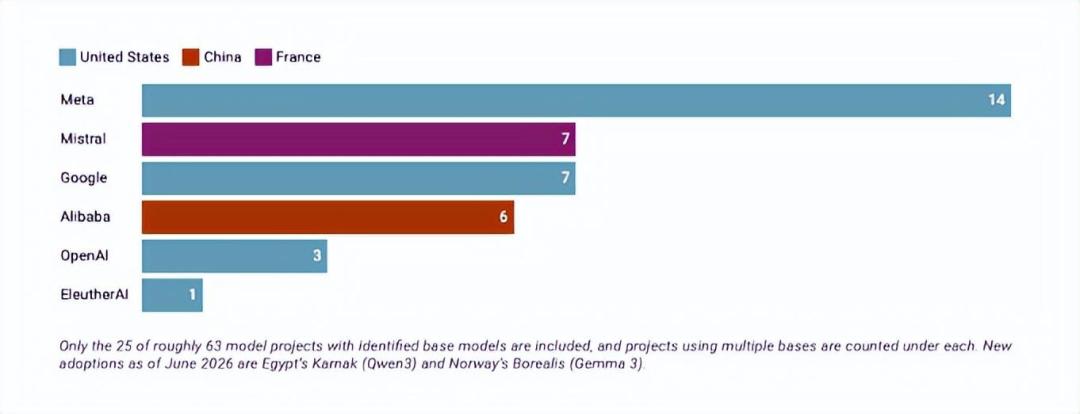
评论区调侃"一开源就自研",但真正值钱的启示是另一条:开源许可证不是装饰品。有媒体梳理提到,日本乐天 Rakuten AI 3.0 被扒出配置文件里 model_type 直接写着 deepseek_v3,上传时还把 DeepSeek 的 MIT 许可证文件删了、换上自家授权。你的团队基于开源底座做二次开发,第一步就是查许可证、核数据链。叙事会随发布会改变,合规义务不会。数据猿知乎
被顶到前排的一条分析说得很扎心——“在需要做决定的那段时间里,同时满足前沿性能、欧盟可用、不用改名这三个条件的底座,基本就只剩中国的几家”。这不是段子,是2026年的全球基础设施现实。知乎
二、尺子一动,榜单重排不是"他们赢了"
10月底,Artificial Analysis 大幅调整了衡量模型能力的方式:新版智能指数首次有60%的权重来自私有测试集。未尽研究
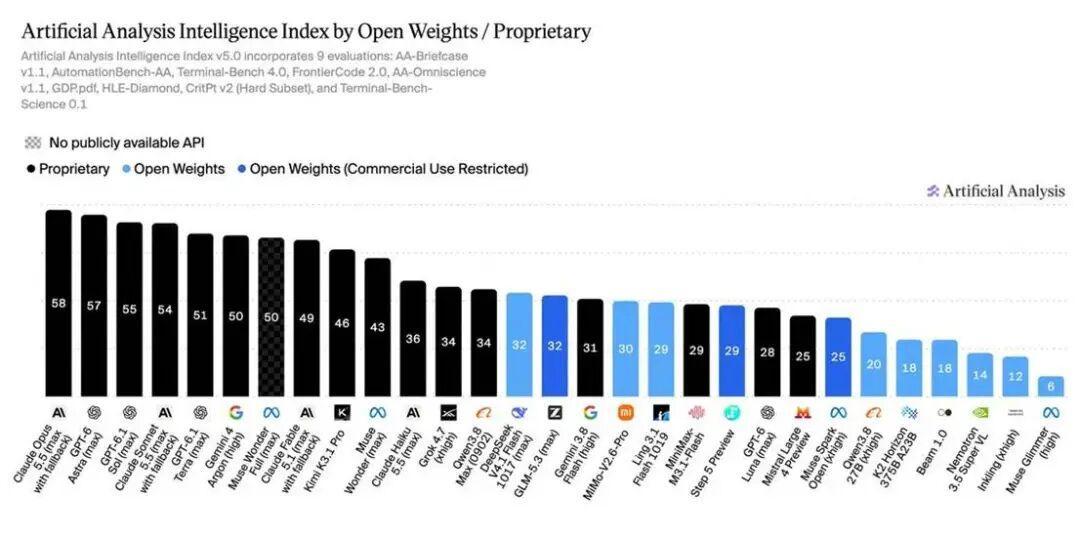
升级到v5版后,国产模型排名集体大幅下滑:Kimi K3.1 Pro 掉到第9且权重未开放,真正已经开放权重的现役国产模型中,DeepSeek V4.1 Flash 1017与GLM 5.3分别排名第14和第15,得分均低于 Anthropic 入门款的 Claude Haiku 5.5。未尽研究
微博一条643赞的热帖给了个很诱人的因果:“不知是不是巧合,在Anthropic和OpenAI采取更强力的反蒸馏措施后,大模型前十已经没有一个开源模型了”。但因果链没有一手信源,评论区自己就吵成三派:有人说"算力才是压倒性的原因",有人指出是尺子换了——测评标准从4.3.2升到v5.0,老办法刷不动了,还有人拿新版实测直接反驳:“DeepSeek新版本再次冲到前列看来DeepSeek确实没有蒸馏。”微博
三、开发者该带走的,是自己的尺子
两件事说的是同一个道理:叙事不是证据,榜单不是尺子。选型三步:一查许可证和数据链,别踩乐天式雷;二别把生产押在单一榜单上,尺子一动排名就翻脸;三用自己的任务跑自己的评测。评论区"国模体感还可以的,除了某些特定领域"和各种平台实测吐槽,吵的其实是同一件事——大模型选型第一准则,是自己花钱跑一遍。
被拆开当底座,说明真能打;被换尺子重测,说明还有硬仗。不必自贬,不必自嗨:管它发布会上挥的是哪面旗,去看白皮书第3.1.1节写的是哪家模型。数据猿