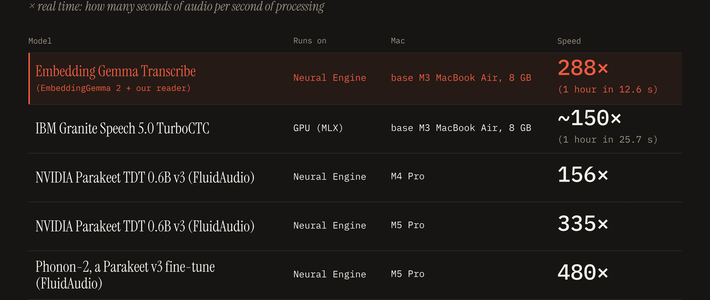
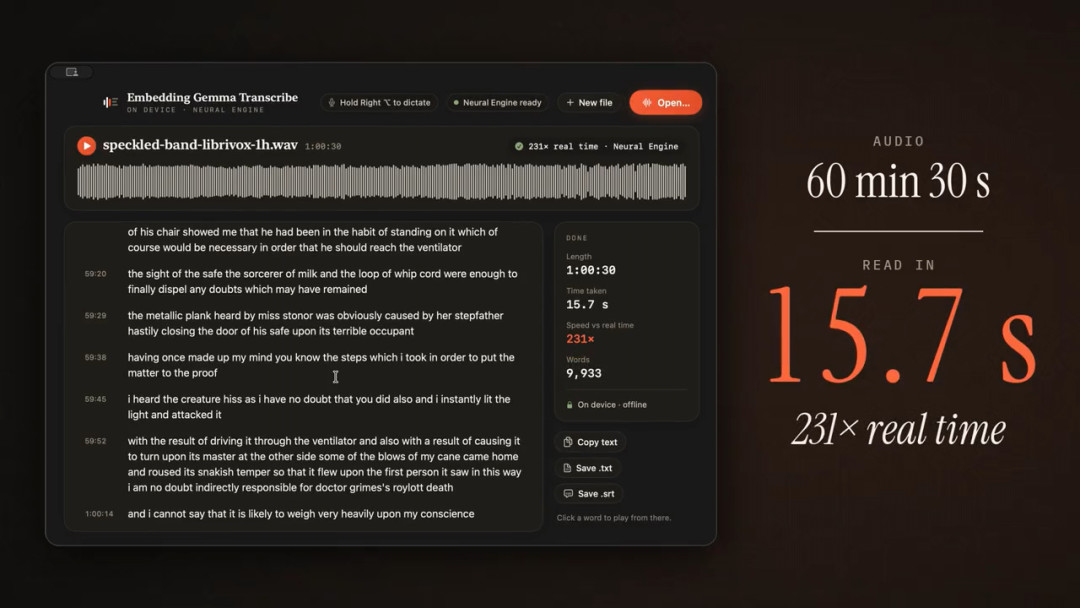
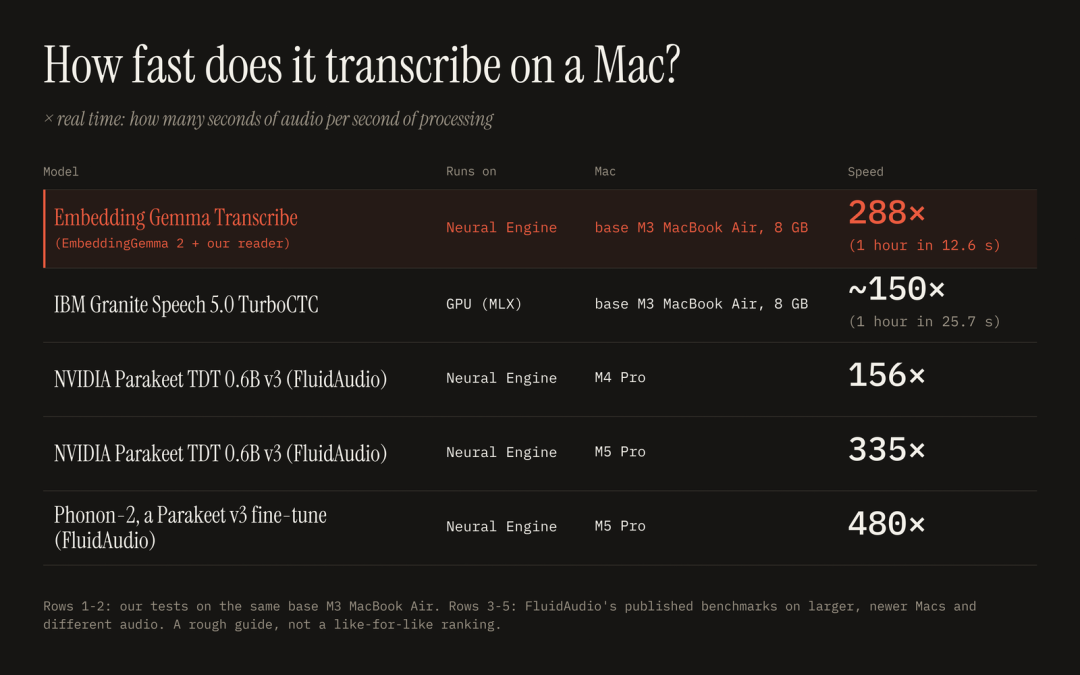
今天上午,科技圈被一个数字刷屏:基础款 M3 MacBook Air,转录一小时音频只要 12.6 秒。免费、离线、全在本地跑,隐私不出设备。开发者把它做成了工具,叫 EmbeddingGemma Transcribe,博主「爱可可-爱生活」上午八点多发出来的原帖里连入口都给了:拖音频文件进去能转,长按右 Option 键还能在任意软件里直接听写,要求 macOS 14 以上加 Apple Silicon。微博
巧的是同一天上午,知乎里还挂着一个画风完全不同的问题:求推荐不限时长语音转文字工具,飞书妙记300分钟不够用?——一个在庆祝转写速度进入"秒级时代",一个还在为时长额度发愁。这两条今天同框的内容,恰好就是这篇该讲的事:这波"端侧转写"到底是不是你的菜,先别急着卸载旧工具。知乎
一、这个神器到底是什么:本周不是孤立事件,是一波"语音端侧化"
先把它的工作原理压缩成一句人话:谷歌的多模态嵌入模型 EmbeddingGemma 2 已经把文本、图片、音频、视频映射进了同一个语义空间,于是开发者不改动模型参数,只花不到两小时训了一个轻量 reader,把语音切片编码成向量后,直接去文本空间里"检索最接近的词",再配一个小模型补齐大小写和标点——转录从"逐字生成"变成了"查字典"。这就是 288 倍速(一小时音频 13 秒转完)的来源:不用自回归一个 token 一个 token 往外蹦。微博
而且这不是孤例。把时间线拉回这一周你会看到同一条暗线:
10月7-8日,谷歌在 Mac 端发布了 Google AI Edge Foresight,定位"本地优先"的 AI 会议笔记,全程离线可用,靠 740M 参数的端侧 EmbeddingGemma 2 跨应用抓取会议内容,连线下当面谈的会也能记,直接对标 Granola。IT时代网
10月13日,技术博主 AIGCLINK 发帖拆解这个转写工具,抛出了一个圈内判断:目前词错率(WER)约 5%,领先的 STT 在 2%~3%,“如果后续 reader 迭代能把 WER 压到 3% 以下,估计专用端侧 STT 市场要重新洗牌”。微博
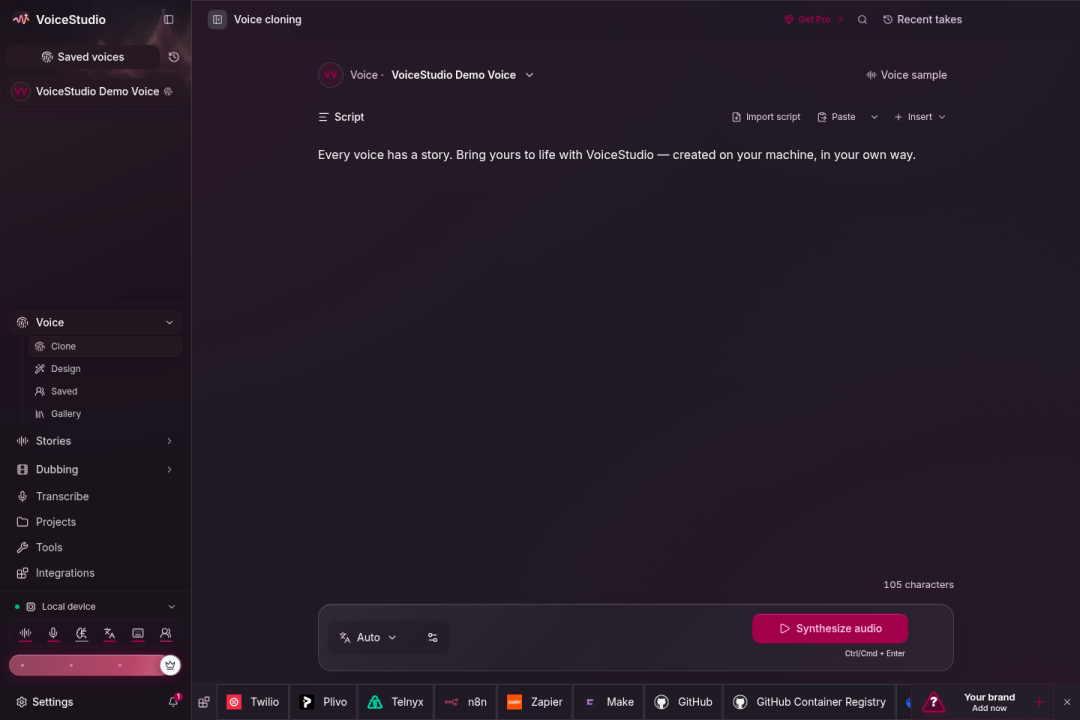
10月14日,开源语音套件 VoiceStudio(本地语音克隆、配音、听写、转录)登上 GitHub 日榜第一。哔哩哔哩
10月15日早晨,有人晒出同一条路线的第三个变体:只花 78 美元训练费,在 3000 小时越南语音频上微调出越南语 ASR,8 个越南语基准平均 WER 6.87% 居首,略超 Gemini-Flash-3.8 的 6.92%、Cohere Transcribe 的 7.01%、ElevenLabs Scribe v2 的 7.08%——做法同样是只微调 12 层音频编码器的顶部 2 层,再接一个 6 层 Transformer reader 配 CTC 解码。微博
所以今天值得停下来的理由不是"又一个神器",而是一周内四件事排着队指向同一个方向:语音转写正在从"上传到云端、按分钟付费"往"在你自己机器上跑、免费"迁移。问题只是:这波迁移什么时候轮到你。
二、装之前先分清三层
第1层:演示层是英文,你的中文账单它付不了
原帖里写得最容易被漏掉的一句话是:语音切片在共享向量空间里"匹配为最接近的英文单词",小模型补的是大小写和标点。也就是说,这个刷屏工具的 reader 检索的是英文词表。博主讲原理时确实用了声音的"你好"和文字的"你好"在向量空间相互靠近来举例——语义空间里中文是存在的,但现成的 reader 演示没给出中文转写。中文用户的端侧转写,眼下仍要走 Whisper、国产 FunASR、阿里已开源的 Qwen3-ASR 这类已有路线。把"12.6 秒"当成中文会议纪要的解放宣言,是今天最贵的一次误读。微博HuggingFace
第2层:5% 词错率,是"初稿"的成本,不是"终稿"的成本
WER 5% 什么概念?领先 STT 的 2%~3%,相当于同样一小时录音,这个工具的错词量是头部在线服务的约两倍。连工具方的定位都很克制:适合会议录音整理、采访转写、语音笔记、视频字幕初稿这类容错场景。如果你转出来的文字要直接对外——新闻稿、法律文书、课程讲义、合同条款——那 5% 的错词就是返工成本,省下的时间会吐回去一部分。微博
第3层:平台层是 Mac 独享,Windows 用户今天只有围观权
工具跑的是 Mac 神经网络引擎,要求 macOS 14 以上加 Apple Silicon。Foresight 目前也在 Mac 端。公司发 Win 本、课堂用安卓平板的人,这波"真香"和你暂时没关系——不是不好,是还装不上。
三、再算三笔账
时间账: 你现在的痛点如果是额度,知乎今天这条问题就是标准画像——妙记这类在线转写普遍按时长封顶,用户原话是"300分钟不够用",超出要么等下个月要么掏钱升级。端侧一旦能用,一小时 12.6 秒,额度概念直接消失。但对只有中文需求的你,这笔账现在的真实数字还是 0。微博
钱账: 在线转写的基本模式是免费额度加分钟计费或会员包月;这波端侧工具全部免费,知乎上"录音转文字用啥准还不要钱?"这类问题最近一周就没断过。不过免费的另一面记得标价:算力出在你自己的机器上,你就是首发用户,出了 bug 自己调试,教程全靠作者心情。知乎
隐私账: 会议录音、采访原始素材、医疗和法务对话传云端,是很多岗位根本不能碰的线,上周还挂在知乎的问题就一句:会议录音转录成文字,有没有本地工具?端侧的卖点就是"隐私不出设备"——这也是谷歌 Foresight 押的方向。真正被这条卡住的敏感岗位用户,更值得等的是"官方本地化"那一层(Foresight 这类),而不是拿社区工具去接最敏感的数据。知乎IT时代网
四、四类人对号入座
英文重度办公/学习者(跨国会议、英文课、播客字幕):今天就可以装,免费离线快,只一个纪律——产出当初稿用,终稿自己过一遍。
中文转写重度用户:别急着动手。方向是真的(这周的密集信号就是证据),但这个工具现在还接不了你的活;短期接着用在线服务,端侧中文盯 Whisper/FunASR 系迭代。
隐私敏感职业(法务、医疗、HR、记者):把 Foresight 这类官方本地应用放进观察清单,社区工具只做脱敏后的草稿层。
Windows 用户:收藏这篇,等移植或网页端方案出现再行动。
五、60秒自查,直接抄
动手前按顺序问自己四句:
我最想转的录音是英文还是中文?中文→今天不动作;
我的机器是 macOS 14+ 且 Apple Silicon 吗?不是→今天不动作;
转出来的文字是自己整理用,还是要直接对外发布?对外→任何转写都当 5% 错词率的初稿对待;
入口只用作者原帖标注的那个(eg2.haku.sh),官网页面上明写着这是"把嵌入模型变成语音转文字模型、基础款 MacBook Air 一小时音频约 13 秒、端侧运行"。一款发布没几天的工具,网盘里和自媒体上流传的"中文魔改版"“绿色便携版”,大概率是蹭热度打包的——这不是阴谋论,是每一波神器刷屏后的固定剧情。EmbeddingGemma Transcribe官网
六、接下来盯什么信号
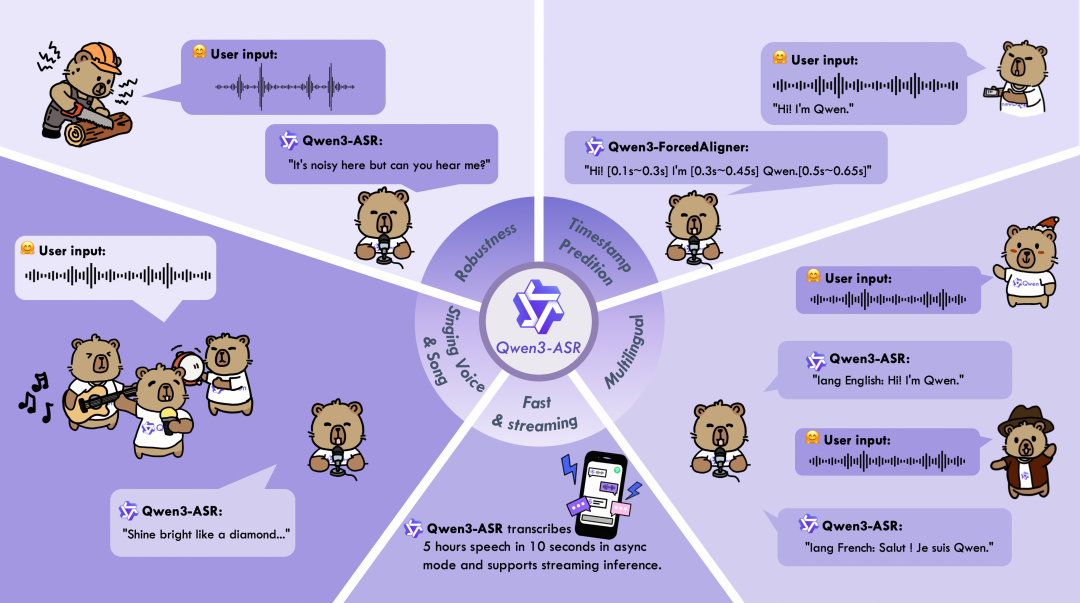
这条线其实不是只有海外玩家:阿里已经开源的 Qwen3-ASR 系列(1.7B/0.6B 两档)官方模型卡写明支持 30 种语言和包括粤语、吴语、闽南语在内的 22 种中文方言,1.7B 版本自评"开源 ASR 里的 SOTA",0.6B 主打高并发吞吐(128 并发下最高 2000 倍)。中文端侧的问题从来不是"有没有官方模型",而是"普通人装不装得起来、跑不跑得起"。HuggingFace
三个可验证的观察点,出现任何一个,这篇的结论就要更新:reader 迭代把 WER 压进 3%(博主原话级的行业分水岭);作者或社区放出中文 reader(或者直接拿 Qwen3-ASR、FunASR 这条中文线套一个"长按 Option 就能听写"的壳);Foresight 出跨平台版并支持中文。在它们出现之前,这波刷屏的正确姿势是:承认 12.6 秒是真的,但那个 12.6 秒,暂时属于英文。