夜里跟着教程装完环境、下载了参数量最大的那个模型,把两百个PDF丢进收集箱,你美滋滋地问了一句——它答得头头是道,可跟你文档里的内容对不上。你删掉答案,关掉窗口,这个知识库从此开始吃灰。
如果你也这样过,先记住一句话:知乎那条16.4万浏览的回答说得直接——本地知识库搭不起来,八成问题不在模型,在切片和召回。而大多数人的第一步,恰恰是从那个最容易被替换的环节开始。知乎
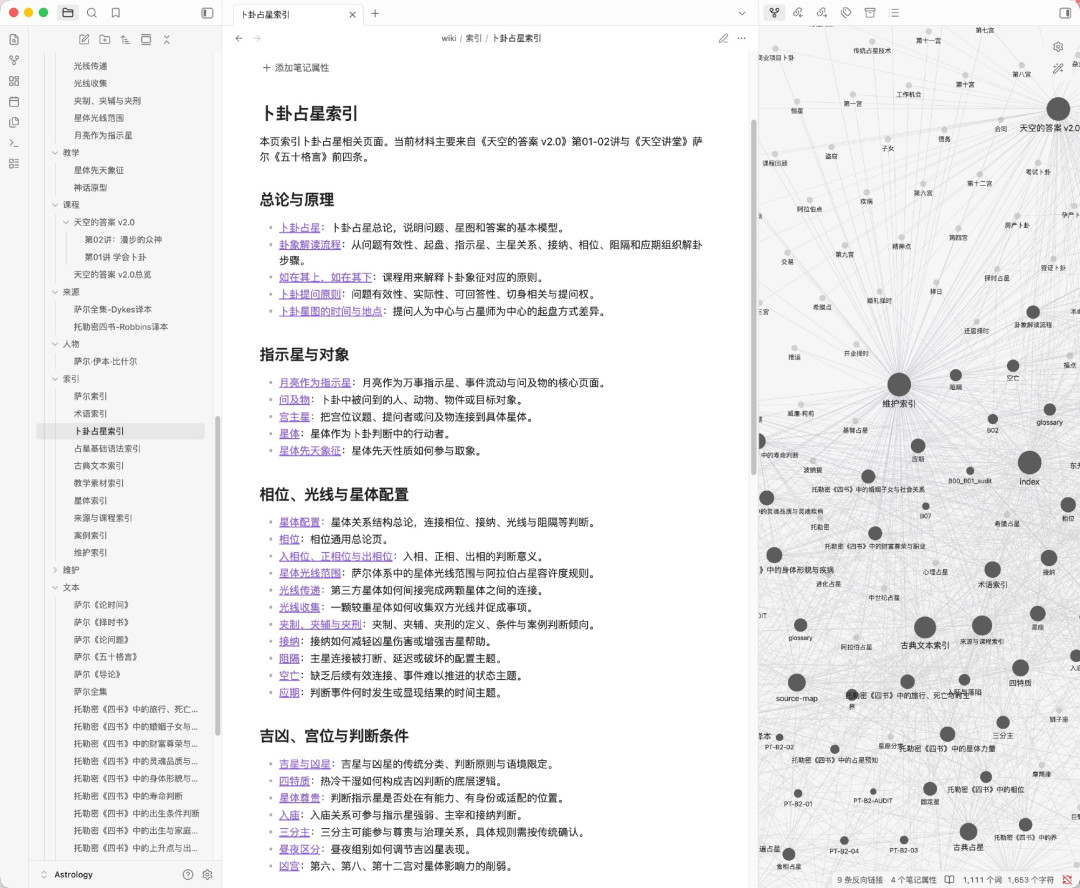
第一步:定验收标准,不是装模型。给公司搭制度问答的工程师,最后收敛成两条铁律:每个回答必须带"来自哪个文件、第几段"的出处;带不出来就直说没找到,不许编一段听起来对的话。模型是这个系统里最容易被换掉的部分,半年换三家的团队他见过不止一个;真正换不掉的,是你的分块和出处。知乎
第二步:切片切在哪,决定答案是错是对。偷懒做法是固定500字滑窗加重叠,这在制度文档上是灾难:“例外条款"被切进下一块,你问"出差超过几天要审批”,它命中正常流程那段,答错。老手维护一个标题栈:读到#就更新路径,攒到420字左右切一块,把整条标题路径写进出处。420不是理论值,是拿7份制度文档试出来的——再小,一块只剩半句判断;再大,一块里塞两种流程,回答会串。知乎
第三步:拿自己的问题验收,别看榜单。把最近一个月真想查的20个问题列出来,人工标好每题该命中的段落,分别跑关键词检索和向量检索,看正确答案排第一的比例。制度、手册类问题,关键词这一路经常还领先;用户爱换说法的客服场景,向量才明显有用。另一位实测者的数字更扎心:第一轮20题只对13道,没对上的多半是笔记本身没写、或同一本书散在两个地方——补完资料,升到18道。知乎知乎
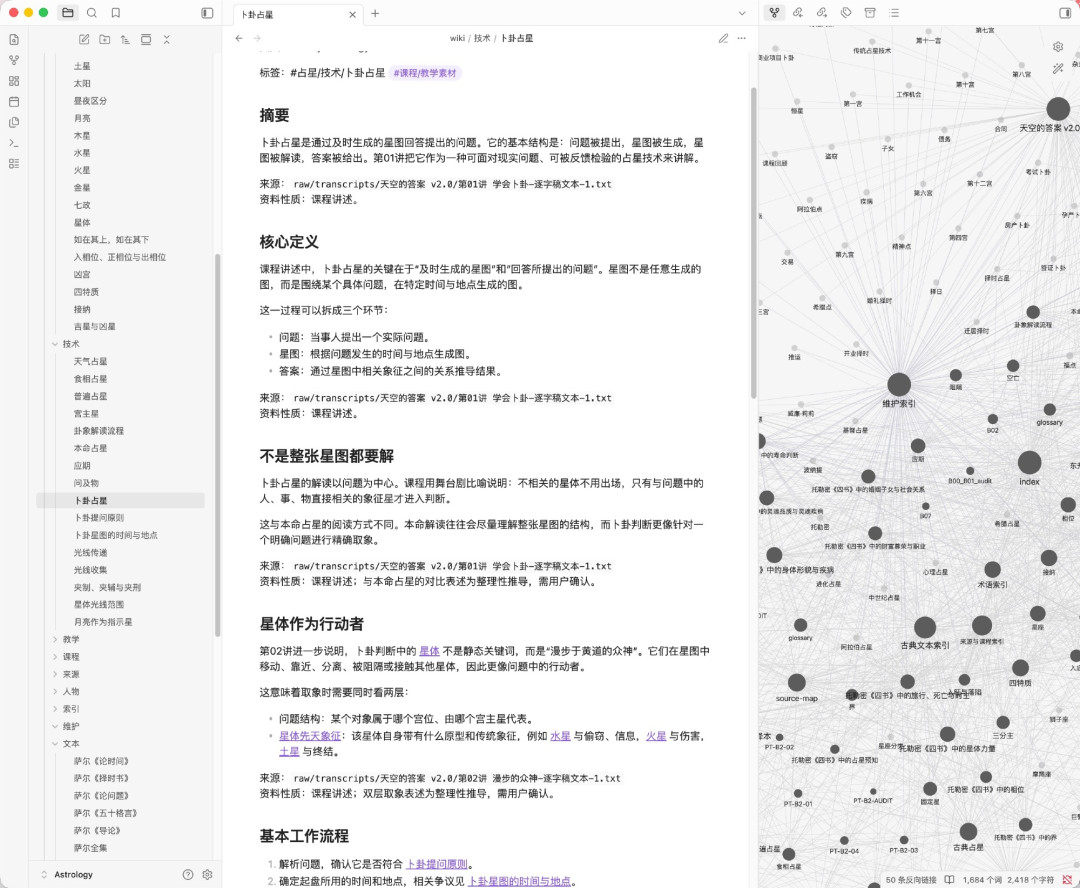
检索不到的宁可回答不知道,最怕的不是答不出,是编一个很像的答案。真正的坎在这之后:维护。刚把开源知识库项目玉衡(MIT协议)放出来的开发者总结,检索和问答已经不难搭了,难的是文档越积越多,同一份制度好几个版本,早过期的没人管,模型照样引用,“答得还挺像回事”。所以他专门做了"知识健康":重复检测、到期复审提醒、把"没帮助"的点踩记回对应文档。知乎知乎知乎
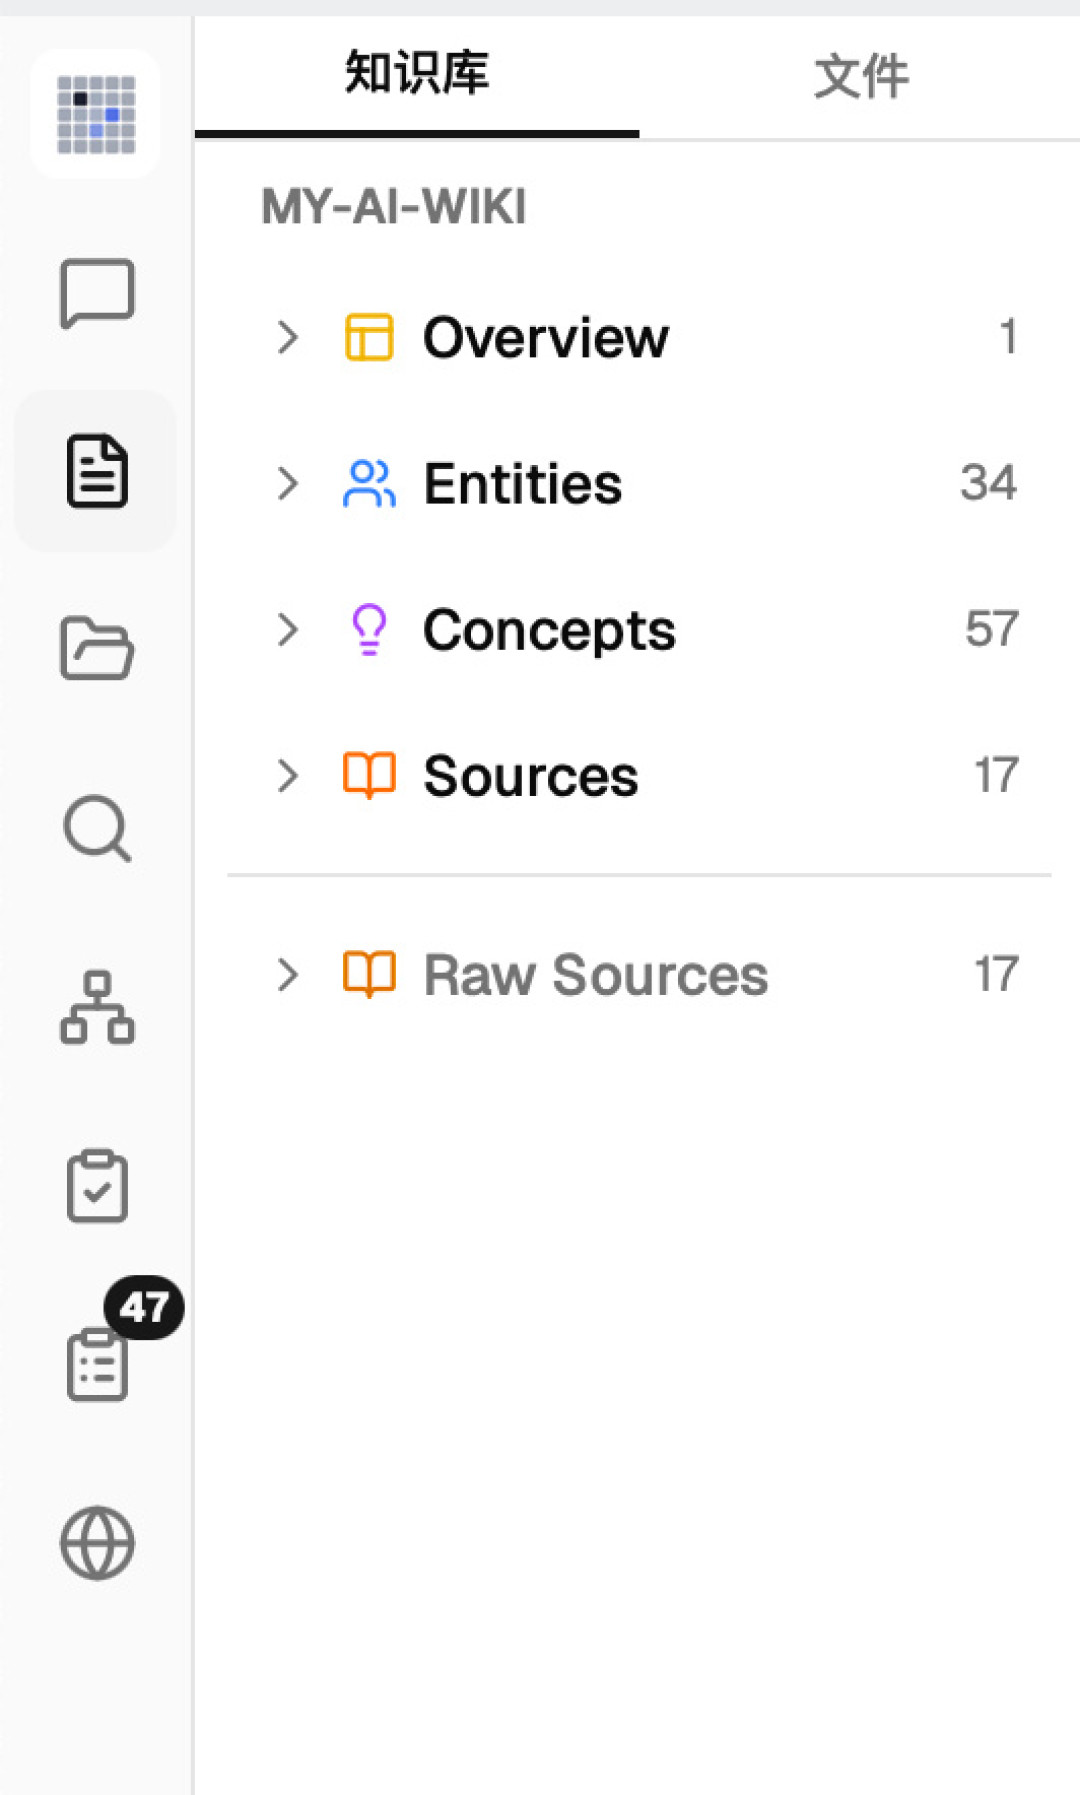
工具选型的风这两个月也变了。律所朋友问AI用得怎么样,最先担心的不是"AI不聪明",是"卷宗放上去,谁还看得见"——这正是本地化的理由。被Docker、WSL、端口报错劝退在第一关的人,现在已有Windows原生、双击exe就能跑起来的本地RAG工具可选。OpenCode v2带了一批免费模型,配Obsidian,是眼下普通人成本最低的本地知识库路子之一。个人电脑配置不高的,结论相当反高潮:对话模型中等大小、中文好的就够,加一个中文支持强的向量模型,剩下力气全花在整理资料上——一件事一份文件,文件名带上日期,按小标题切段。小红书小红书知乎知乎
最后就一个标准:把答案连同出处点开,原文能核对得上,才算搭好;核对不了的,先别上线。也别急着换更大的模型——这段做错了,模型越好,编得越像真的。知乎