在HuggingFace上刷到 Nanbeige4.3-33B 的时候,不少人以为是哪个欧洲模型——Nanbeige是啥?搜完才知道,这是BOSS直聘的大模型实验室「南北阁」。对,就是你那个用来投简历的App,自己发了个开源大模型。
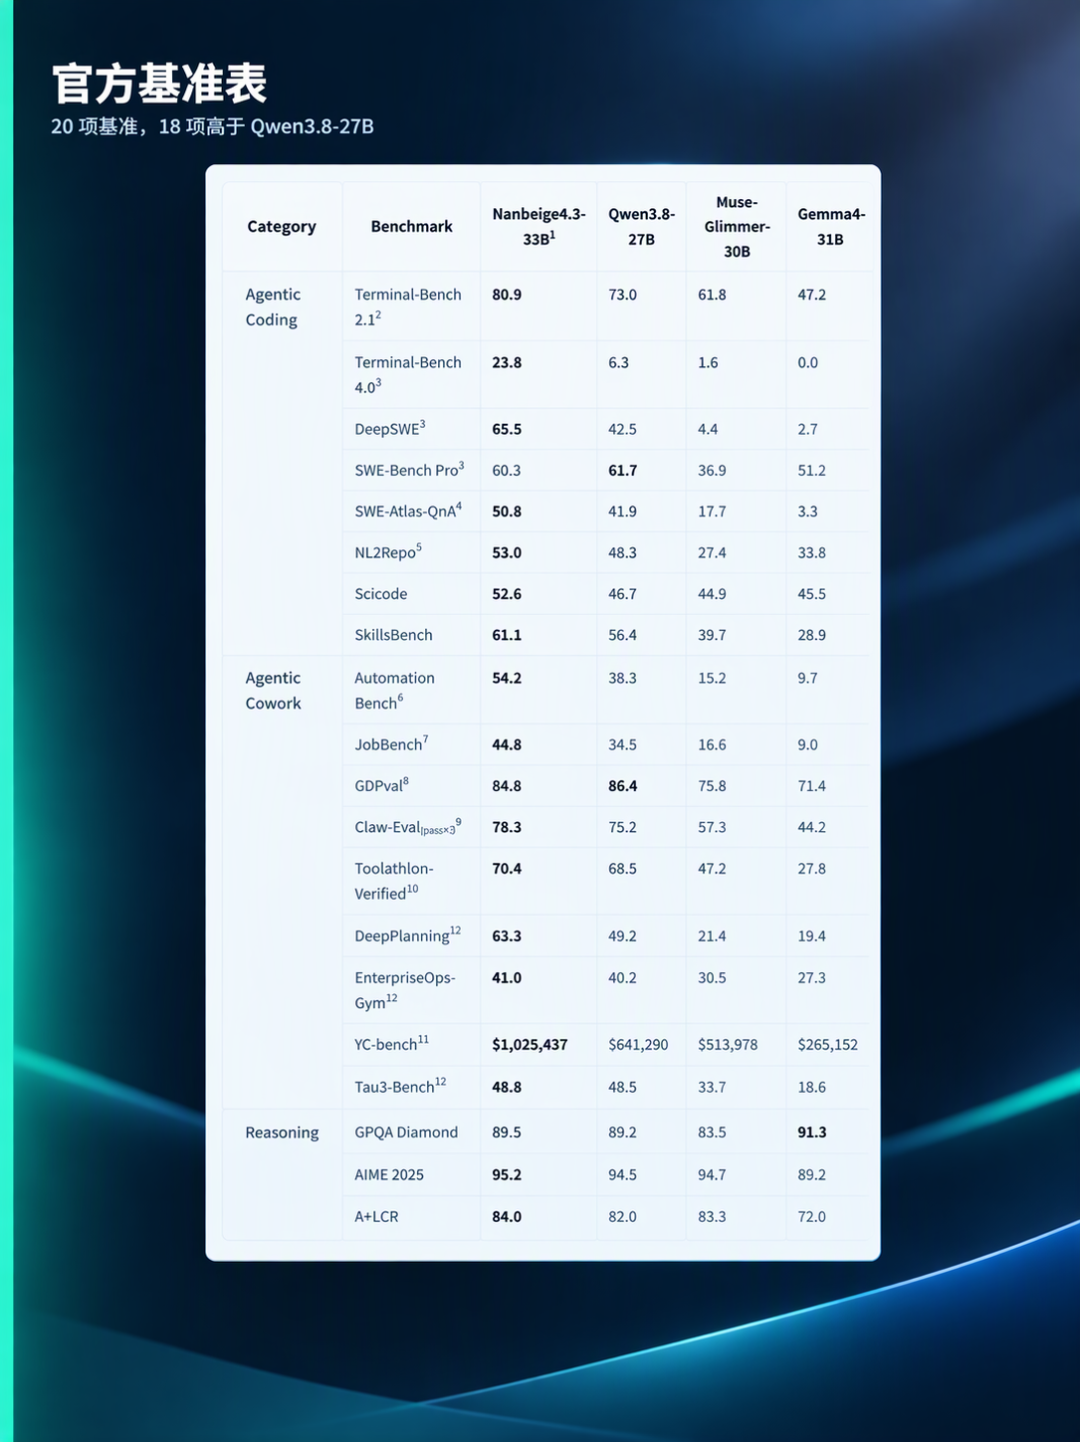
10月26日,33B指令版加Base基础权重全放了出来,Apache-2.0协议,512K上下文,官方在Terminal Bench、Automation Bench这批榜单上把Agent成绩做到了Qwen3.8-27B之上,次日hf-mirror上社区手搓的GGUF量化包就上架了。本地部署党的待测清单,一夜之间多了一号选手。哔哩哔哩知乎微博
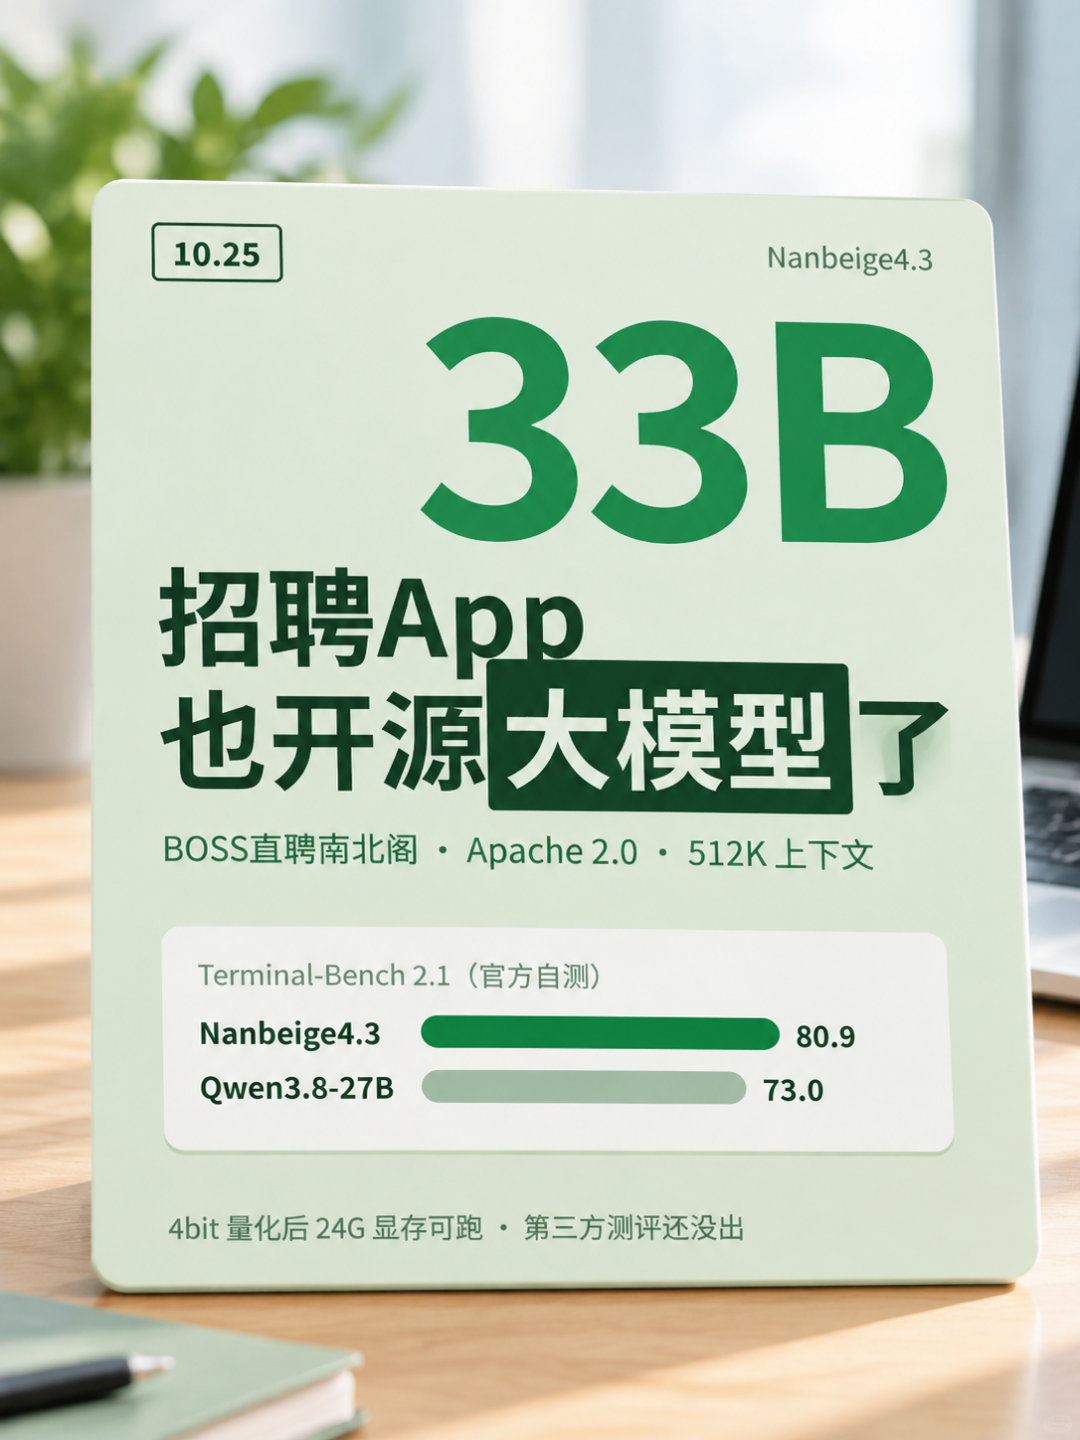
但别急着下载。评论区已经吵起来了:捧的喊"Agent专才终于来了",踩的说"写代码bug一堆,连个时钟都画不对"。先把结论撂这儿:这是个偏科生,不是全能替身。下不下,先算三本账。
第一本,显存账。 这次南北阁退回标准llama架构(全注意力+GQA),好处是几乎所有推理引擎都能直接跑,量化来得快。代价是33B Dense实打实吃内存。社区实测吐槽KV缓存是Qwen的4倍大,内置投机解码没有、只能靠外置MTP救;q3量化16GB显存塞不下——Qwen3.8-27B的q3可是刚刚好。长上下文这块也糙:没有动态YaRN,直接把旋转位置编码基数拉到1.2亿硬撑512K,上下文越长内存越烧。想跑,建议24GB显存起步,12G老卡这次真别凑热闹。微博
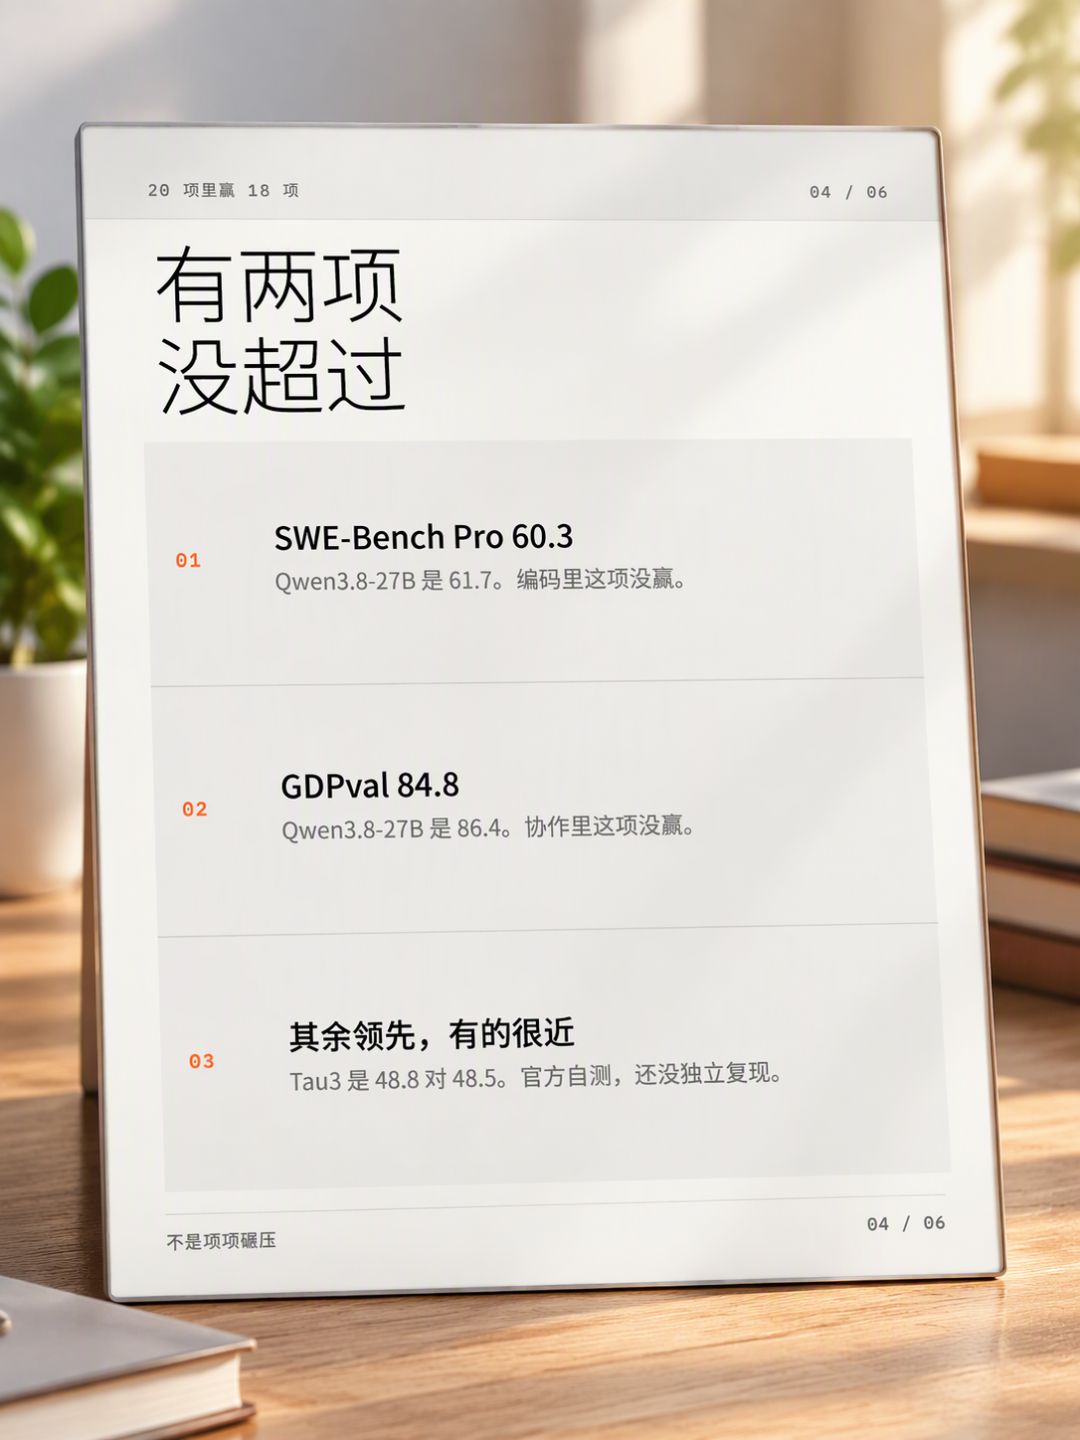
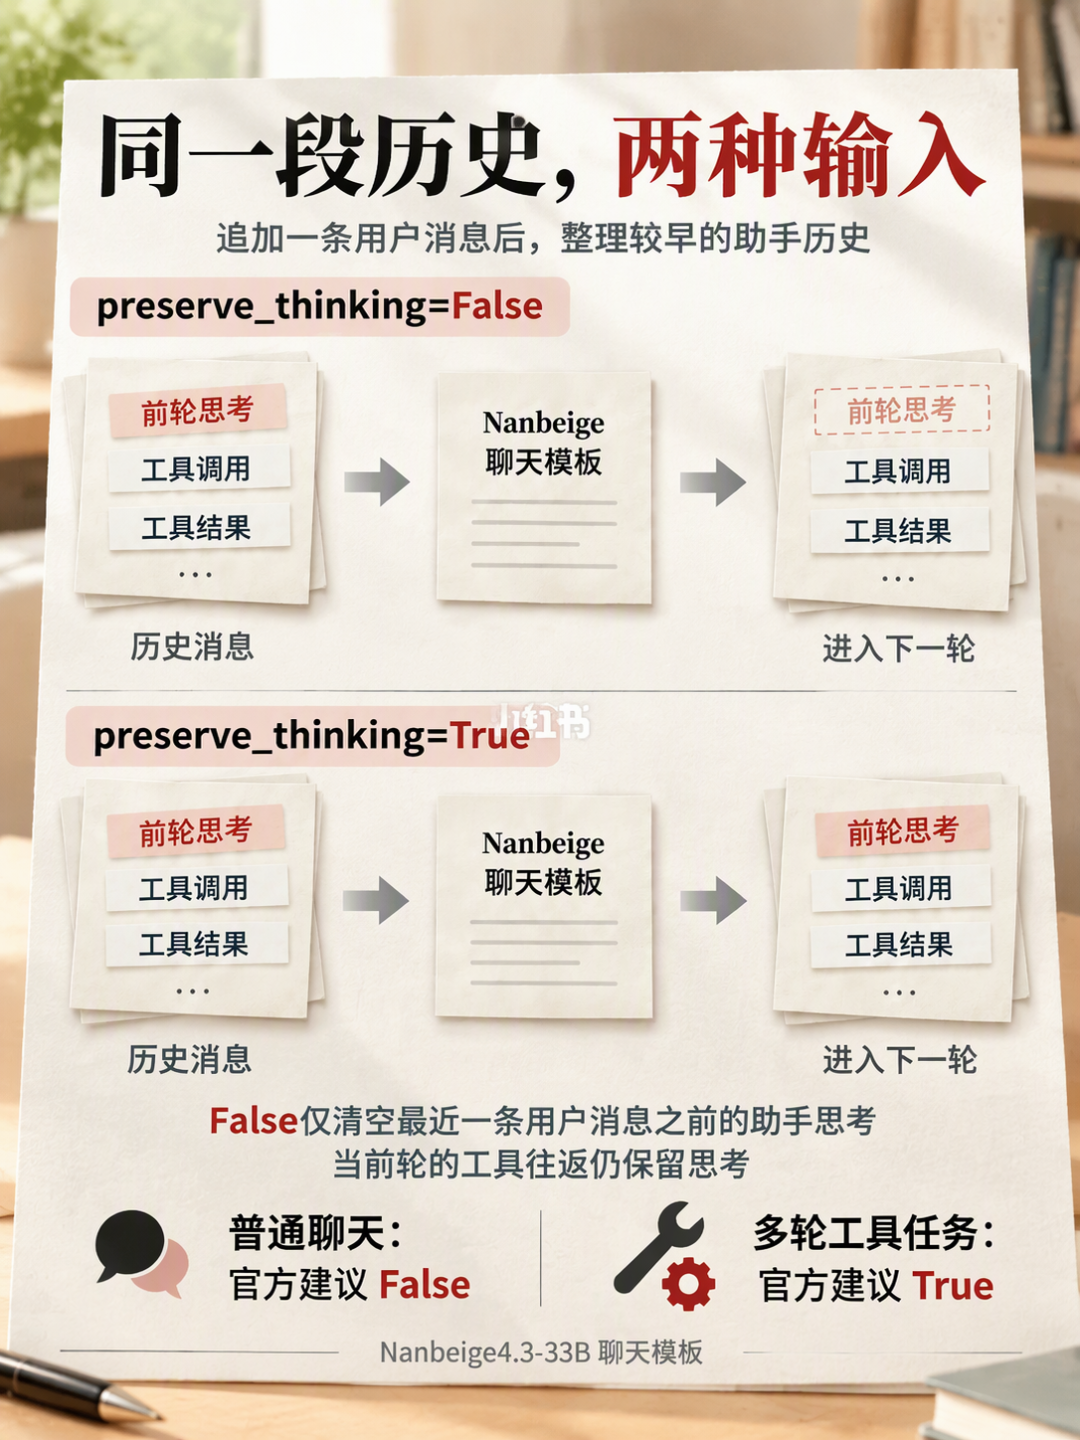
第二本,跑分账。 官方Agent成绩是真的,但有个细节:官方评测开着preserve_thinking(保留历史推理)跑分。接到自家框架里不把这个开关配好,分数大概率对不上榜单。而社区实测的另一面同样真实:写代码bug明显比Qwen3.8-27B多,画图测试连时钟都画不对,"赛博朋克鹈鹕"这种邪门测试也被安排上了。它的强项是多轮工具调用和办公/代码Agent任务,不是日常聊天写码的即插即用替身。知乎哔哩哔哩
第三本,定位账。 官方模型卡写得明白:33B是教师模型,3B蒸馏版还在计划里、没发。普通玩家的正确姿势是等蒸馏版落地;手里有24G以上显卡、正好折腾Agent的,才值得先入库试水——反正量化GGUF已经现成。微博知乎
上手前还有个白捡的细节:模型卡推荐XML工具调用格式(兼容JSON),enable_thinking管当前回复、preserve_thinking管历史轮次。官方建议普通聊天关后者、多轮工具和代码Agent场景开。这俩开关接对了,比换模型名重要得多。知乎
最后照例泼盆冷水:模型卡的评测由发布团队自报。效果方面只有社区实测,还没有独立横评。榜单发布只能决定"值得测谁",实际任务才决定"该用谁"。知乎