










13
10
44TB/s砍到38.5TB/s,英伟达图什么
2026-10-26 23:02:22
0点赞
0收藏
0评论
十月下旬,有人把两份规格文档摊在一起比了一遍:六个月前的一版,和这个月更新的一版。同一颗芯片,HBM4 内存带宽从 44TB/s 掉到 38.5TB/s,NVLink 从 7.2TB/s 掉到 6TB/s,而这颗芯片还没正式铺货。
上一代产品还在往上堆数字,这一代先往回退了一步,退得还不小。
这份对比流传开后,中文圈的反应基本分成两派:一派说英伟达压不住显存供应了,另一派说这是在给明年留后手。两种说法都只看了半张表。完整的那张表里,还有一栏是反着走的,那是网络带宽。
真正值得问的是另一件事:它为什么宁愿在纸面上难看,也要把这两个数字调下来。这件事牵扯到显存怎么造出来、推理到底卡在哪一环,以及你下一次选机器时该不该按旧表算。
降的是哪两条通道
先把对比的基准说清楚。这次比的是英伟达自己的规格文档,2026 年 10 月版对 2026 年 6 月版,后者有第三方存档可以逐行对照。
Vera Rubin 超级芯片这一档,HBM4 带宽 44TB/s → 38.5TB/s,降了 12.5%;同一颗芯片上的 NVLink 从 7.2TB/s → 6TB/s,降了约 17%。往下走到 HGX NVL8 整机方案,HBM 容量和带宽一起收:2.3TB / 176TB/s 变成 2TB / 130TB/s,带宽降了 26%,NVFP4 和 FP8/FP6 的训练算力也跟着下调,NVLink Switch 的 28.8TB/s 变成 24TB/s。
同一张表上,往外扩的那条网络通道是涨的。超级芯片的横向扩展带宽 0.8TB/s → 0.9TB/s,NVL4 那一档更明显,0.4TB/s → 1TB/s,等于翻了 2.5 倍;NVL8 的双向网络带宽从 1.6TB/s 提到 1.8TB/s。连 Vera CPU 那边的内存描述都改了,从"单颗 1.5TB LPDDR5X"变成"至多 1.5TB LPDDR5X",一个字的差别,把一颗芯片的内存配置从保证值改成了上限。
一条在收,另一条同时在放,而且放得更狠。这不像是随手改的错别字。
带宽为什么会被显存颗粒反推
要理解这个下调,得先知道 HBM 的带宽是怎么来的。一句话说清:显存带宽就是每秒能从显存里搬出多少数据,它等于颗粒的引脚速率乘以位宽,再乘以堆叠的层数。
拆开看,这三个乘数没有一个是软件能调的。位宽由封装决定,堆叠层数由键合工艺决定,引脚速率则由颗粒在特定电压和温度下能稳定跑多快决定。而一颗 HBM4 从晶圆到成品,要经过堆叠、键合、测试几道关,每一道都会筛掉一批。良率从来不是一个平均值,它是一条分布:跑得快的颗粒少,跑得稳的颗粒多。
规格表上的那个带宽数字,实际上是在跟供应链说"我要求你给我这个速率的颗粒"。要求定得越高,能达标的颗粒比例就越低,最后能装进机器的显存总量就越少。反过来,把要求往下挪一点,同一批产线上下来的颗粒,合格的那部分立刻变多,出货节奏也跟着松了。
公开报道里对这层逻辑的描述很直接:降低带宽门槛,能让更多 HBM4 满足 Rubin 的要求,从而提高最终产量。规格表上的数字变小了,能装进机器的内存变多了。
这就解释了它为什么敢降。它让出的不是计算能力,而是自己对供应链的筛选标准。
推理到底卡在哪一环
那砍掉 12.5% 的带宽,跑模型会不会真的变慢?这要看你的负载停在哪一段。
大模型推理分两截。一截是把你的输入读进去、算出第一句回复要多久,这一段主要是矩阵运算,吃的是算力。另一截是逐字往外吐,每吐一个 token,都要把模型权重从显存里完整读一遍,吐字这一段是被带宽管着的。
vLLM 团队在十月初的技术博客里写得很实在:MoE 结构在 decode 阶段受限于从 HBM 读取权重,所以他们的优化方向是提高显存吞吐,而不是提高算力利用率。他们用 CUDA 13.4 的 locality domain 把 MoE 权重按列切成两半,让每个 SM 只读离自己最近的那一半显存,实测在小 token 前向时平均有 1.2 倍的加速。
这里有个容易被忽略的细节。默认创建 locality domain 时,212 个 SM 里只有 200 个能进两个等分域,剩下 12 个闲着;要开启 backfill 模式才能全部用上。同一个硬件上,软件配错一个开关,就白扔 6% 的算力,这跟工厂里少开一条产线是一个道理。
所以带宽当然重要,但重要性得放在对比里看。同一批博客里还有另一组数:Rubin NVL72 的单卡 HBM 带宽仍约为 GB200 NVL72 的 2.4 倍,双向 NVLink 带宽约 1.7 倍;在 AgentX 这套智能体负载上,vLLM 跑 MiniMax M3 拿到 7.84 倍于 GB200 的单卡吞吐,MLPerf v6.1 的视觉语言模型测试里比 GB300 NVL72 高 3.7 倍。
砍完之后,它还是比上一代快一大截:规格表上的上限收窄了,交付出来的吞吐没有跟着掉。
网络那一栏反着涨,才是信号
真正让我多看两眼的,是 scale-out 那条线。
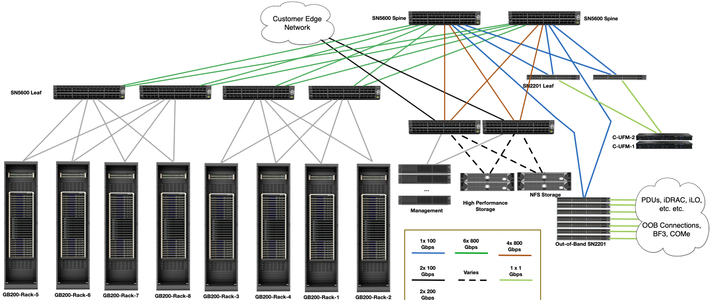
NVLink 管的是机柜里卡与卡之间的通信,是纵向的;scale-out 网络管的是机柜与机柜之间,是横向的。这次纵向收紧、横向放开,方向很清楚:重心从"把更多卡塞进一个机柜"往"让更多机柜连成一片"偏。
原因不难猜。单机柜的功率和散热已经顶到天花板,再往里塞卡,供电和冷却先不答应。而超大规模的推理集群,本来就更像一片连起来的机房,而不是一台被放大的计算机。
这里我要把边界划清楚。这一段是我的推断,依据是规格表的变化方向,不是英伟达的官方说法;规格表能证明方向变了,证明不了动机。真要确认,得等他们把架构文档写全。
两个容易看反的地方
先说第一种:参数降了就是性能砍了。
这个说法有它的道理,纸面峰值确实低了,HGX NVL8 那一档连训练算力都往下调,看惯"每代必涨"的人当然会觉得不对劲。
但它解释不了两件事:一是对比基准,二是实测。跟上一代比,它的带宽仍是 2.4 倍;跟实际负载比,那 7.84 倍的单卡吞吐是在带宽下调之后测出来的。更要紧的是,被下调的算力和带宽都属于"规格上限"这一类数字,而真正决定你账单的,是这批货能不能按时到、到了能不能跑满。
更准确的理解是,这是一次把纸面指标换成交付数量的交换,代价写在规格表上,收益写在出货单上。
第二种误读更常见:带宽越大,模型跑得越快。
这话在 decode 阶段成立,出了这一段就不一定,而且它没说 batch 多大、上下文多长、用的什么精度。
问题在于它把三种不同的瓶颈混成了一种。小批量吐字时卡的是带宽;大批量读长文档时卡的是算力和 KV cache 的容量;多卡推理时卡的是互联和网络。同样一颗芯片,换个负载,瓶颈就换了位置。你按带宽选机器,很可能买到一台在你自己场景里根本跑不满带宽的机器。
落到你身上,看三个数就够
如果你在做选型,这次调整给了三个更实用的观察点。
先看单卡显存容量,别看带宽。容量决定你能装多大的模型、开多长的上下文,这是硬门槛,降不下去;带宽决定你吐字有多快,快慢还能靠批处理和调度补一部分。顺序别搞反。
至于机柜内互联和机柜外那条网络,最近被加强的是外面那条,说明未来两年的扩展方式更可能是多机柜堆规模,你的机房网络规划得跟着改。
最后一件事比规格表本身更要紧:量出你自己的负载形状。平均 batch 多大、上下文多长、用的什么精度,这三个数一出来,你就知道该往带宽上花钱还是往容量上花钱。拿 6 月那版表做的容量规划,现在该回去核一遍:规格本身没有变差,是旁边多了一栏变好的数字,配置的重心可能得挪。
需要提醒的是,这些数字全部来自公开规格文档的版本对比,加上框架团队自己公布的测试结果,到手性能还要看固件、驱动和框架版本。规格是上限,实测才是你的现实。
至于这次下调到底是精算还是无奈,我倾向于前者,理由就是那条反着涨的网络线:一个被供应卡住的人,不会同时去加另一条通道的预算。
如果你手上有一份按旧版规格表做的容量规划,这次值得回去动一个数字;我更想知道的是,你们那边最先撞上的瓶颈,是显存容量还是带宽?
作者提示含AI生成内容。作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~