



















 深耕数码、AI兴趣领域





15
28
Venice开始全面供货,深度解析AMD Zen 6架构
2026-11-11 22:11:23
0点赞
0收藏
0评论
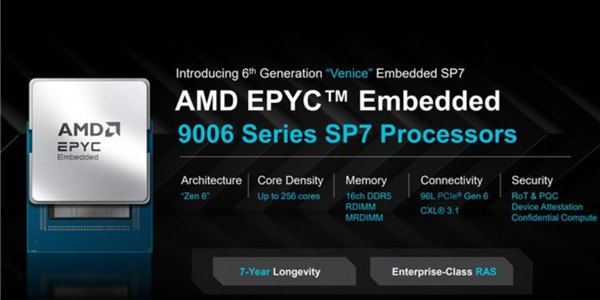
AMD正式宣布其第六代EPYC CPU(代号Venice)开始全面供货,这一代产品专为“AI智能体时代”而设计。此外,AMD完整披露了面向EPYC Venice CPU的Zen 6架构。

AMD Zen 6和Zen 6C核心架构今年随EPYC 9006 CPU家族首次亮相,该家族代号为 Venice,是Zen 5和Zen 5C架构的继任者。与Zen 5和Zen 5C一样,Zen 6和Zen 6C基于相同的指令集架构(ISA)。Zen 6是经典核心版本,而Zen 6C则是密度更高的核心版本。

Zen 5是对AMD Zen核心的一次彻底重新设计,Zen 6既不是对Zen 5的小幅优化,也不是一次彻底的架构重新设计。AMD似乎是把所有能调的旋钮都调到了最高档位,而从性能表现来看,这种做法确实奏效了。
AMD Zen 6微架构
AMD Zen 6Zen 6C在取指(fetch)和流水线(pipeline)方面采用两个基本模块,配8 路宽度的调度/重命名单元、6个ALU、4路加载/2路存储单元、512位浮点数据通路、2个周期的浮点加法(FADD)、64字节的缓存填充/逐出带宽,以及48K的数据缓存。

总体来看,Zen 6带来了以下改进:
更大的操作缓存(Op-cache)
更大的返回地址栈(Return Address Stack)
更大的浮点/整数调度器(FP/INT schedulers)
更大的加载/存储队列(Load/Store Queues)
更大的重排序缓冲区(Reorder Buffer)
更强的指令融合能力(OP Fusion)
更低的分支误预测延迟
4倍的VNNI INT8流水线

分支预测方面进行了多项优化:预测表得到优化,返回地址栈容量增大至64项,分支预测队列也随之扩容;支持每周期2次取指预测,以及每周期最多3个预测窗口。前端方面,取指带宽达到64B/周期,并优化了双指令流取指;操作缓存容量提升至6.75K,每周期最多可交付18条指令,调度单元宽度为8路。L1I指令缓存为32KB(8路组相联)。

在调度与执行方面,Zen 6支持8路宽度的重命名与提交。通过分布式整数调度器提升了容量,其中包括96个共享的ALU/AGU单元和48个专用ALU。执行窗口也进一步扩大:物理寄存器文件达到352项,重排序缓冲区达到640项。每个核心总计配备6个ALU(含2个乘法器)、3个分支单元,并增强了指令融合能力。

再看数据带宽路径方面,Zen 6配备了48 KB、12路组相联的L1D数据缓存,加载延迟为4个周期。带宽也得到了提升:拥有4条加载/存储流水线,支持每周期混合执行4次加载和2次存储;与L2缓存之间的填充/逐出带宽为64B;并支持4×256位加载。TLB(地址转换后备缓冲器)方面,L1 TLB为96项,L2为4K DTLB(覆盖除1G大页以外的所有页面)。
Zen 6还配备了更大的在途窗口:加载队列扩容至80项,存储队列扩容至128项,并采用了可扩展的加载排序队列。此外,每个核心还配备了1 MB(16路组相联)的L2缓存。

在数据类型和流水线方面,Zen 6和Zen 6C保持一致,均支持相同的AVX-512、FMUL/FMAC+FADD、FMAC/FMUL/FADD延迟、VNNI-INT16、BFLOAT16以及浮点存储带宽(FP Store Bandwidth)。
发生变化的是FP16数据类型:现在支持完整的AVX-512 FP16计算、位矩阵乘法指令、4条VNNI-INT8流水线(此前为2条)、3组各46项以上的浮点调度器(此前为3组各32项),以及2条512位或4条256位加载通道(此前为任意宽度的2条加载通道)。

Zen 6和Zen 6C核心面向不同的细分市场而设计:Zen 6的每个CCX(核心复合体)最多可扩展至12个核心,配备最多48 MB的L3缓存;而Zen 6C的每个CCX最多可扩展至32个核心,配备最多128 MB的L3缓存。

在Zen 6C中,每个核心都拥有自己独立的、速度更快的1 MB L2缓存,而128 MB(16路组相联)的L3缓存则由整个核心复合体中的全部32个核心共享。L3通过接收L2的逐出数据来填充,同时L2的标签会在L3中保留一份副本,用于探听过滤和快速的缓存数据传输。每个核心从L2到L3最多支持127个未命中请求,而从L3到系统内存则最多支持1280个未命中请求。
缓存规格一览:
Zen 6 L1I(指令缓存):32K(8路)
Zen 6 L1D(数据缓存):48K(12路)
Zen 6 L2:1 MB(16路)
Zen 6 L3:48 MB(16路)
Zen 6C L3:128 MB(16路)

AMD表示,Zen 6针对最大化插槽性能进行了优化,而Zen 6C则针对最低延迟进行了优化。与Zen 5相比,Zen 6提供了更多的核心数、更高的频率、大幅提升的IPC,以及更高的能效/每核心线程效率。具体对比如下:

相比Zen 5,核心数和缓存容量的提升均为2倍,而更高的频率则是性能增益的另一大来源。得益于N2P制程节点,Zen 6C的频率提升了400 MHz;而4倍的缓存容量也将为云计算数据中心带来更大的收益。

标准版Zen 6架构的核心/线程数量提升了50%,同时保持了每核心相同的L3缓存容量。缓存总量增加了50%,而频率300MHz的提升也是一次扎实的代际增长。
Zen 6 IPC,又一次重大突破
以上所有改进最终带来了又一次惊人的IPC提升。AMD表示,在AI和服务器工作负载中,Zen 6C的IPC提升约27%(对比对象为标准的Zen 5架构)。

细分来看IPC提升:在企业级/云计算工作负载中,Zen 6C带来了20%的提升;而在AI工作负载中,相比上一代“经典”架构,提升幅度达到了31%。此次IPC测试的条件是:将16个核心分布在两个CCD上的Zen 5,与16个核心集中在一个CCD上的Zen 6C进行对比,频率固定。

AMD Zen 6:面向SP7插槽的Venice SoC
随着第六代EPYC的推出,AMD同步发布了下一代SP7插槽,并配备了两款不同的 SoC:一款基于Zen 6设计,另一款基于Zen 6C设计。

两款SoC均采用总共8个CCD的设计,差异在于核心配置。Zen 6C的每个CCD最多包含32个核心和128 MB缓存,因此单颗芯片最多可提供256个核心和1024 MB(1 GB)的L3缓存;而Zen 6的每个CCD最多包含12个核心和48 MB的L3缓存,单颗芯片最多可达96个核心和384 MB的L3缓存。
Zen 6 SoC:最多8个CCD,每个CCD最多12个核心 / 单芯片最多96个核心;每个CCD 48 MB L3 / 单芯片最多384 MB L3。
Zen 6C SoC:最多个CCD,每个CCD最多32个核心 / 单芯片最多256个核心;每个CCD 128 MB L3 / 单芯片最多1024 MB L3。

每个核心配备总计1 MB的L2缓存,因此Zen 6芯片的L2缓存总量为96 MB,而Zen 6C SoC则达到256 MB。这些芯片在设计时以每个SoC的NUMA性能为侧重点(支持 NPS1,NPS4则视具体型号/OPN而定)。每颗芯片均采用第五代Infinity Fabric互连技术,并采用了低功耗SoC设计,配合先进封装技术实现芯粒间通信。

芯片配备了两个基于N3制程工艺的大型IO芯片(IOD)。在双路配置下,最多可提供128条PCIe Gen6通道(每条64 Gbps)以及额外16条PCIe Gen4通道;单路配置则提供96条Gen6通道和额外8条PCIe Gen4通道。IOD支持PCIe通道分拆,可分为x16、x8、x4和x2。此外,IOD中还集成了SDCI(智能数据缓存注入,Smart Data Cache Injection)和SDXI(智能数据加速接口,Smart Data Accelerator Interface)。

每个IOD支持8通道DDR5内存,最高可支持12.8 GT/s的MRDIMM(每通道1条内存,即1DPC)。每个IOD还配备48条64G SerDes通道和8条16G SerDes通道。分拆式IO设计允许扩展拓扑结构,以满足更多通道数、更高带宽和更高I/O需求,同时改善服务质量、流量分布,以及面向IO与安全的控制逻辑和控制器中枢。
AMD 还进一步扩展了其芯粒架构,通过快速的总线P-State切换和用于芯粒间互连的Elevated Fan-Out桥接(EFB)技术,在提升吞吐量的同时获得更好的能效。EFB可将每比特能耗(pj/b)大幅降低,从而降低延迟,并提供更高的每核心功耗空间。
Zen 6还针对各种功耗区间进行了优化,以实现最大性能、每瓦性能、每核心性能以及总体拥有成本(TCO)的最优平衡。
在AI智能体工作负载中,默认CPU功耗最高调至400W,利用率在50%-100%之间。此时每个核心的功耗为1.2-2.0 W,重点在于计算密度、每瓦性能和每兆瓦线程数(threads/MW)。

在云计算/MDC(模块化数据中心)工作负载中,AMD的Zen 6核心针对峰值吞吐量进行了优化,并保持每核心性能的平衡。此类场景下,默认最大功耗设为600W,利用率为30%-100%,每核心功耗约为1.7-3.5W。这提供了最高的每TCO性能和均衡的每核心性能。
在AI智能体和云计算工作负载中,AMD主推其配备256个Zen 6C核心的产品。而面向主机节点的“Helion”、HPC和客户端细分市场,AMD则采用经典的Zen 6核心,默认CPU功耗为500W-600W。在此类场景中,每个核心的利用率在15%-100%之间,核心功耗在5-10W以上。这让Zen 6能够在更宽的动态范围内扩展,适应突发式、低延迟的使用场景,同时频率可突破5 GHz。
AMD Zen 6:面向SP8插槽的Venice SoC
除了SP7插槽外,AMD还推出了主流定位的SP8插槽,针对双路和单路配置进行了优化。在SP8平台上,Zen 6C配置将配备4个CCD,最多提供128个核心 / 256个线程和512 MB缓存;而经典版Zen 6将配备8个 CCD,总计96个核心 / 192个线程和384 MB的L3缓存。

在平台层面,SP8将采用紧凑的插槽设计,尺寸为62.5 × 80毫米。内存方面支持8通道DDR5(SP7则为16通道),同时保留了相同的MRDIMM支持,速度最高可达12.8 GT/s。

IO方面,双路SP8配置最多提供192条Gen6通道和最多16条额外的Gen4通道;单路SP8配置则最多提供128条Gen6通道和最多8条额外的Gen4通道,此外还支持CXL 3.1。
功耗方面,SP7平台将支持最高600W的OPN型号,而SP8则支持最高400W的型号。内存峰值带宽方面,使用RDIMM时为512 GB/s(SP7为1 TB/s),使用MRDIMM 时为819 GB/s(SP7使用MRDIMM时为1.6 TB/s)。SP8的单插槽IO峰值带宽更高,达到2.0 TB/s(SP7为1.5 TB/s)。

AMD Venice:内存、IO、功耗、RAS与安全特性
接下来谈谈内存方面,它与CPU本身同样重要。AMD的SP8和SP7平台将支持广泛的技术,包括DDR5 MRDIMM Gen2、DDR5 RDIMM、LPDDR5X SOCAMM2、CXL 3.1和MEXT。

首先看DDR5 MRDIMM Gen2,EPYC Venice将支持最高12,800 MT/s的速度,在SP7平台上支持16通道(每通道1条内存,1DPC),在SP8平台上支持8通道(1DPC)。这一下一代内存标准将可实现最高1.6 TB/s的带宽。
EPYC Venice平台同时支持标准的DDR5 RDIMM,速度最高可达8000 MT/s。在16通道配置下,聚合带宽最高可达1.0 TB/s;并且在SP7和SP8平台上,单插槽容量最高可达8 TB。

CXL 3.1搭配PCIe Gen6支持,在SP7平台上每插槽最多可扩展至96条通道,在SP8平台上则最多128条通道,每x16可提供最高128 GB/s的原始带宽,延迟仅相当于一次NUMA跳转。AMD表示,CXL是一个TB级的内存层级,每GB成本降低87%,并且无需任何应用改动即可兼容使用。

Zen 6核心还提供了改进的RAS(可靠性、可用性、可维护性)和安全特性。它是首个采用开源Caliptra 1.2 ROT的x86架构,甚至还具备面向AI智能体的安全就绪能力:

应对数据中心功耗三难困境
AMD还试图解决数据中心面临的功耗利用难题,并已识别出三大关键挑战。

第一个挑战是“搁浅功耗”,即机架容量的15%-25%处于闲置状态,而整个数据中心可能有成千上万个机架,这导致资本支出被套牢浪费。
第二个挑战是空闲/低利用率状态下的功耗流失。即便机架处于轻负载状态,仍会消耗约峰值功耗60%-70%的电力。固定的PPT(封装功率追踪,Package Power Tracking)意味着机架全天候处于最大功耗状态,而调低功率上限又可能损害性能。

第三个挑战是SKU泛滥,为了匹配不同层级的组合需求,需要2-3倍的SKU数量。高端虚拟机(Premium VMs)需要高频率的核心,而批量虚拟机(Batch VMs)则需要更多的核心。当季度中途各层级的需求发生变化时,就会造成硅片资源和资金的闲置浪费。
AMD提出了三项关键的功耗技术来应对这些挑战:UPP、UBPS和FAST。其中,UPP(Unified Power Provisioning,统一功率配置)可以回收被搁浅的机架容量,使每个机架能够部署更多服务器,从而提升CPU的每TCO美元性能。

UBPS(Utilization-Based Power Scaling,基于利用率的功率调节)允许功耗根据活跃核心数量进行扩展,在典型利用率下降低功耗,并在负载突发到来时释放全部功率。

最后是FAST(Frequency-Adaptive Spectrum Tech,频率自适应频谱技术),它能为每组核心设定一个频率下限,将高端与非高端核心整合在同一颗SoC中。本质上,这项技术让一颗CPU能够同时提供多个性能层级。

Venice在HPC、云计算、企业级和AI细分市场实现性能提升
Zen 6架构的所有这些改进带来的结果是:EPYC 9006 “Venice” 相比前几代实现了惊人的性能提升。

AMD宣称,EPYC 9006在通用计算方面相比第一代EPYC芯片实现了约20倍的性能提升,在科学计算方面提升了18.6倍,内存带宽提升了9.6倍,并且具备颠覆性的竞争优势。

单看内存带宽,EPYC Venice(采用DDR5 MRDIMM)的峰值带宽堆叠可达1.600 TB/s,而英伟达的Vera CPU(采用LPDDR5X SOCAMM2)则为1.2 TB/s。
即便使用8000 MT/s的RDIMM,Venice实现的带宽也超过了配备8800 MT/s第一代MRDIMM的英特尔Granite Rapids-AP(0.844 TB/s对比1.0 TB/s)。不过,英特尔明年也将支持第二代MRDIMM内存。

在HPC方面,Venice带来了11倍的提升,几乎是Turin提升幅度的两倍。在完整的性能披露中可以看到,Venice相比英特尔的Granite Rapids平均实现了2.2倍的性能提升,最高可达3.20倍。

即便是核心数少25%的SKU,也能比英特尔顶级的128核Granite Rapids至强芯片带来1.6倍的优势。这里的对比是至强6980P(128核)对EPYC 9686F(96核)。

在核心数相近的SKU对比中,AMD EPYC Venice CPU平均能带来1.9倍的性能提升。这一领先优势几乎是相同核心数的AMD Turin(Zen 5)CPU的两倍。

另一个有趣的测试是EPYC Venice得出结果所需的时间。由于Zen 6的模拟特性更快,相比相同核心数的Turin芯片,能够实现2.8倍的天气预报速度提升。128核的Turin需要5.22小时才能完成的计算,96核的Venice仅需3.49小时即可完成,而256核的Venice更是将时间大幅缩短至仅2.66小时。在为期5天的预报中也看到了类似的结果。

药物发现模拟在Venice上也能更快完成,100纳秒的模拟比Granite Rapids整整提前4月完成。256核的Venice芯片只需57天,96核的Venice芯片需要97天。相比之下,128核的Turin芯片需要114天,而英特尔的Granite Rapids则需要182天。汽车模拟和空气动力学仿真方面,Venice也有类似的提升。

AMD还表示,与英伟达的Vera CPU相比,Venice能提供更高的每兆瓦线程数(最高2.9倍)、更高的每兆瓦性能(最高2.0倍),以及更高的每机架核心数。

接下来是AI基准测试,Venice是一款专为先进的AI智能体工作负载从零开始打造的芯片。

性能提升同样惊人:相比EPYC Turin(Zen 5)最高提升1.5倍,比英特尔的Granite Rapids至强CPU最高快4.4倍。AMD还将其在HPC和AI方面的领先优势与AWS的Graviton5进行了对比,宣称领先幅度达到3.0倍,而其现有的Turin芯片性能已经比对方高出60%。

随着Venice家族正式全面上市,AMD为AI智能体时代交付了一次重大的架构飞跃。约27%的IPC提升、大幅增加的核心数量、更为充裕的缓存,加上全新的SP7/SP8平台,再辅以更智能的功耗管理以及新一代内存与IO技术,这些因素共同使EPYC 9006成为密集云计算、高性能计算和AI工作负载中极具竞争力的选择,同时在性能、效率和总体拥有成本方面为客户带来实实在在的优势。









