

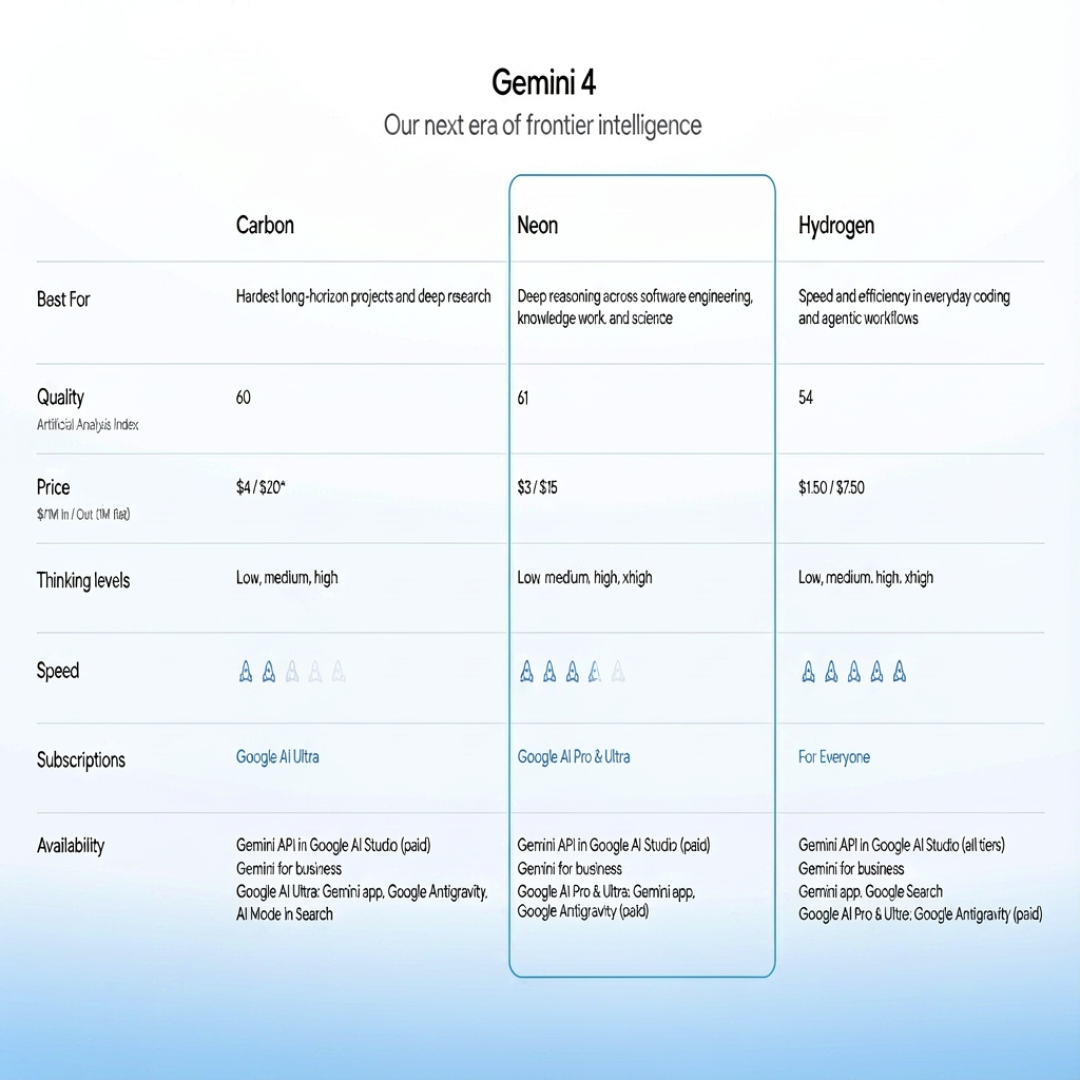
11 月 18 日,谷歌发布 Gemini 4 家族的第四款模型 Neon。它卡在 Hydrogen 与 Carbon 之间,面向复杂编程、知识工作与科研,给出的口号是「质量匹配或超过 Gemini 4 Carbon,速度是 3 倍,成本只有 60%」。知乎知乎知乎知乎
「快 3 倍、省 4 成」这句口号,对照官方博客和 Artificial Analysis、Arena、Vals 的第三方数据拆开看,是四本口径不同的账:省时省钱的成立对象主要是自家旗舰 Carbon 和 Opus 5.5;如果你在用 GPT-6.2 Sol 这类更便宜的模型,换过去反而多花钱;而最大的省钱开关根本不是换模型,是思考档位和缓存命中。
一、省的时间,在「等」和「返工」两件事上
把整个任务跑完的总时长,第三方给了官方口径一个印证:跑完整套智力测试,Neon 默认 high 档只用 14.8 分钟,Carbon 磨了 34.2 分钟,省了一半还多。知乎
首字等待的差距更直接:AA 的整套测试里,Opus 5.5 每题平均花 10.04 美元、等首个字要接近六分钟,Neon 最重 xhigh 档单题 6.44 美元、56 秒出首字,吐字每秒 110 个 token。知乎
返工轮次是科研和工程用户真正的时间成本:AA 测出 Neon 的不幻觉率 86%,同一套题 Opus 5.5 只有 50%。谷歌自家测试里它走捷径的比例还是全系最低的 2.45%。结果一次能交付,来回改稿的时间才真正省下来。知乎知乎
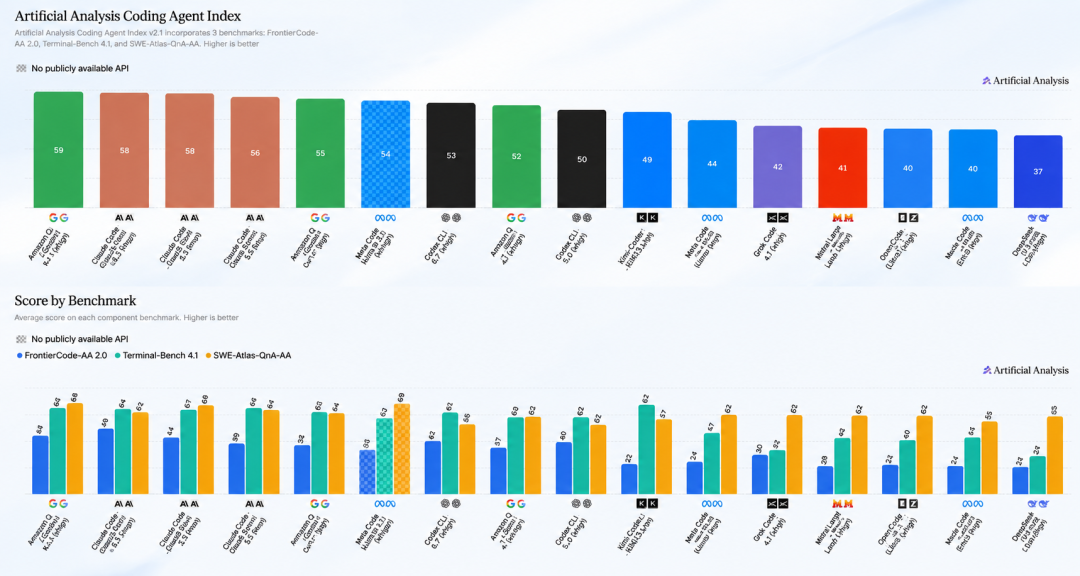
但「3 倍」不是对所有人成立:AA 同时直言 Neon「单任务明显偏慢,而且非常啰嗦」——评估中它生成了 283M token,是同类模型中位数 65.1M 的 4 倍多。所谓快 3 倍,是相对自家旗舰 Carbon 和 Opus 5.5,不是全行业第一。知乎
二、钱要算两本:标价一本,单任务成本一本
标价按每百万 token 计,Neon 输入 3 美元、输出 15 美元,缓存输入低至 0.15 美元,上下文 100 万。同一口径下 GPT-6.2 Sol 是 $2/$10、Claude Opus 5.5 是 $4/$20,Neon 恰好夹在中间。知乎知乎
谷歌真正想让你看的是任务级数字:编码 Agent 榜单第一,单任务成本比 Carbon 低 32%,标价比 Opus 5.5 低 25%。知乎
第三方 AA 的每任务均摊成本把差距摊得更开:跑完整套测试后,Opus 5.5 每题平均 10.04 美元。而 Neon 默认 high 档花 3.74 美元就能拿 60 分。知乎知乎
Arena 的真实会话中位数账单是同一结论:Neon 每单 2.82 美元,比 Opus 5.5 省 53%。知乎
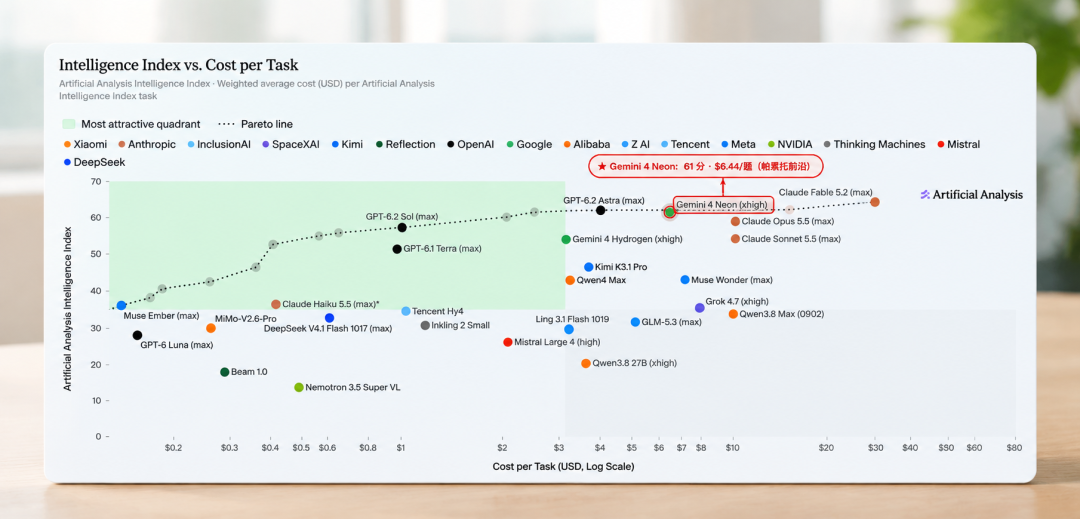
时间窗口会翻转结论:Carbon 促销价 $2/$10 到 11 月 30 日截止,12 月 1 日起回到 $4/$20——11 月内 Carbon 的单价反而比 Neon 便宜,12 月起 Neon 才比它便宜 25%。促销期盲切,按标价算反而贵一半($3/$15 对 $2/$10)。知乎
入口资格还有一本隐性账:官方博客只写了付费档和订阅用户,没提免费层。20 美元一档的 Pro 订阅能用 Neon,但与 Hydrogen 共用额度池、消耗约为后者的两倍。有开发者实测一个复杂前端任务就要吃掉 5 小时额度的 10%。重度科研用户为省钱开订阅前,得先算额度池够不够烧。知乎知乎知乎
三、科研端:强项确实落在专项任务上
官方跑分直指科研:Terminal-Bench Science 70.5%、RiemannBench 84.0%、HLE-Diamond 71.3%,三项自称同级最佳。知乎
第三方 Vals 按 GDP 加权任务分布的读数更细:Neon 70.87% 对 Claude Fable 5.2 的 71.31%,差 0.44 个百分点,落在置信区间内,统计上是平手。知乎
结构上 Neon 在法律、税务、科研三块明确更强,在终端操作和代码迁移上偏弱。和科研习惯最搭的是缓存账:反复分析同一批文献,缓存命中后,10 万输入加 2 万输出的单次任务能从约 0.6 美元压到 0.315 美元。知乎知乎
四、划不划算,换之前先过三个条件
第一,档位。从 high 提到 xhigh,只多 1 分(60 对 61),成本却涨 72%、时间多 45%;medium 档花 1.90 美元拿 55 分,是 xhigh 成本的三分之一,却有它九成的分数。宣传页上的 61 分正是最高档的成绩。知乎
第二,参照系。天天为 Opus 5.5 每题 10.04 美元或 Carbon 原价买单的人,换过来才谈得上省钱省时间;已经在跑每任务 1.01 美元的 GPT-6.2 Sol,换成 Neon 是消费升级不是降级。知乎
第三,自己的任务。现成的验证方法是:同一组任务、同一个提示词,分别跑 Neon 和你现在在用的模型,记四个数——结果能不能直接用、改了几轮、花了多久、花了多少钱。四个数同时改善,再考虑全量迁移。知乎
最后校准一下账本口径:网传的「第三」和「第六」其实是同一个 61 分,差的只是比较范围。知乎
主打的编码分数 SWE-sweep 39.0% 也带着前提:那是在谷歌自家 Antigravity 框架下的成绩,换成标准 mini-SWE 框架,同一模型只有 12.8%。知乎
以上是 11 月 19 日的可核验口径。Carbon 促销 11 月 30 日截止后,「时间窗口」这本账要整个重算一遍。
当前文章无评论,是时候发表评论了