这周的AI圈有两条热闹凑在了一起。
一条在数学圈:OpenAI宣称其模型用88小时解决了一道千禧年难题,陶哲轩、德利涅、邓煜等25位菲尔兹奖得主9月11日联合签署发布了一封公开信。而话题"千万不要让AI替代自己的思考"随即在社交媒体刷屏;中传校长那句"千万不要让自己活得像AI"的开学致辞也被翻出来刷屏。知乎新浪微博
另一条在你的收藏夹里:打开小红书,"去AI味"教程日更十条——“超火的no-slop”“这10个Skill你必须知道”“删掉这些套话文案才像人说的”,收藏动辄上百,其中no-slop教程专治空话、模板感和无菌机器腔。GitHub上叫humanizer的开源项目,则被人一天推荐一次。数学家在担心思考被外包,普通创作者在担心"一眼AI"被看穿。小红书小红书
这两件事看起来不搭界,但南加州大学"道德与语言实验室"今年发在《自然·人类行为》上的一篇论文,把它们接上了。而且结论对"去AI味"党相当不客气:你正在用的那些润色、改写、"更自然一点"的提示词,恰恰是测量出来让所有人文字趋同最狠的那一类。
这项研究做了什么:三个实验,88万多篇文本
先把研究摊开,免得又被营销号带成"AI让人不会写作"的焦虑文。
德加尼(Morteza Dehghani)团队的论文叫《大语言模型时代语言多样性的收缩图景》(Sourati et al., Nature Human Behaviour,2026),三项研究合计分析了88万多篇文本,一步步收网。arXiv36氪
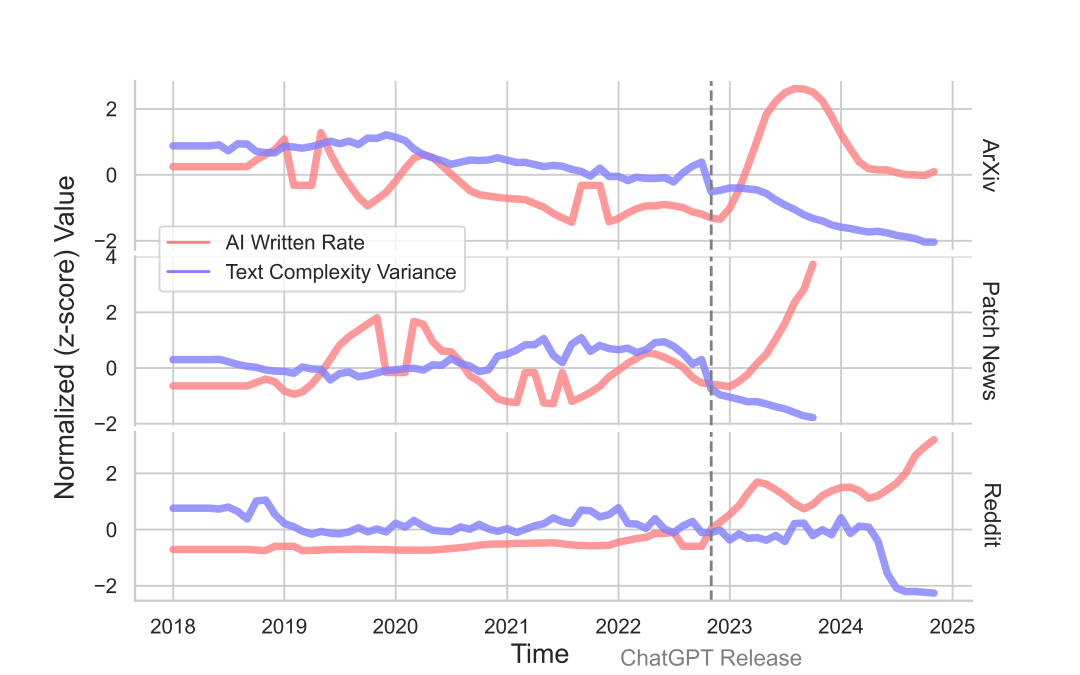
第一步,看趋势。 团队收集了三个平台的长期语料:arXiv论文80,238篇、美国地方新闻网Patch报道379,583篇、Reddit"写作接龙"版块故事帖318,490篇,按月统计同期各篇文章"写作复杂度"的方差——方差就是大家写得有多不一样。以2022年11月ChatGPT公开发布为断点做检验,三个平台的方差在此之后都持续下降,且都通过统计检验。地方新闻网在发布当月就显著下落,arXiv和Reddit是此后逐月缓慢地收。Nature
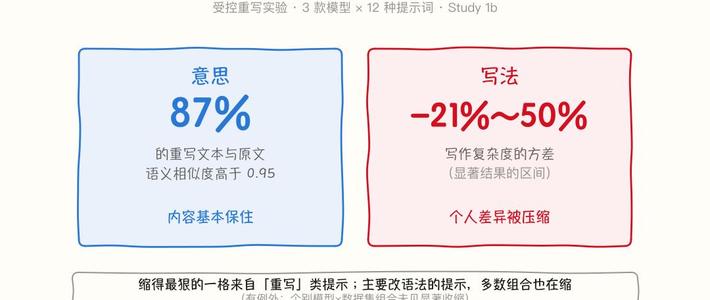
第二步,做实验。 趋势说明不了因果,团队从Reddit和arXiv各随机抽1,000篇ChatGPT面世前的人写文本,交给GPT-3.5、Llama3 70B、Gemini Pro三款模型,用12种提示词各改一遍——这些提示词的原话都列在论文里,你多半在输入框里打过:最温和的是"用最好的句法和语法重写",最常见的是"润色,提高整体质量,不要改变原意",其余要的是更清晰、更简洁、更自然、更学术、更正式。
结果:87%的文本改写前后语义相似度高于0.95(满分1),人工核对平均2.97分(3分制,即"只有细微差别")——意思基本没动,但写法变像了:在通过检验的结果里,写作复杂度方差缩小了约21%到50%,降幅最大的一格,恰恰来自"换个说法"这类提示。36氪
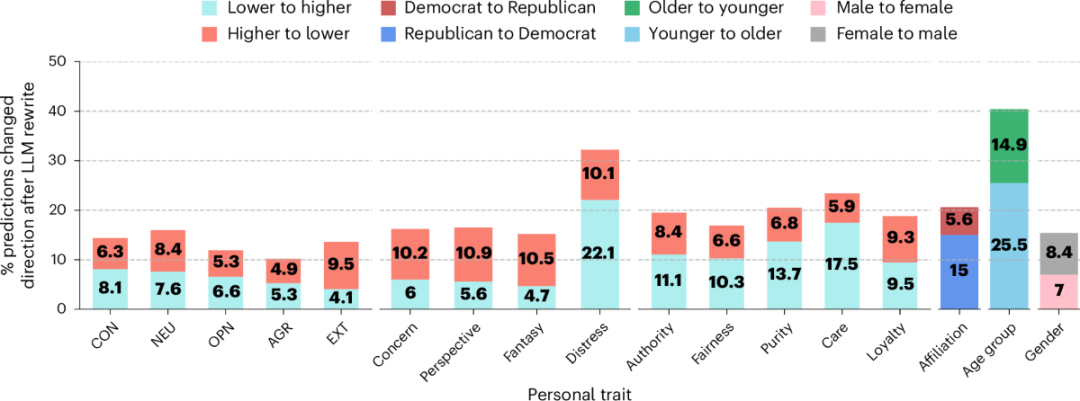
第三步,查线索。 是谁的痕迹被抹掉了?团队用六类带标签语料(年龄、性别、党派、大五人格、共情、道德倾向)训练分类器,在人写的原文上训好,再测AI改写版:六类标签的预测成绩全面下滑,全部p<.001。落差最大的是年龄,F1从0.351掉到0.260;性别从0.694掉到0.623,党派从0.664掉到0.591,平均掉6个百分点。Nature
还有一个更微妙的发现:下滑不是随机散的。模型改过之后,分类器会系统性地把文章误判成出自一个年长、男性、道德关切更高、共情更低、更不外向的人。最夸张的是党派:真作者是共和党人时,改完的文章经常被判成民主党人写的。36氪
为什么"去AI味"越认真,文字越撞车
看到这,问题就清楚了:社区流行的"去AI味"操作,和论文测到的趋同,根本是同一件事的正反面。
小红书教程教的是一批"症状词":删"值得注意的是"“此外”,少用破折号,别写"不是……,而是……"——这个句式最近正在遭遇一场互联网写作的集体声讨,"AI味"检查Skill都被做成了产品。但这些是表层词汇。论文测的是深一层的东西:词汇丰富度、分布均匀度、罕用词比例、句内搭配的舒展度,以及代词、冠词这类几乎不承载内容的"小词"习惯。
你让AI"换个说法"“改自然一点”,它确实没改你的意思,但它顺手把你的句子长度节奏捋平了、把罕用词换成高频词了、把你没意识到自己在用的功能词配比往训练分布的均值上拉了。词面的AI味删掉了,统计层的人味也没了——而且模型还带着自己固定的审美倾向(更年长、更男性化、更低共情)给文章盖统一出厂章。
论文进一步统计了"改写到底翻掉了多少判断":以GPT-3.5重写为例,原本能被分类器猜对的作者属性,改写后有相当比例被翻到相反类别——年龄组的翻转率最高,达到40.4%。Nature
这就是为什么"泡过去味Skill"的文章反而难分彼此:所有人都在用同一批提示词、同一类模型做反向清洗,清洗的标准本身又是模型定义的。知乎上有长期用AI处理稿件的博主总结得更狠:“文章里的知识未必错,读起来却总像同一个人写的。”知乎
先把边界划清楚:这研究没说什么
按惯例给强判断泼三盆冷水,这也是这篇论文自己承认的:
相关不等于因果。 平台方差的下降排除不了同期作者构成变化、平台规则变化;每个月的"AI参与占比"只是检测器估计,不是真实使用日志——时序检验加强了关联证据,却不是随机实验。Patch上AI占比甚至预测不动方差——作者的"编辑部模仿了读到的AI文字"解释,论文自己标注为未经检验的推测。36氪
语料以英语为主,中文互联网是否同样、程度如何,论文没有检验。 中文社区感受到的"AI味"和英文统计层的"趋同"是不是同一回事,目前是空缺。
线索变淡,没消失。 六类标签全部仍显著高于随机猜测;神经质与负面情绪词的关联、性别与社交类词的关联改写后依然成立。而且团队做的研究者批量改写,模拟的是"整段丢给AI润色",不是"人会拒绝建议、改完再自己改一遍"的真实流程。研究没有证明流畅必然以个性为代价。
它证明的只有一件事,但也够扎心:整段重写不只是改错,可能改掉那些用于辨认你的统计线索。
不同人怎么办:三条判断,不是三份教程
把结论按人群拆一下——这也是这篇论文里最值钱、但没人整理的部分。
靠文字吃饭的(自媒体、公文、报告): 论文里方差收缩最狠的是"换个说法"类提示,最"无害"的语法类提示也照样收缩。所以能保命的分界线是:让AI做挑错,别让它做重述。你自己的初稿——包括那些不通顺的长句、个人化的口头禅、只有你会用的具体数字和细节——是分类器还能认出你的原因,也是读者觉得"这是个活人"的原因。社区里已经有人在实践"风格蒸馏":先自己把AI改的稿子手改到满意,再喂回去让AI对比学你的口味。这个思路方向是对的,效果没有研究背书,可以当低成本实验做。
写论文、做学术的: arXiv的方差是逐月缓降的——学术写作的趋同是温水式、周期最长的那种。评审和编辑正在变老的一批人,读出来的"没意思但挑不出错",可能就是这21%到50%。把润色范围明确限制在语法层面,摘要、引言这种最能看出作者指纹的段落,自己写。
普通读者的: 你觉得"现在的文章越来越看不出谁写的",不是错觉,有统计背书。想继续看到人,去关注那些保留粗糙感的作者和平台;也顺手校准一下对"AI写的"的判断——你一眼认出的往往是词面套路,而真正的趋同,恰恰是连套路都没有的那种整齐。
最后
回到开头那两条热闹。菲尔兹奖得主们在宣言里捍卫的是思考的摩擦感,德加尼团队量出来的是表达的摩擦感在消失——汉密尔顿和麦迪逊的12篇悬案,最后是靠两人都没留意过的小词破的案。一个人文字里最像本人的部分,常藏在习惯里,藏在你自己都看不见的地方。
AI润色给你的每一分顺滑,扣的是哪一笔,现在有了数字:21%到50%。值不值,按下"重写"之前自己掂量。
可以继续盯着的信号:中文语料的同类研究(这篇论文的框架已被证明可复制,国内平台的方差曲线迟早有人跑)、以及"去AI味"Skill本身会不会成为下一波趋同源——毕竟所有人都收藏同一份教程的画面,今年我们已经见过一次了。