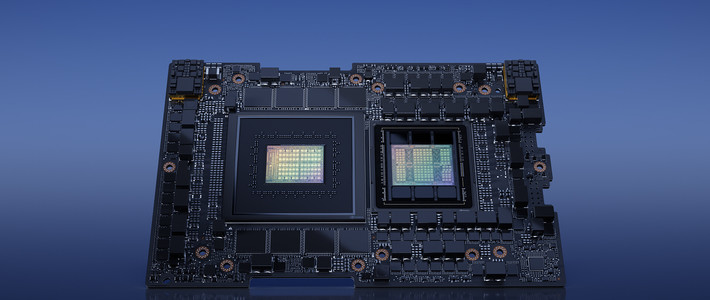
10月21日,韩媒报道称已被英伟达实际纳入的Groq正计划把一种三维堆叠式DRAM封装技术用到下一代芯片上,替代目前以SRAM为中心的设计。IT之家同步转述,标题给得更直白:下代Groq LPU芯片转向3D堆叠DRAM,放弃大SRAM方案。需要说明的是,英伟达和Groq均未确认这条消息,它目前只来自匿名的行业信源。但比传闻本身更值得关注的,是这次转向背后的逻辑:AI推理的主要矛盾正从速度转向容量,靠速度成名的LPU路线,要先解决装不装得下的问题。36氪IT之家
这场转向有清晰的时间线。2025年圣诞前夜,英伟达与Groq达成约200亿美元的交易,创始人、谷歌TPU核心开发者之一Jonathan Ross带队并入英伟达,消息一出迅速引发市场轰动,因为这是英伟达有史以来最大规模的一笔交易,远超2019年收购Mellanox的70亿美元。不过按英伟达自己的口径,官方说法是并未收购Groq,只是获得Groq知识产权的非独家授权,并从Groq团队中聘请工程人才。同一笔交易、两种表述,这提醒后续所有关于LPU的动作,都要把官宣和传闻分成两个层级看。投中网微博
LPU之所以被推理场景选中,靠的正是SRAM的速度。传统GPU推理要把模型权重放在片外的HBM里,每生成一次就得往返搬运;LPU则把大量权重直接装进片上的SRAM,用极低延迟换取交互式体验。今年8月下旬,英伟达宣布面向AI推理的Groq 3 LPX机架全面投入生产,作为Vera Rubin平台的扩展组件,主打为代理式AI提供超高速的token生成。微博
但SRAM有物理天花板:它和逻辑芯片用同一套制造工艺,制程升级带来的密度收益有限,在大型模型表现和芯片迭代上存在固有局限。同走推理赛道的d-Matrix,CEO Sid Sheth给出的对比更直白:SRAM容量每两年只能增加约10%至20%,而模型规模可能每六至九个月就翻一倍。这家公司的Corsair芯片同样以SRAM起步,如今也已转向3D堆叠DRAM。两家推理芯片公司在同一条赛道上先后改道,指向同一个判断:SRAM的容量增速,已经追不上模型的扩张速度。IT之家36氪
3D DRAM不是换一种更快的内存,而是换一种装得下的方式
这套方案的行业叫法是3DS:用硅通孔(TSV)把DRAM芯片垂直连接起来。它和高带宽存储器HBM都用TSV,方向却不同——HBM专注数据传输速度,3D DRAM专注在保留现有DRAM接口的同时扩展容量,把内存直接堆到处理器上方。数据传输路径更短,带宽、延迟、能效一起改善,单颗芯片才装得下更大的模型。对LPU来说,这意味着卖点从单纯的快,变成速度少掉一点、容量翻着涨。36氪
这个转向也符合英伟达自己公开的堆叠思路。去年12月曾有媒体报道,英伟达计划在2028年推出的Feynman(费曼)架构GPU中,整合来自Groq的LPU,利用台积电SoIC混合键合技术,将LPU单元直接堆叠在GPU之上。当时堆的是以SRAM见长的LPU,如今要往LPU上堆DRAM——对象在变,方向没变:让内存离算力更近,用堆叠取代搬运。快科技
报道离落地还隔着工程关卡。Rambus的专家在博客中指出,在堆叠结构中,任何一层出现缺陷都可能影响整个堆叠结构,从而降低制造良率并增加成本。应用材料公司也认为,DRAM往垂直方向扩展后,还需要新的材料创新来维持高速性能。至于下一代LPU的具体时间、容量参数,以及片上SRAM还保留多少,目前的报道均未披露。36氪
从一条传闻,到一整个行业的方向
巧的是,就在同一天,美光总裁兼首席技术与产品官Scott DeBoer在技术网络研讨会上回应长鑫存储4F²路线的竞争时表态,美光仍将坚持现有的6F²路线,并最终直接迈向3D DRAM。美光还在与晶圆代工厂合作开发vHBM,也就是把内存垂直堆叠到计算核心之上。推理芯片公司想把DRAM堆上芯片,存储原厂也在往同一个方向推进——AI存储竞争的重心,正在从单比特的成本,迁移到内存、封装与逻辑架构的系统级协同。华尔街见闻
但要说产业链立刻受益,还为时尚早。野村证券评估,4F²与3D DRAM在2028年之前的展望期内都不会产生实质性影响,长鑫的4F²量产预计也要到2027至2028年。对普通读者,真正值得盯的是两个信号:英伟达官方是否证实下一代LPU改用3D DRAM,以及后续产品披露的片上内存容量能否突破SRAM的量级。这两件事,才决定这次弃SRAM、转3D DRAM,是定局还是过渡。华尔街见闻