九月的第二周,云原生圈安静得有点反常。
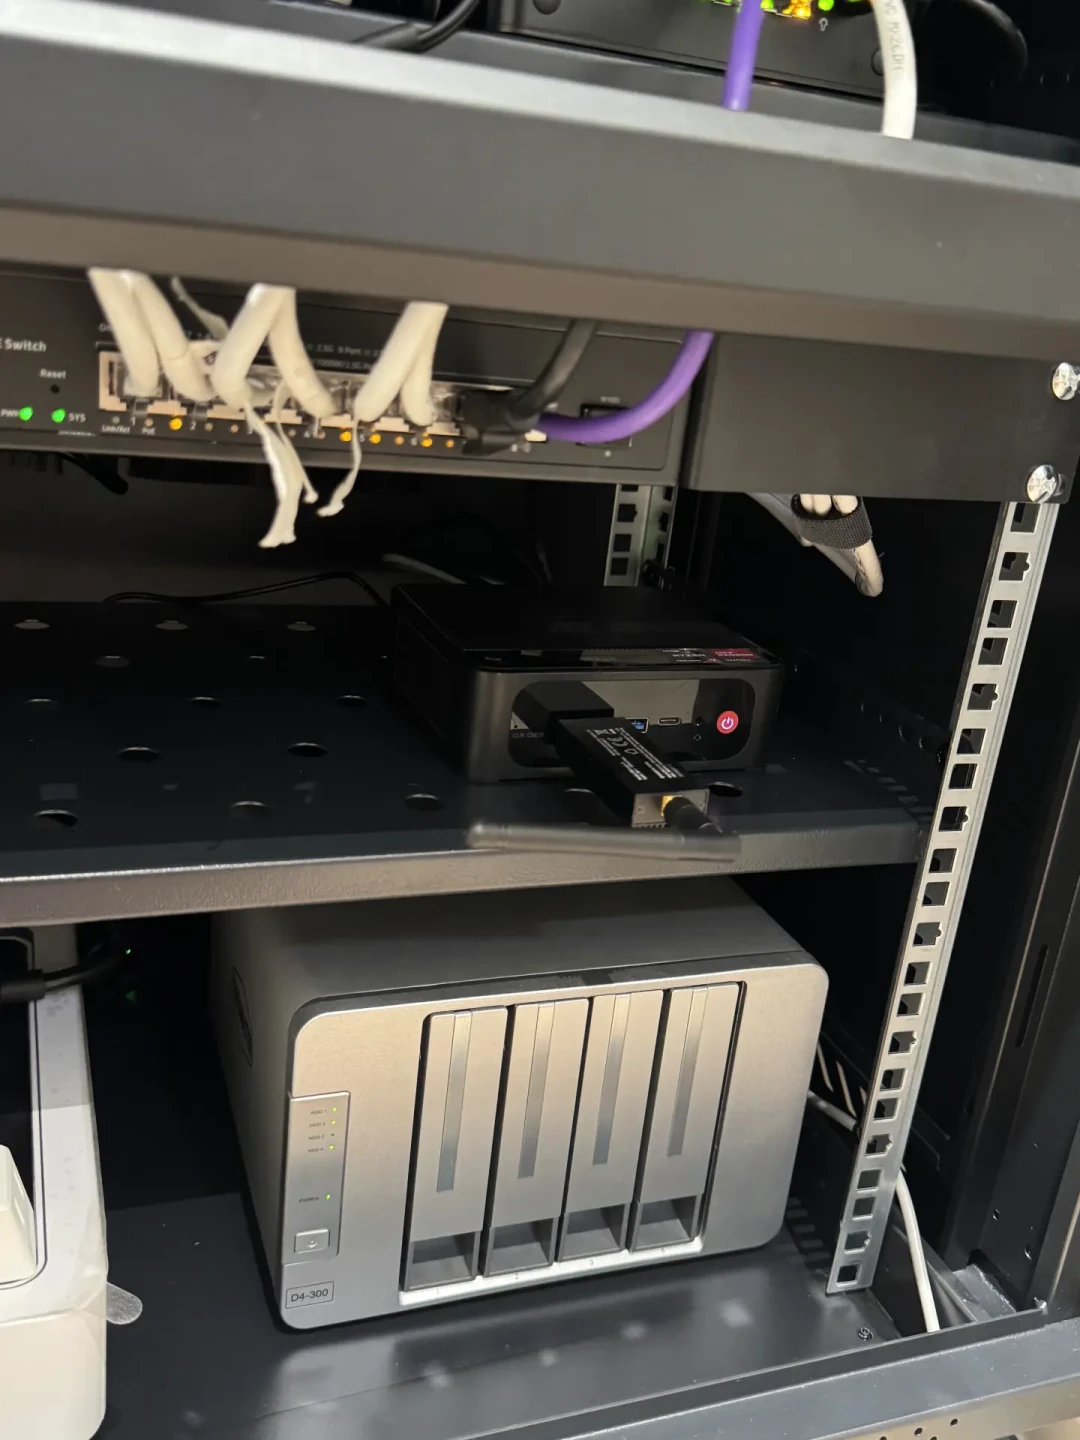
9月14日,知乎用户Jerome发了一篇没什么点赞的复盘:《我把所有服务搬上Kubernetes,又全部搬了回来》。两个星期,他把六个自托管服务从Docker Compose搬进K3s,ArgoCD、供应链安全策略、GitOps闭环一样不缺;然后同一天,全部搬回Compose,还顺手把一个原本就生在集群上的站点也迁了出来。四天后的9月18日,胡哥Linux运维的《K8s运维的5个新坑》底下开始有人对线:“升个级都能把API Server搞崩,这平台是不是太重了?”知乎
再往前翻四天,CSDN发了一篇GPUStack专访。受访的梁胜、秦小康是当年把Kubernetes推进中国四万家企业的那批人——平安、联通、上汽都算他们的战绩。就是这样两个人,带着账上数百万营收、客户已经列入预算的平台工程产品Walrus,回国落地开完全员会就宣布转型。专访里有一个数字值得每个运维记一下:GPUStack现有客户里,近半数只用Docker,完全不碰K8s。CSDN
一边是个人玩家和AI团队往回走,一边是KubeClipper 9月16日刚发布1.7.0、宣布支持Kubernetes 1.37。 企业集群照建不误,连9月19日都有人写《在多租户Kubernetes集群上大规模安全部署AI Agent》。有人下车,有人上车,还有人把车开进了新赛道。知乎
我把这两周知乎、CSDN、小红书、B站上的十几个相关帖子摆在一起对了一遍,发现这场"搬家潮"不是情绪,是分界线。2026年的K8s争论,争的早就不是"先不先进",而是一个更扎心的问题:
你的运维,是在为"生产者"打工,还是在为"消费者"交税?
一个把账算全了的撤例子
Jerome那篇帖子里,最值得运维抄下来的不是结论,是他那四次事故。因为它们几乎就是每个"一台机器上跑K8s"的团队都会遇到的怪事:
内存超配,内核把容器OOM kill了,pod状态却一直显示Running——监控全绿,服务已死;
Trivy operator的扫描并发配置写在Helm values的层级不对,被直接忽略,把磁盘打满;
为了service mesh收窄的一个Cilium参数,悄悄切断了反向代理到所有k3s服务的路径;
一个从pod发往compose容器的包消失在策略路由黑洞里,最后他选择绕开设计,而不是去修。
他的原话很狠:"Compose也会出事,但故障局限在一层之内,你能从头读到尾。在共享的机器上,Kubernetes的故障是跨层的,表现出来就是’全是绿灯,但结果不对’。知乎
压垮骆驼的最后一根稻草是一套供应链安全策略:他用Trivy+Kyverno做的准入关卡,扫到自己消费的第三方镜像带"已有修复版本的严重CVE"就拒绝部署。结果发现,想强制执行这道关卡,就得给每个第三方镜像维护一份补丁版包装镜像——npm的tar库出过一个DoS漏洞,他为此新建了一条CI流水线、一套签名配置,外加被迫跟进一次大版本升级。更荒诞的是,真开强制模式,ArgoCD自己都会被自己的集群拒之门外——因为集群组件在扫描报告出来后一直没重启过。
最后他总结的那条分界线,我建议每个在"要不要把全家桶塞进集群"里犹豫的人抄在工位上:
分界线不是软件重不重要,是谁掌握变更。他写的服务按他的节奏变,配得上金丝雀、发布通道、准入关卡;dify很重要,但dify的每一个新版本都不是他发布的——“跟进新版本就是docker compose pull && docker compose up -d”,那就属于那个无聊但正确的地方。知乎
留在k3s上的清单替他验证了这条线:自己写的、走自己CI发布的那一半留了下来,真正用上了隔离发布通道和mesh;继承来的、无法重新构建的那一半,迟早也要搬走。
AI算力圈给出了同一答案的工程版
如果说Jerome的故事是个人样本,GPUStack的转型就是产业样本,逻辑严丝合缝。
专访开头那个段子发生在2022年法国CNCF大会:主持人问大模型创业者"Kubernetes能为AI带来什么",对方脱口而出"AI不需要K8s",随后找补"我们也用了一点点,管管底层集群"。坐在台下的梁胜听懂了这个"一点点"背后的信号:写Python的模型开发者关心的是权重、上下文、推理延迟,不是Pod编排。
随后的转型踩点踩得极准。买卡容易、把卡用好坏,是过去三年所有拿到GPU的企业的共同痛点。摩根大通的报告给了一个刺耳的数字:中国80%新建数据中心的GPU处于闲置状态。CSDN
GPUStack的解法不是再叠一层编排,而是把模型部署做成"今天布上去、明天换了模型还能布"的极简工具。然后就有了那个让云原生阵营不适的客户画像:近半数客户只用Docker,完全不碰K8s。梁胜的解释很直白——“AI开发者天然需要极简和专注。”CSDN
注意,这不是"AI抛弃了K8s",GPUStack自己也在用那"一点点"K8s管底层。真实的变化是:K8s从"应用必须站上去的平台",退成了"底座里的基础设施"。你的业务和应用不需要为它让路,反过来才成立。
企业侧的账单:成本空转与升级赌博
个人和AI团队在退,那中大型企业的"上云原生"还成立吗?分开看两本账。
第一本是资源账。9月2日一篇做过10多个大厂微服务集群审计的文章说得很直接:生产环境资源利用率两极分化、成本刚性冗余,是云原生落地后最容易被忽视的隐性黑洞——靠节点自动扩缩容优化,能把服务器开销砍下来30%。K8s的价值从来不是"让服务跑起来",是让几百个服务、几十台机器的调度不再靠人肉。这笔账,服务规模不到临界点的公司算不过来,所以知乎上"小公司没必要上k8s么"的老问题下面,有答主的回答至今还在被顶:我闲鱼买了个二手服务器在家玩K8s,这玩意资源消耗比整个公司的都多。知乎知乎
第二本是升级账,这才是2026年运维最该警惕的。胡哥那篇帖子把账摊开了:
K8s每个版本都砍废弃API。v1.22砍了extensions/v1beta1 Ingress,v1.25砍了batch/v1beta1 CronJob,v1.32砍了flowcontrol API——老YAML一直没改过API版本,平时能用,直到被砍那天全量爆雷;
他记了一笔2026年3月12日的事故(转述自社区案例,细节无法独立复核,但路径值得警惕):某电商升1.32,14个生产集群控制平面全部503,42000个容器实例对外无响应47分钟,直接损失18万美元。根因是etcd 3.5.12把WAL写入卸载到io_uring后,CRC32校验在异步路径下有概率静默损坏——etcd自己还报健康,你眼看着集群活着,但所有写操作全挂。知乎
v1.31删完in-tree cloud provider后,还在用旧kubelet参数的集群升级完直接"节点消失";VolumeAttributesClass改了CSI调用逻辑,驱动没跟着升,新建PVC静默超时;
Cilium换掉kube-proxy再叠一个failurePolicy: Fail的Kyverno,能构造出"三条腿的凳子互相等"的死锁:Cilium等EndpointSlices重建路由,API Server写EndpointSlices要过Kyverno webhook,webhook调Kyverno Pod需要网络,网络靠Cilium。
这五条坑有个共同点:都不是K8s"坏了",是你为它配的每一层——网络、存储、策略、驱动——都必须跟着它一起升级。B站UP主"原子能"吐槽得没毛病:一年三个大版本,维护周期不超过一年,至今没有LTS。K8s升级不是点一下kubeadm按钮,是一场所有组件必须同频的集体考试。跑一次kubent预检十分钟,不跑,代价可能是通宵。哔哩哔哩
那K8s在2026年到底为谁活着?
把退潮的信号和进场的信号放一起,答案其实收敛了:
为自己的软件活着。你在迭代、你控制发版节奏、你需要金丝雀和渐进发布——K8s是为"生产者"造的,这条从没变过。Jerome自己写的那半个应用留在k3s上,不是留恋,是它真的用上了那些功能。
为规模活着。服务数×机器数×变更频率的乘积大到人肉调度会出事,K8s的调度税就是划算的。四万家企业上K8s,不是因为架构师爱YAML。
为"不可信负载"活着。这是2026年新长出来的理由:多租户集群上安全跑AI Agent、跑别人提交的代码——隔离、配额、准入策略在"谁都可能搞出事"的场景里全是价值。9月19日那篇Agent部署文章里,工程师下班前把issue交给Agent,人离线后它继续改代码、跑E2E、失败了接着修,这样的长时负载只能靠集群的隔离和配额兜底。 9月16日开始的K8s上跑大模型训练推理系列,走的也是这条线。知乎
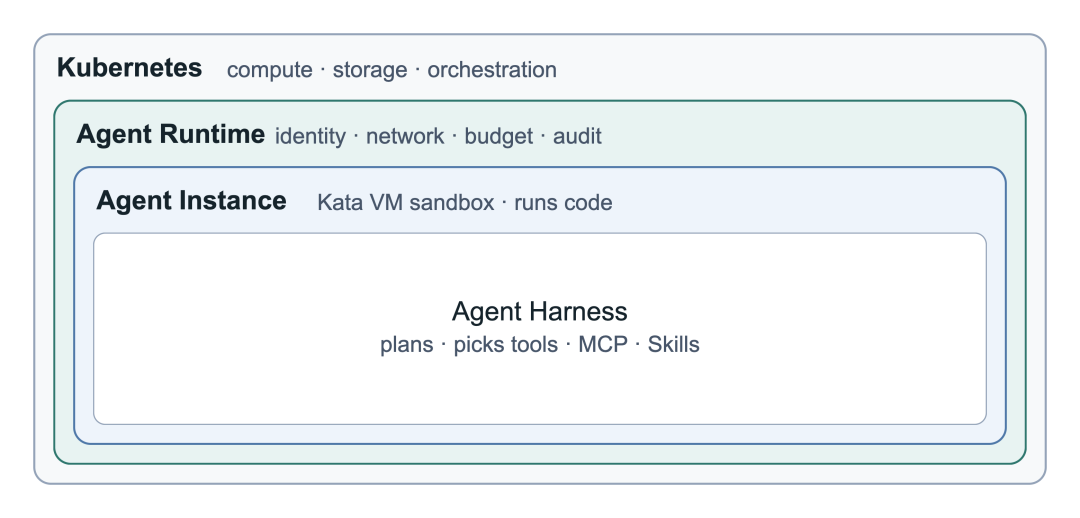
反过来说,不满足这三条的场景:跑第三方镜像的家用服务器、只有五个服务的十人公司、目标是"别烦我"的自托管站——每往上塞一层K8s,就多一层调度器、一套网络、一个事实来源,全是负债。
给自己的系统判个级:一张决策卡
最后把这两周的信号压缩成一个可以直接用的判断流程:
先问一句:你的软件是"生产的"还是"消费的"?
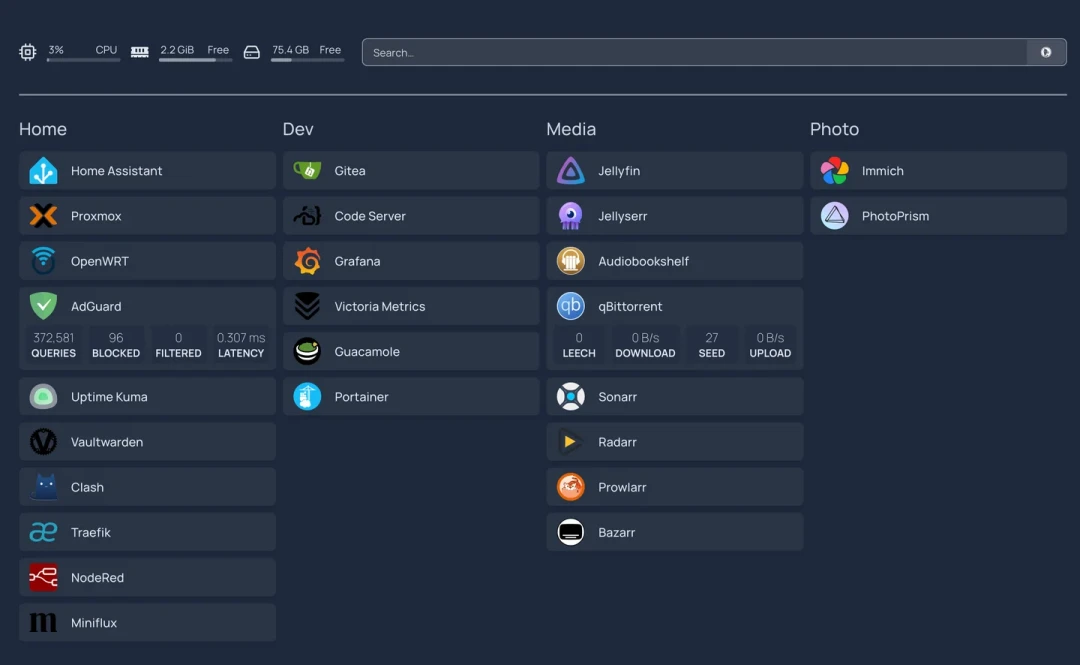
只跑别人发布的镜像、一年改不了两次配置——你不需要集群。一台机器,Compose加一个统一面板——最近NAS圈在疯传Homepage、uniTerm这类东西,专治"每个服务一个端口,全靠记忆或书签管理"。 这套组合足够把"跑起来就别管"执行好。知乎
再问第二句:你有多少服务、多少节点、多频繁的发版?
三者都过两位数,值得上K8s,但按胡哥那套预检建纪律:升级前必跑kubent(–target-version指定目标版本);永远不要跳3个以上minor版本;CSI驱动和网络插件与集群同频升级;failurePolicy: Fail的webhook先想清楚死锁环。
第三句:你在给AI做底座吗?
推理集群优先考虑GPUStack这类极简路线,K8s留给底下管硬件那"一点点";要跑不可信Agent或做多租户,再回到K8s的隔离模型里来。
继续观察的信号:今年下半年到明年,盯两件事就够了——K8s到底会不会被社区逼出一个LTS节奏(原子能那条吐槽底下几千条认同不是段子),以及AI Infra厂商会不会反向长出事实标准。这两件事哪件落地,今天这些"搬家"故事里的退潮派或守成派,就会有一边改写结论。
这个九月,Kubernetes没有变差,它只是从"所有人必须站上去的地方"变回了"值得它的那批人专属的工具"。对运维来说,这反而是十年来最清醒的一次架构讨论:先想清楚你是生产者还是消费者,再决定要不要为平台付全价。
你手上那套集群,是哪一种?