前天,Hacker News 上一条标题读着像打错了字的帖子冲到 453 个赞:"我用一台 25GB 内存的笔记本跑起了 744B 参数的 GLM-5.2,纯 C 实现。"帖子底下最高赞就一句:This is the hacker spirit。这两天,它链接的项目 colibri 把 B 站和知乎的本地部署区刷屏了——“7440 亿参数塞进家用电脑,一张显卡都不用”“把 2.8 万亿参数大模型塞进了你的电脑”。知乎哔哩哔哩
一位每次都被"该加内存了"刺痛的卡党朋友昨晚把装机账甩进群里,就问了一句:这是真的吗?
真的,但有代价。我把 GitHub 仓库、README、版本日志、issue 区、当天的两篇中文拆解和小众软件的旧实测翻完,把机制、实测速度表、容器坑和"该装/该看别处/该等"一次给到你。
先把时间线摆正:它不是"今天爆火"
仓库 2026 年 7 月 1 日建仓,Apache-2.0,纯 C 零依赖:不链 BLAS、运行时没有 Python、不强制要求 GPU。维护者一人,Vincenzo Fornaro,issue 标签至今还是意大利语。
2026-09-14 的 GitHub API 读数:31,052 星、3,323 fork、127 个未关闭 issue。第三方趋势页同一天记录 24 小时 +1,825、7 日 +4,068、30 日 +6,155。知乎
也就是说,热度峰值在 7 月,最近是在线性的慢烧,不是今天爆炸。看到"GitHub 今天爆火"的标题,先扣一分信息分。
更新节奏倒是真快:8 月 19 日 v1.7.0 上第 6 个模型家族,8 月 31 日 v1.10.0 第 7 个,9 月 13 日 v1.11.0 第 9 个——一个版本塞了 56 个 PR。
机制一段话:把显存换成 NVMe 带宽
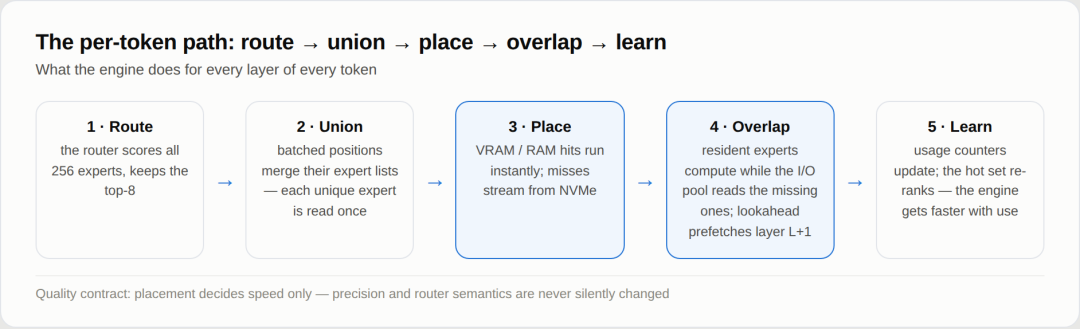
744B 的权重按 int4 整塞也要 370GB 往上,这条铁律一直把前沿 MoE 锁在数据中心。colibri 的切法是:MoE 每个 token 实际只激活约 40B 参数,其中真正随 token 变动的只有约 11GB。于是稠密部分(注意力、共享专家、嵌入,约 17B)int4 后 9.9GB 常驻内存,剩下的 19,456 个路由专家(75 层 MoE×256 加 MTP 头,每个约 19MB,合计约 370GB)全部躺在硬盘上,被路由到了才读上来。 光流式读会被磁盘延迟卡死解码,它又叠了三层:Router-Lookahead 拿当前层状态提前异步加载下一层大概率要用的专家,官方称下一层路由有 71.6% 可预测;学习型缓存按实际路由热度把最常被点的专家钉在内存(写进 .coli_usage,用得越多越快);OS page cache 再白捡一层 L2。官方 README 里这张每-token 路径图把五步写得很清楚:route 选 top-8、union 去重、place 分常驻/流式、overlap 预取下一层、learn 重排热度。知乎
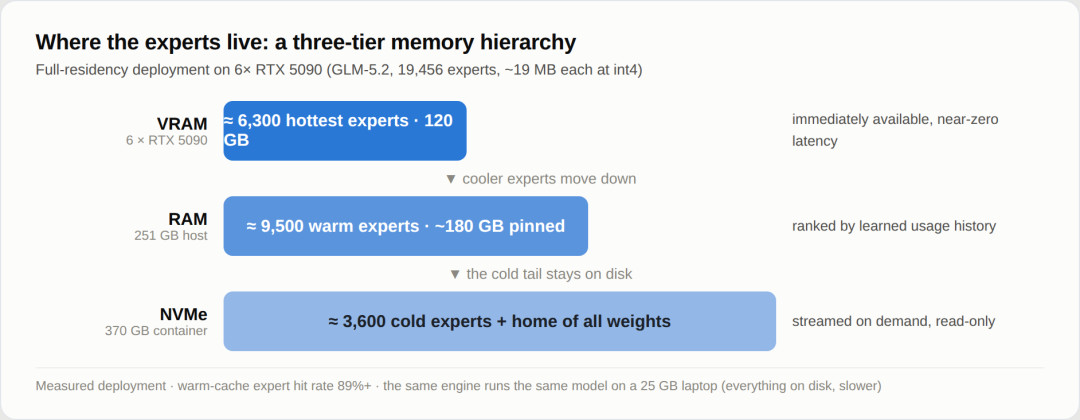
还有一手是冲着上个月 KV cache 之争去的:MLA 把 KV 状态压到每 token 576 个 float,约为朴素实现的 1/57,并且压缩后的 KV 直接落盘(.coli_kv)——重启对话还是热的,不用重新 prefill。
"能跑"的代价:这张速度表决定一切
下面的数字全部是作者或社区自报,没有第三方基准,认真信、不当真。知乎
作者开发机(WSL2、12 核、25GB 内存、VHDX 虚拟盘):冷启动 0.05–0.1 tok/s,峰值 RSS 约 20GB
Intel Ultra 7 / 24GB 内存:0.07 tok/s(小众软件,2026-07)
锐龙 9950X + PCIe5 SSD:0.28 tok/s;Mac mini M4 Pro 48GB 走 Metal:0.30 tok/s
RTX 3060 整机用户实测:约 0.44 tok/s,他的原话是"能跑是真的,能不能用是另一回事"
EPYC 7443 + 430GB 内存:1.00 tok/s;单张 5070 Ti 笔记本级:1.07 tok/s
M5 Max 优化后:2.06 tok/s;128GB 纯 CPU 桌面:约 1.8 tok/s
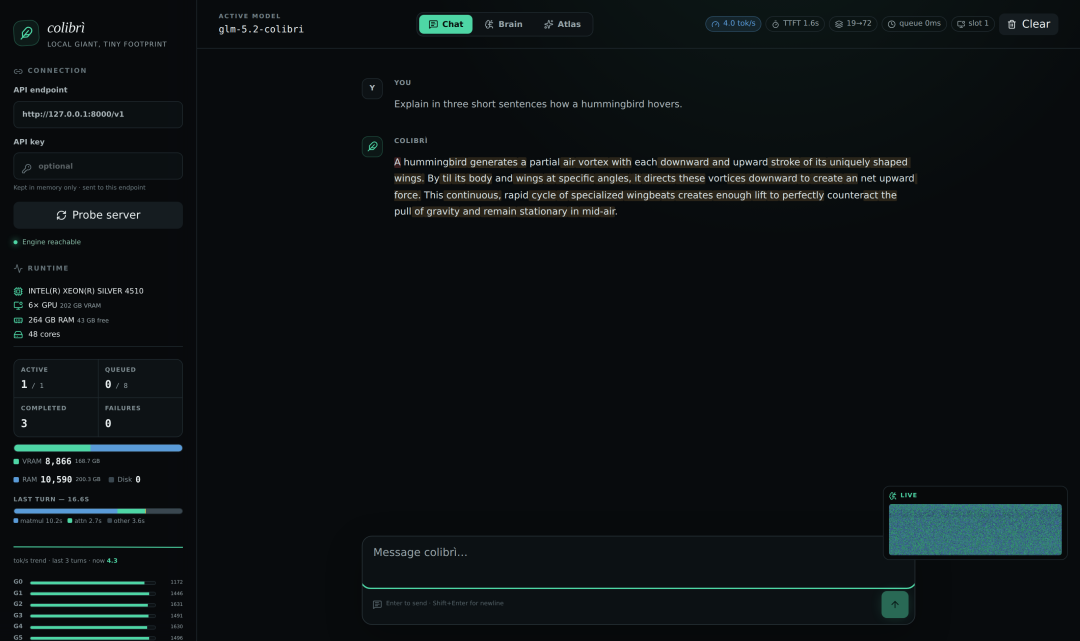
6×RTX 5090:README 口径 5.8–6.8 tok/s、TTFT 约 13 秒——注意官网仪表盘截图同档显示的是 4.0 tok/s、TTFT 1.6 秒,同一套硬件三组数字,官方速度随测量条件和版本浮动
0.1 tok/s 的体感是:生成 100 个 token 要 17–33 分钟。这是写信,不是聊天。
开发者自己承认的硬件阶梯:25GB + 1GB/s NVMe 只有 0.05–0.1;32GB + PCIe4.0 到 0.5–1;64GB + PCIe5.0 或双 NVMe RAID 是 2–4;128GB 以上、再配 24–32 核或 AVX-512,才可能摸到 5–15 tok/s 的交互档。官网速度阶梯图的实测口径更直白:25GB 笔记本 0.05–0.1,单张 5070 Ti 加 32GB 内存 1.07,128GB 纯 CPU 1.8,DGX Spark 3.3,6×5090 是 6.8——热缓存在高级机器上能把命中率顶到 89% 以上。
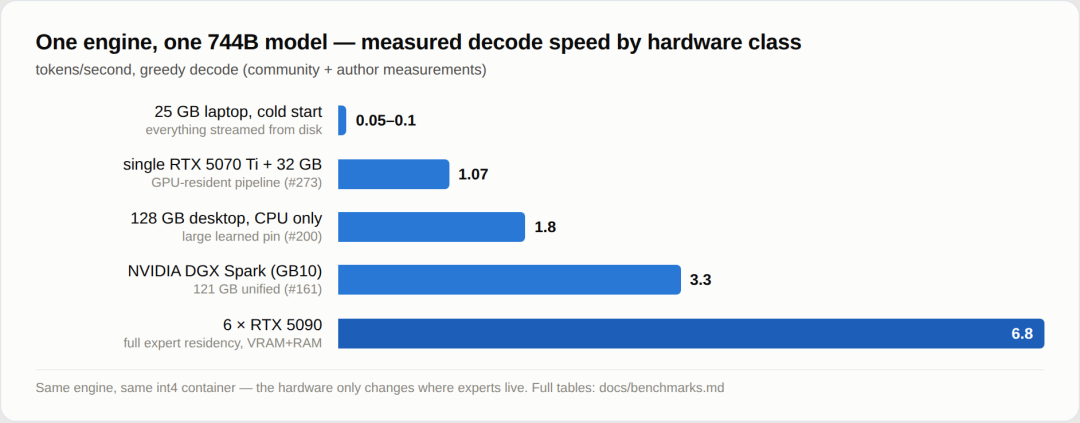
同一天(9 月 14 日)B 站另一条视频里,有人用 5 张 CMP-170HX 矿卡(总显存 320GB + 292GB 内存)跑 DeepSeek-V4.1-Flash 原版,prefill 6000 tok/s、decode 45 tok/s。同一个模型,一边是聊天档,一边是写信档——colibri 的对位从来不是速度,是让"本地持有"这件事第一次变成一条命令。v1.11.0 提速最狠的恰好也是 DeepSeek V4.1 Flash(552B):冷缓存从 78.7 秒降到 25.1 秒,0.305 提到 0.957 tok/s——上一轮"权重塞得下、对话塞不下"焦虑的那个模型,这次全部增益来自 I/O 编排:批量专家读取深度取 8 是实测拐点,注意力矩阵改成每 block 读一次而不是每 token 读一次。哔哩哔哩知乎
三个坑,一个比一个费电
容器有坑。 早期 per-row int4 镜像(mateogrgic、jlnsrk 那批)质量约差 9 个百分点,README 现在已经点名别用——issue #455 那次出了名的"THINK=1 自我纠错循环",最长一跑 30 分钟、约 1050 个 token 停不下来,根因就是容器。换成 gs64 分组量化加 int8 MTP 头的容器后同一组 prompt 5/5 通过。但这个结论的前提要讲清楚:消融是在 OLMoE-1B 上做的,不是 GLM-5.2 本身,属于合理外推、不是已验证事实。而 7 月发布的中文完全指南还在推荐旧容器——7 月的二手资料,引用前查一遍。知乎
弱机上,推测解码可能倒亏。 MTP 头能把每次前向产出拉到 2.2–2.8 个 token,但社区实测在 6 核 compute-bound 机器上,S=4 的验证前向成本约为 S=1 的 4.2 倍,解码反而减半;README 自己也记了 ~85% 专家命中率附近 32% 性能损失的负结果。纯 CPU 流式用户,先设 DRAFT=0。另外 MTP 头必须 int8,用 int4 接受率会崩到 0–4%——下载页那个 int4-with-int8-mtp 的怪名字就是为这个来的。知乎
硬盘是隐形成本。 GLM-5.2 的 int4 容器约 372GB,官方建议留 500GB 可用空间,下模型本身就是一晚上的事;高频随机读对消费级固态也不友好。被社区转得最多的那套"4090 + 64GB 内存 + 2TB SSD 跑 2.8T"配置,对应的是 Kimi K3——它的原始快照约 1.6TB,且至少需要 32GB 内存,2TB 盘位是贴着边界算的。哔哩哔哩知乎
安全上顺带一句:v1.10.2 刚修了 image_url 的路径穿越——此前即使设置了 COLI_IMAGE_ROOT,认证过的客户端理论上仍能通过图片接口读任意文件。别把它的外服接口架在公网。
该装的、看别处的、再等等
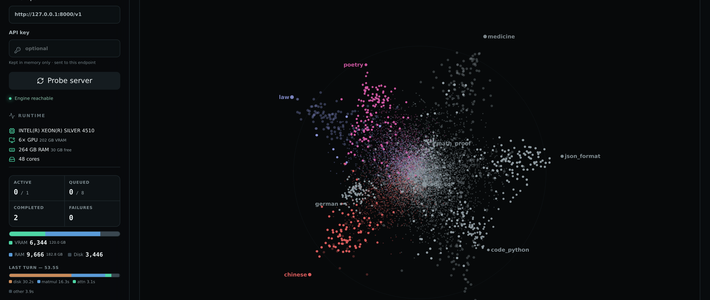
该装的人:内网涉密环境——零依赖意味着攻击面极小,没有 Python 供应链可以投毒,还自带 OpenAI 兼容和 Anthropic Messages 接口;数据不能出域、又要"本地持有前沿模型"的私有化场景,一台普通服务器就扛旗舰;夜间批处理、离线文档分析这类"睡一觉看结果"的活,0.5 tok/s 也够用;以及想低成本摸 MoE 路由行为的研究向玩家——13,260 个已刻画专家的图谱是白捡的。装好后它自带的 Web 仪表盘能实时看 tok/s、每轮耗时分解和显存/内存/硬盘三档的分布条。知乎
该看别处的人:要交互助手、coding agent 的,别用它碰这个需求,那是 vLLM+GPU 集群的游戏,高并发低延迟业务 colibri 碰都不碰;要 CPU+GPU 混合跑大 MoE 的,KTransformers 是成熟方案,代价是 Python/PyTorch/CUDA 一整套环境,部署重量完全不是一个量级;llama.cpp 路线依然成立,只要你的模型装得进内存或显存——colibri 补的正是"模型比内存大"这格。知乎
该再等等的人:打算为它掏新硬件钱的,先停手。README 的原话是"没有速度 SLA,只有语义上的硬保证"。64GB + PCIe5.0 档的 2–4 tok/s,至今没有任何独立基准稳定复现过。另外四组数字提醒你引用时注意版本:官网统计块比 GitHub API 落后约 6,000 星、家族数还写着 six(README 已是 nine);7 月指南里的 21,504 个专家已被当前文档修正为 19,456;README 对 GLM-5.2 的门槛是"最低 16GB、24GB 舒适"——刷屏口号却统一说 25GB。知乎
接下来盯这三个信号
一是本地集群模式:路由与 KV 留在协调节点、专家 FFN 分发到其他机器(包括 Mac)上执行,如果大规模真机成立,"几台旧笔记本拼一台 744B 推理机"就从演示变成方案。二是 Vulkan 后端:它把 ROCm 已经放弃支持的老卡(比如 RX 580)重新拉回推理池——存量硬件入池的下一步,比任何"A 卡行了"的宣言都实在。三是治理:11 周长到 3.1 万星、issue 编号过 1400,合并权却仍在作者一人手里,它能不能扛过下一次模型换代,比速度更关键。
colibri 真正的贡献不是让谁的电脑变快,而是把瓶颈从"你有多少显存"重新定义成"你的硬盘有多少带宽"。等哪天有人独立复现出 64GB + PCIe5.0 档稳定 2–4 tok/s,"前沿 MoE 在个人硬件上长期持有"才算从一个人的执念变成可复制的工程结论。在那之前:它值得装,值得聊,不值得当对话助手。