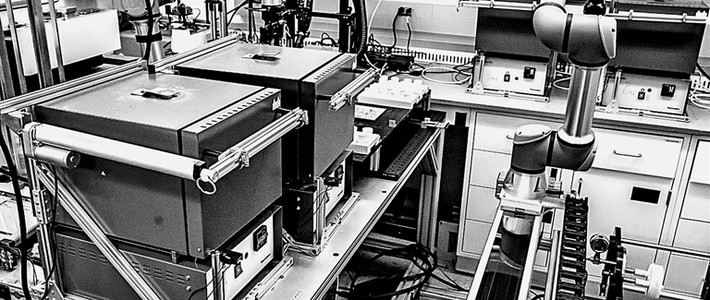
10月16日,多伦多大学团队在arXiv发布《Self-Building Labs》。系统拿到一个高层科学目标,会盘点现有设备、搭建实验室的数字副本、生成机器人操作技能,最后在真实实验室跑完一次硫化镉量子点合成:236条OT-2移液指令,19个机械臂转运、封板、读数的阶段。人负责提供初始信息、批准方案,实验室自己把自己搭起来。arXiv
但“实验室自己会搭”不等于“结果自己可信”。加州大学伯克利分校的A-Lab已经跑了三年:机器人全天候做实验,速度约为人类的100倍,人主要当“流程架构师”,设定方向、决定下一步做什么。2023年,A-Lab在《自然》上宣称17天自主合成36种化合物。2026年1月,作者却发了勘误——所谓“新”,是新于预测平台,不一定是新于科学;重看衍射数据后,40个报告的成功里有4个无法确认。机器能把实验跑快,但“这算不算一个新东西”仍要人来判。光明日报《自然》Nature
这项勘误值得和另一组数据放在一起看。一项覆盖4130万篇论文、发表在《自然》的研究发现:使用AI的科学家,论文数量是不用者的3.02倍,引用4.84倍,成为课题负责人的时间早1.37年;可在集体层面,科学主题的总量缩小4.63%,研究者之间的互动减少22%。个人产出更高,科学的目光却收窄到数据最丰富的地方。《自然》
勘误说明“做”和“信”是两件事;另一组数据说明,“个人做得更多”和“科学探索得更广”也是两件事。它们共同指向同一个变化:AI降低的主要是“做”的成本,不是“判断”的成本。中国工程院院士罗先刚说得更直接:AI改变的是科研的“执行层”,尚未触及“提问层”。已知目标的任务可以交给AI;需要发现目标的任务,必须由人主导。中国新闻网
这也解释了为什么“人手一个实验室”不等于“人人同一水平”。2026年3月,三位研究者在NBER的《AI in Science》里指出,AI增强的是在海量可能性里找候选的能力,不是全自动科研;它的回报在不同领域、不同环节高度不均,人的判断仍然不可替代,尤其在数据稀疏的地方。而且,一个团队里懂AI的人越多,收益放得越大——技能培训和组织设计,是工具之外的条件。NBER
工具可以下载,网络不能。2025年一项基于OpenAlex论文库的研究发现,早期采用AI的科学家,往往本身就嵌在AI合作网络里、任职于AI实力强的机构。大模型普及后,机构优势有所减弱,但“认识懂AI的人”这项社会资本仍然是持续的门槛。ScienceDirect
验证是另一个更硬的约束。AI能批量提出候选,实验室的验证速度却由设备和人工决定;A-Lab的勘误就是一个提醒。那套“10个开源仓库搭个人AI实验室”的方案,已经把本地模型、微调、API和实验记录凑齐了;作者自己也算过账:省掉的是云费和token费,显卡、电费、调试时间一样不少。知乎
这些证据没有证明AI让差距必然变大。它们只说明一件更朴素的事:工具普及,不等于收益普及。AI让产出变多,但把产出变成结果,要靠验证;把结果变成下一轮资源,要靠网络。缺哪一环,收益就停在哪一环。
回到开头那个实验室。系统能根据目标搭出实验室,却不会告诉你哪个目标值得为它搭一个实验室。科研差距没被抹平,不是因为实验室还太贵;恰恰是实验室变得容易搭之后,真正稀缺的东西露出来了:知道该问什么,以及有能力判断什么值得信。
实验室可以自己搭,问题不能。