

这一个月,本地部署玩家的首页大概率被"24G卡跑125B""121字每秒"这种帖子刷屏过。有人心动,有人翻白眼——“能跑"和"能用”,到底还是两回事。
11月13日,llama.cpp和底层张量库ggml同时发布了v1.0.0。做了三年半"按提交数编号"的nightly版,这是第一次出正式版。版本号只是仪式感,真正的硬货,是这一个多月合进主线的两项功能:MoE专家显存缓存,和FP8 KV缓存。知乎
显存的用法,换了个思路
以前本地跑MoE大模型,主流做法是"按层切":-cmoe把专家全扔内存里让CPU算,–fit自动算显存够放几层。静态划分,哪怕你一辈子用不到的那几个专家,也占着显存。
新思路直接搬了CPU二级缓存的设计:专家权重留在内存,显存划一块当缓存,只装真正常用的那部分。MoE模型总参数吓人,但每个token只激活一小撮专家——路由的局部性,就是这门生意能成立的原因。知乎知乎
数字很直观:Qwen3.8-Flash-Next的Q4_0量化,模型文件93.7GiB,专家权重独占65.4GiB,4090的24G显存本来就装不下。换成缓存方案后,4090上只放10.7GB进显存(按层切方案要16.5GB),速度反而快六成。缓存只需装下专家总量的约六分之一,命中率就有77%。先别急着截图——这些是PR贡献者在EPYC 16核+PCIe 4.0机器上的自测数据,换CPU、换显卡代数,数字都会变。知乎
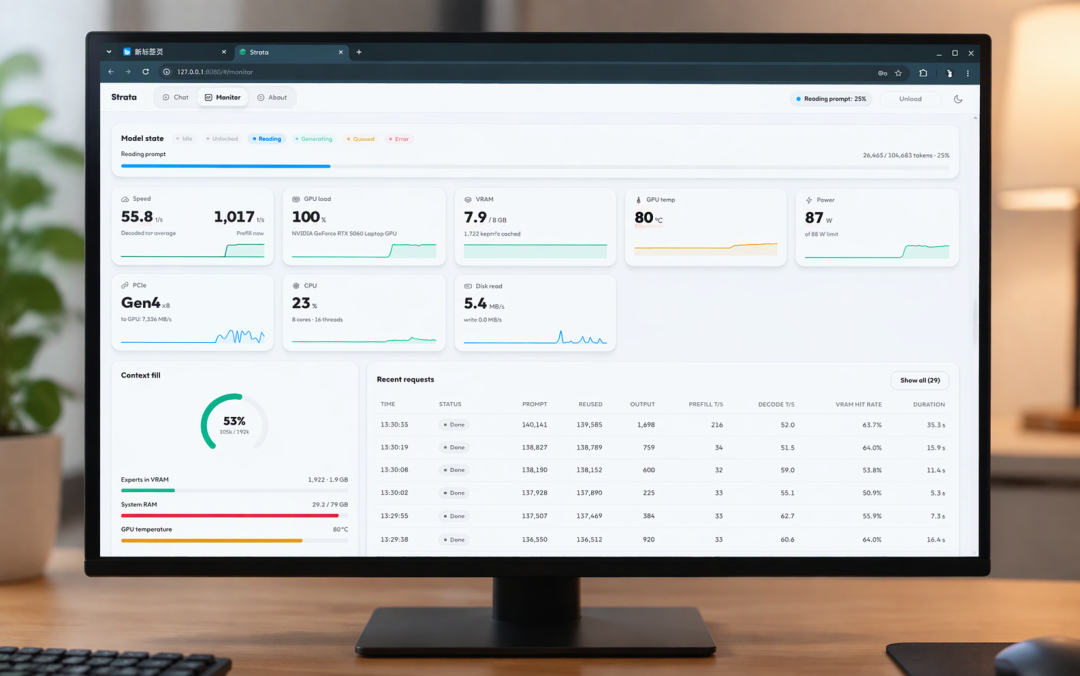
缓存怎么"踢人",一个月内改了三轮:LRU→SLRU→ClassLRU,给每个专家记"最近用没用、用得多不多"的衰减分,半衰期128个token、分8个等级,等级越高越难被踢,命中率从86.5%提到87.6%(能预知未来的理论上限93.8%)。缓存满了没命中的专家,还能让CPU直接算:–moe-cache-cpu-share从0调到0.95,速度从24.2跳到47.6 t/s;但缓存放大到19GB后,比例调高反而更慢——参数有甜点,别瞎拉满,官方带了一个调参脚本。
第二个硬货,其实更普惠
FP8 KV缓存听起来不如专家缓存炸裂,但人人用得上:-ctk/-ctv新增f8_e4m3格式,长上下文的KV缓存体积直接砍半。之前那些"24G卡跑百B"的帖子评论区里,就有人追问KV cache怎么办。现在主线给了官方答案。小红书
这波跟你有什么关系
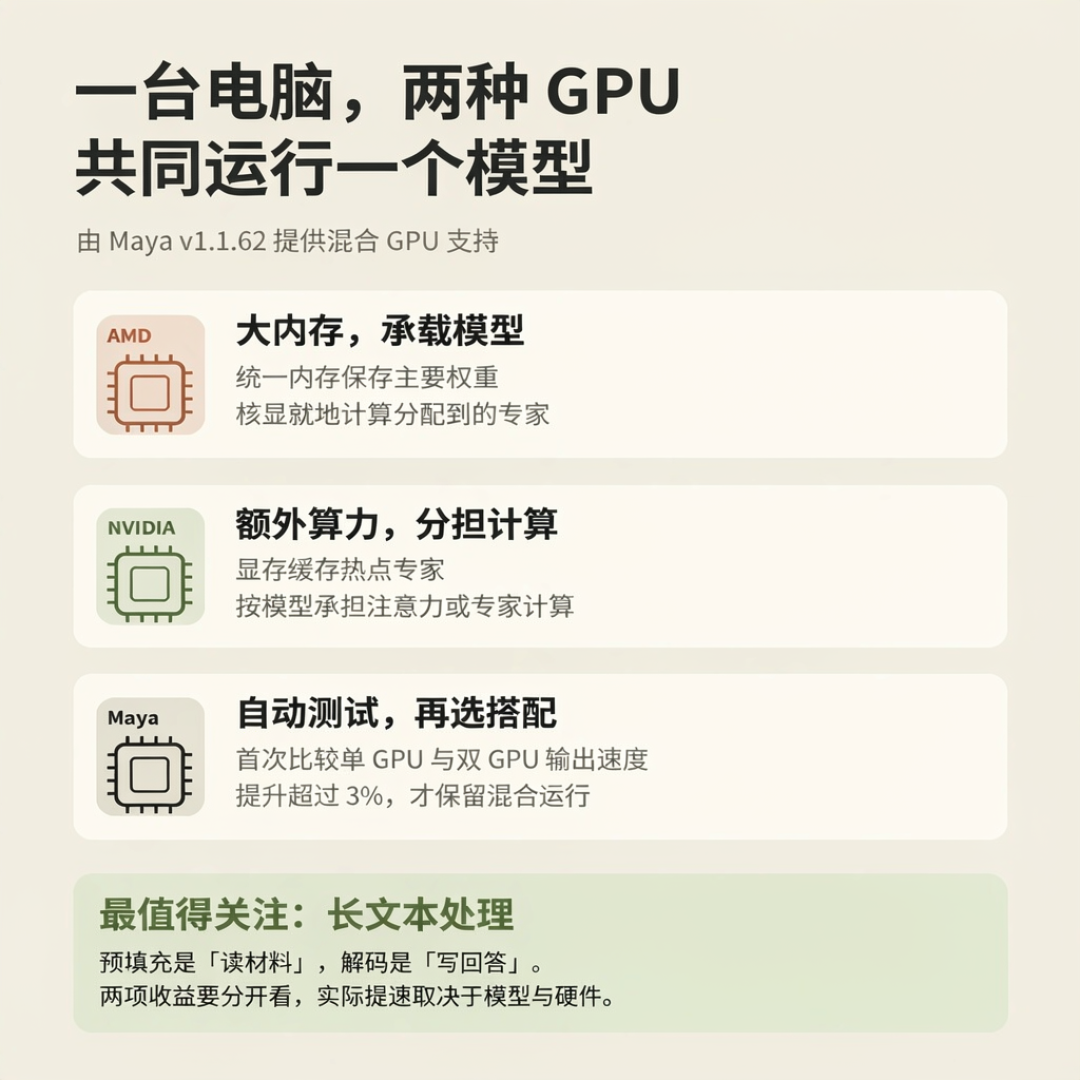
对手里捏着16~32G显存+64~128G内存的人,“这模型我能不能跑"的老账得重算:显存从"装模型"变成"装热数据”,真正吃紧的可能是内存。社区其实早就在抢跑——Strata、Avalon这些llama.cpp分支,已经让125B MoE(89GiB权重)跑进一张7900 XTX 24G,短回答中位121.6字每秒。连Edge0这种新框架也喊出24G显卡跑145B大模型。而做进主线意味着CUDA、Metal、Vulkan、SYCL、ROCm全后端覆盖,Ollama、LM Studio这类直接链接libllama的下游应用,全都吃得到。另外llama-server现在自带网页UI、MCP客户端和JS沙箱,默认安全设置收紧——越来越像个本地Agent运行时了。哔哩哔哩哔哩哔哩知乎
三盆冷水:1.0的稳定承诺只覆盖C API,不承诺性能和命令行默认值;llama.h里35个废弃函数已经真删了,直接链接libllama的项目升级要改代码;专家缓存的效果目前全部来自贡献者自测,等更多机器上的独立实测出来再下结论更稳。知乎
最后一个彩蛋细节:这批PR的"是否使用AI"声明大多是YES,维护者Gerganov清理1.0的API时,用的就是llama.cpp在256G的Mac Studio上本地跑的DeepSeek V4.1 Flash。一个推理引擎,开始用自家跑的模型维护自己——这比任何跑分都更能说明,本地模型现在到底能用到什么程度。知乎
下次再刷到"24G卡跑百B",别光收藏:先打开任务管理器看看内存条。这一代本地部署,内存才是硬通货。


当前文章无评论,是时候发表评论了