11月9日,Anthropic 同时发布 Claude Fable 5.2 与 Mythos 5.2,两款新旗舰都已可正常使用。这次发布的真正看点不在“又刷了一轮榜”:官方把产品线重新排成了“Opus 管日常、Fable/Mythos 管硬核”的梯队,API 价格比上一代降了两成,能力展示则从写代码一路伸到了造硬件和控制机器人。财新网
同一个底座分出的两个分身:拆开的是权限,不是能力
官方口径里,两款模型实际上基于同一个底层模型,主要区别在于安全防护机制和开放范围。Fable 5.2 内置更严格的网络安全和生物学防护,面向所有用户;Mythos 5.2 则只开放给经过审核的网安和生物医学机构。36氪
被“解禁”的 Mythos 5.2 主打网络安全工程:Anthropic 称它是公司目前网安能力最强的模型,在评估中比之前最强的模型多找出了 10.2% 的公开漏洞,一家顶级安全公司还测试发现,它找出的确诊漏洞里有六分之一是其他前沿模型全部漏掉的。36氪
这道权限门槛目前还在收紧:网络安全专业人士要通过 CyberVerification Program 申请资格,企业客户得走 Claude Security。更耐人寻味的是安全文档里的另一个细节:Anthropic 承认训练时刻意把 Fable 5.2 在“加速AI研发”领域的能力压在了上一代 Opus 5.5 的水平——官方担心的是模型反过来改进自己。36氪36氪
也正因为这种分层,官方的使用建议相当反常:日常任务请继续用 Opus 5.5。简单交给 Sonnet/Haiku,日常交给 Opus,够不着的硬骨头才升级到 Fable 或 Mythos,甚至可以让 Fable 5.2 当“代码顾问”,被轻量模型在难题上求助,或者作为多智能体编排里的调度者。36氪
官方案例亮出的不是分数,是长链条自主性
传播最广的“证明费马大定理”需要先纠正口径:怀尔斯在1994年就已证明该定理,Anthropic 做的不是重新发现,而是把已有证明转成 Lean 可逐步检查的形式化证明。但即便只是形式化,量级也足够夸张:团队放给约1000个智能体一组非常有限的提示,不提供任何数学参考资料,剩下的30小时几乎无人干预。36氪
作为对照,Anthropic 用同样的1000-Agent 配置测试 Opus 5.5,后者18小时只完成26%,此后基本停摆。另一条实验线同样依赖“放手”:工程师给 Fable 5.2 一个空文件夹,要求设计一套原型操作系统,模型连续8天协调子Agent写代码、测试和审查,最后交付了一套能在笔记本上启动的系统。36氪
硬件环节则从纯数字跨进了实物:模型仅凭一段提示词设计了三款能工作的设备——家庭语音助手中枢、USB 免提扬声器和一款手持电子宠物,从写规格书、元器件选型、四层电路板布线到 CAD 建模和固件全部自主完成,每一块电路板都在不到一天内达到可生产标准。36氪
具身方向,官方的 RoboDojo Sim 测试要求模型根据摄像头画面控制模拟双臂机器人,Fable 5.2 在最高推理强度下拿到64.9%,而 Fable 5.1 是27.6%、GPT-6 Astra 29.8%、Opus 5.5 39.4%。官方还称它解决了两项黑洞物理公开难题——其中一个的计算思路早在2003年就有人提出,只因过程繁琐二十多年没人跑完。36氪
降价两成只是账面,真正决定花费的是推理档位
价格层面,两款新模型的标准 API 定价为每百万输入 Token 8美元、输出 40美元,上一代 Fable/Mythos 5.1 是 10美元和50美元,输入输出均下调20%,官方同时称输出速度最高提升30%。36氪
想要更快的还有可选的 Fast 模式,生成速度最高提2.5倍,价格对应翻倍到输入 16美元、输出 80美元。订阅侧也放出窗口:20美元档的专业版套餐即可调用,但优惠只截止到11月16日——留给观望者的窗口只剩三天。36氪
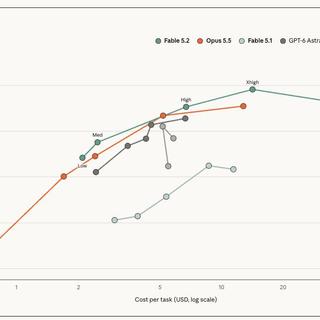
开发者圈子里讨论更多的,是发布次日第三方评测给出的一组成本数据:在 FrontierCode 2.0 测试中,Fable 5.2 开到 High 档的得分与 Opus 5.5 拉满几乎持平,单任务成本约6.72美元,不到后者12.82美元的一半。知乎
但同一份整理也给出反面:把 Fable 5.2 拉到最高档,单任务成本会升到26.5美元,约为 Opus 5.5 极限档的2.6倍。这组数字来自自媒体的单任务口径测算,只能作为参考,但结论方向清楚:只比“每百万 Token 多少钱”意义有限,真正要比的是某个档位完成某类任务要花多少钱——省不省,取决于档位怎么开。知乎
发布一周:作品在爆,争议也在同时到来
第三方榜单已经跟上:Fable 5.2 以65分登顶 AA Intelligence Index v5,还在被公认最难的 ARC-AGI-3 里冲到了81%。创作者侧的演示更密集:Anthropic 工程师 Felix Rieseberg 公开的 FPS 原型《Saltline》,只给了一条重视画面细节的初始要求,模型运行约8小时把场景、贴图和音效一次生成,期间没有等来任何追加反馈。36氪知乎
物理世界的演示也在铺开:有开发者把 Fable 5.2 接上机械臂下跳棋,整局62步走完,抓取失败和硬件形变时模型能自己纠正动作。36氪
热闹背后,争议几乎是同步落地的:发布没几天,开发者就从对话里把系统提示词扒了出来,流传版本达95万字符。账号层面,Anthropic 在上市前夕收紧风控,确立了地区准入的穿透式审查标准,封堵壳公司和代理中转。而媒体披露,其 IPO 已确定发行价。36氪36氪财新网
对普通开发者,可用性本身已不是问题:Fable 5.2 已上线 Claude 各平台,并支持 AWS、Google Cloud 和 Microsoft Azure,API ID 为 claude-fable-5-2。需要留住的边界感是:费马形式化、造硬件、机器人这些最亮眼的案例几乎全部出自 Anthropic 自述,第三方评测刚开始出数,Mythos 5.2 也未对个人放开。接下来值得盯的是两件事——11月16日优惠结束后订阅价格是否回调,以及各家开发者能不能把“按任务选模型”的分层账真正算省。36氪