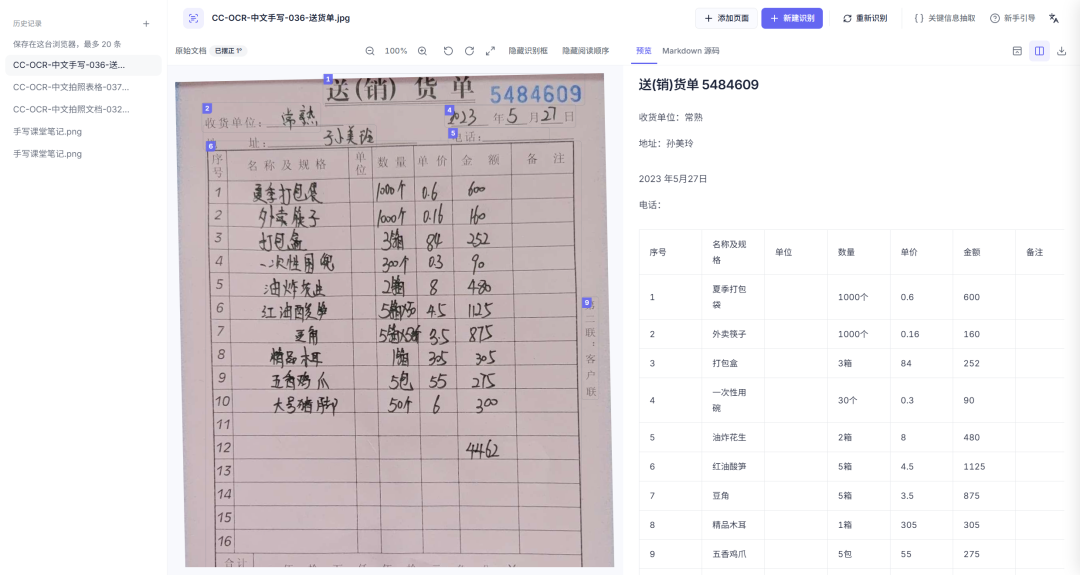
Datawhale 的实测里有一张手写送货单,10 行商品,底部总额 4462。MiniCPM-OCR 1.0 把它转成了齐整的表格,标题、日期、明细、总额都在。
逐行核对方能看出问题:第 4 行原图写的是「一次性围兜、数量 300 个、单价 0.3、金额 90」,模型输出成了「一次性用碗、数量 30 个、单价 0.3、金额 90」。
30 乘 0.3 等于 9,和同一行的金额 90 对不上。
总额对、表格齐,只有数量和品名悄悄变了。乱码你会重跑,这种错你会直接入库。
文档解析这几年有个说不出口的尴尬:榜单准确率越来越高,可没人敢把人工复核撤掉。
模型能认对 95% 的内容,却没人说得清剩下的 5% 错在哪里。省下的录入时间,又交给了校对。Datawhale
10 月底,面壁智能开源的 MiniCPM-OCR 系列,想动这件事。
它把 OCR 拆成两个模型:1.3B 的 MiniCPM-OCR 1.0 负责读,2B 的 MiniCPM-OCR Jev 负责判断读得对不对。前一个不新鲜,后一个才是这次值得看的地方。路过银河Datawhale
为什么不让读的模型自己打分?因为自回归模型有很强的语言先验:文本通顺,token 概率就高。
把「300」看成「30」,只要后面的「单价 0.3、金额 90」排得整齐,它并不会心虚。语法通顺和事实正确,在它内部是两件事。
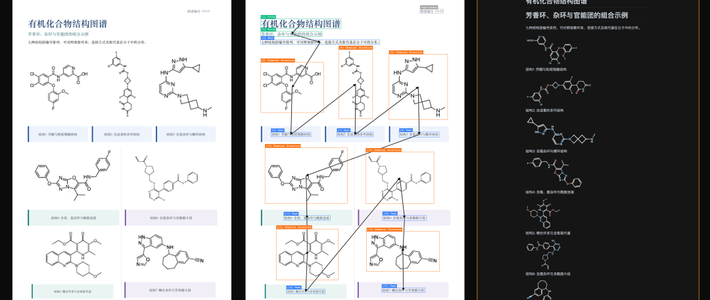
Jev 把判断变成视觉比对:输入区域原图、候选文本,以及渲染后的候选图。0 和 O、l 和 1 的差别因此落到像素上。
它的输出头换成一个二分类头,不做文本生成,一次前向给出 0 到 1 的分数。
换成 GLM-OCR、PaddleOCR-VL-1.6 或小米 OCR-0 的输出,AUROC 仍在 91.9 到 93.4。面壁智能
在 JevOCRBench 上,2B 的它拿到 93.6,高于 35B 级判别模型 JEV-35B-A3B 的 90.1。路过银河
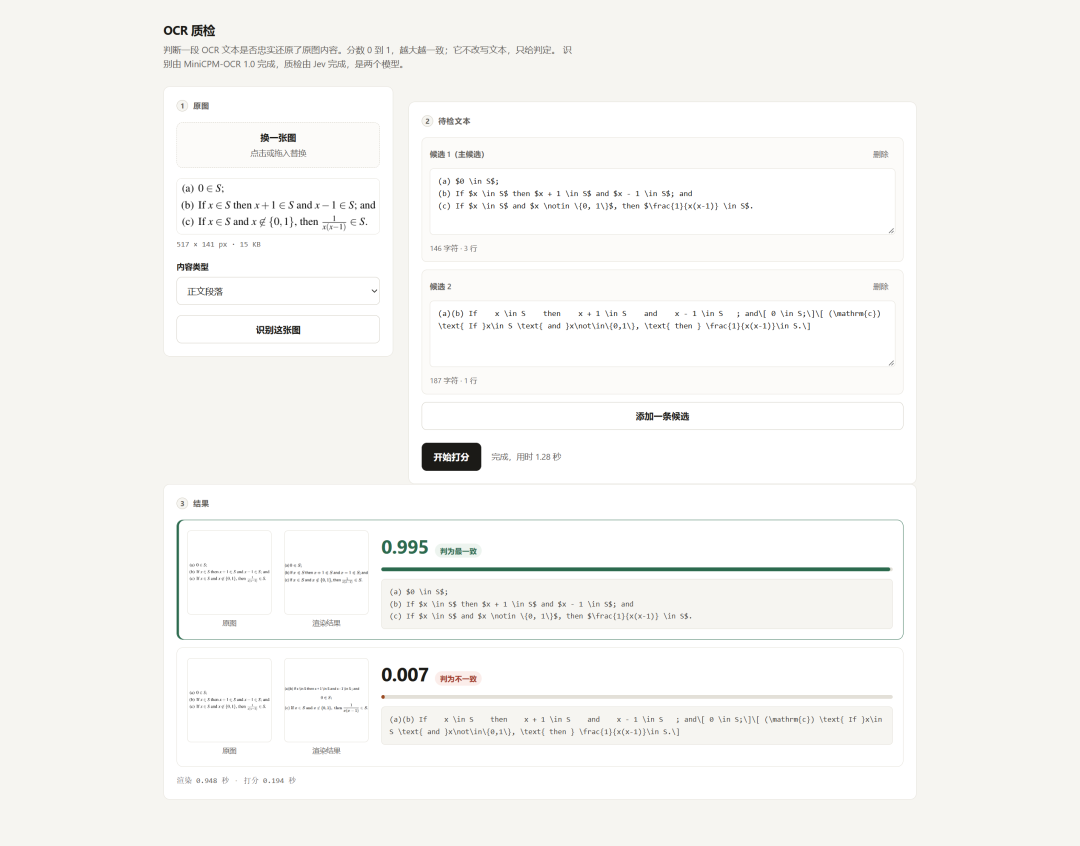
更值得看的是它把「谁来复核」变成可调旋钮:按准确率设阈值,高分自动入库,低分推给人工。
官方在 900 块人工标注图块上的统计是:免检部分准确率接近 100% 时,法律文书最高可免检 85.0%,财务票据 56.2%,复杂文档 35.1%。面壁智能
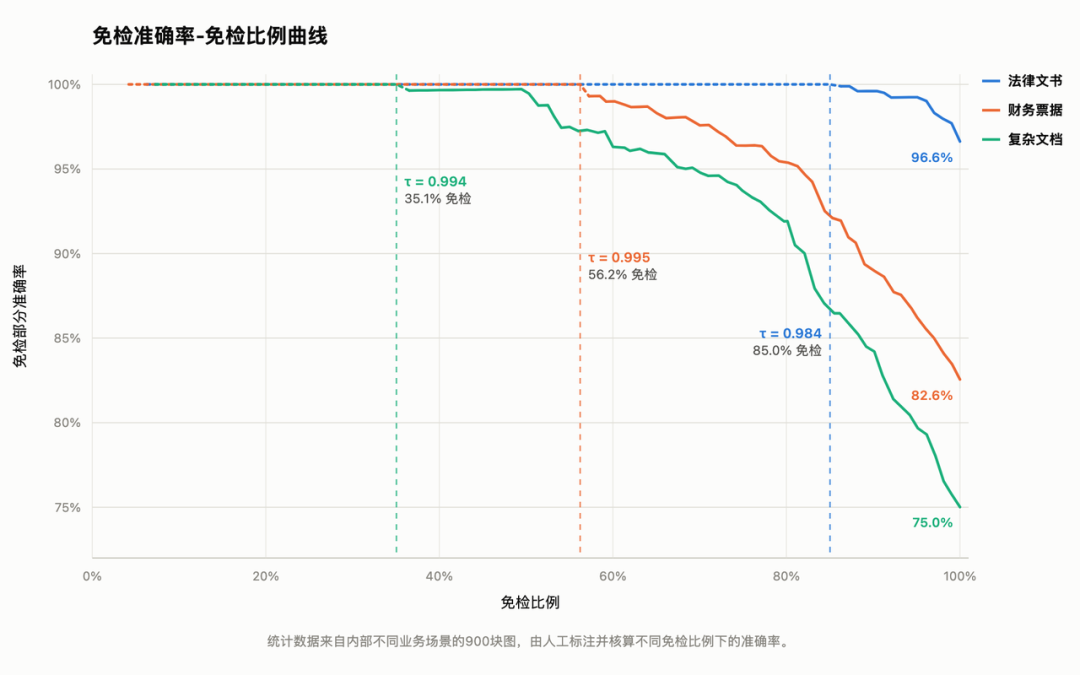
这张表的含义比「93 分」具体得多。它问的不是模型有多准,而是你愿意投几个人复核、剩下多少必须自动通过。
阈值是你调的,漏过去的错也是你放的。
读的那一端,1.3B 的 MiniCPM-OCR 1.0 在 Real5-OmniDocBench 上拿到 93.68,OCRBench v2 上 54.7,两项都是 SOTA。面壁智能路过银河
单张 RTX 5090、并发 1,它跑到 1.217 页/秒。加上 0.3B 的 DSpark 草稿模型,显存峰值 4.33GiB。Datawhale
权重是 Apache 2.0,llama.cpp、Ollama 都能接。
同一个月,赛道上不止一个选择。SoMark 的 OXR 也是 1.3B,覆盖 13 类文档元素,单张 RTX PRO 6000,100 页用 101 秒。量子位
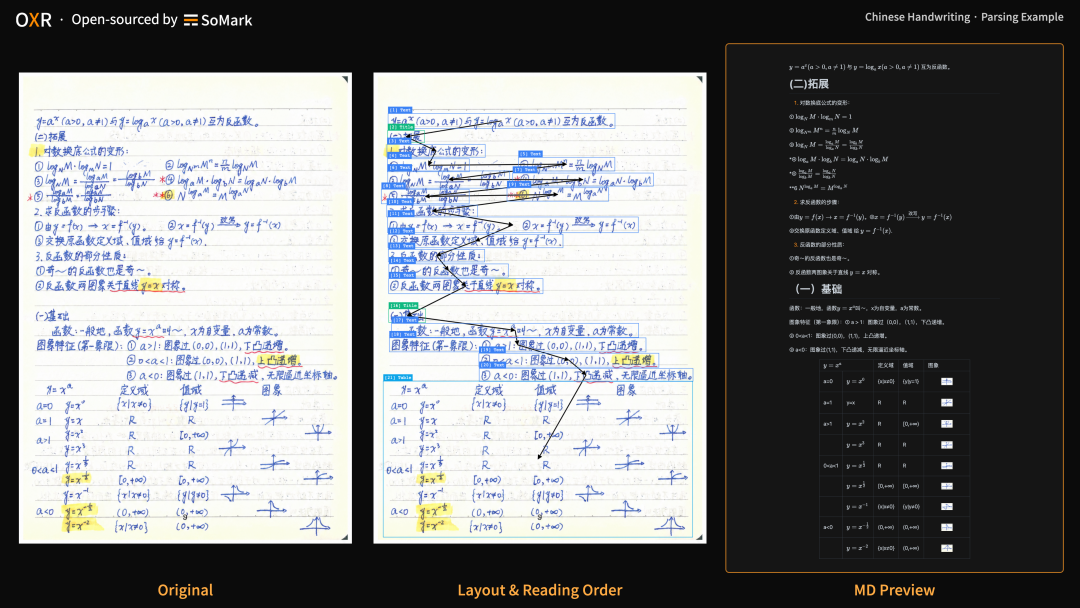
但实测里它并非全能:生僻字照样大面积识别失败,连续跨页表会被拆成两段,竖版顺序也不如 PaddleOCR。刘聪NLP
百度的 Unlimited-OCR-2 走另一条路:3B 总参数、每次激活 500M,MIT 协议,卖点是「任意页数」。
但官方快测用的是 A800-80GB,模型卡没向消费级小卡承诺极长上下文。知乎
有用户在 16GB 的 AMD 消费卡上跑通,结论是瓶颈在推理速度,不在显存。知乎
本地怎么选,先看两件事。8GB 到 16GB 的卡优先 1.3B;几百页卷宗别信「无限页数」。
还有一条更重要:所有分数都是官方自测,榜单之间也不能直接横比。
复印件、印章遮挡、手写批注、跨页表格,这些长尾不会出现在榜单里。
文档解析这行没有通用的 93 分,只有你那一批文档的分数。路过银河
本地 OCR 现在确实能替你读了。它真正省下的,可能不是识别的那几秒,而是你逐页复核的几个小时。
前提是,阈值设在哪儿,你心里有数。