你说几句话,AI 自己拿起 Blender 就开建,建完还顺手导出 GLB——这不是演示视频,是 10 月 26 号到 28 号,一批人真金白银试出来的体验。紧接着的两个问题都非常现实:怎么烧钱,做出来的东西到底能不能用。
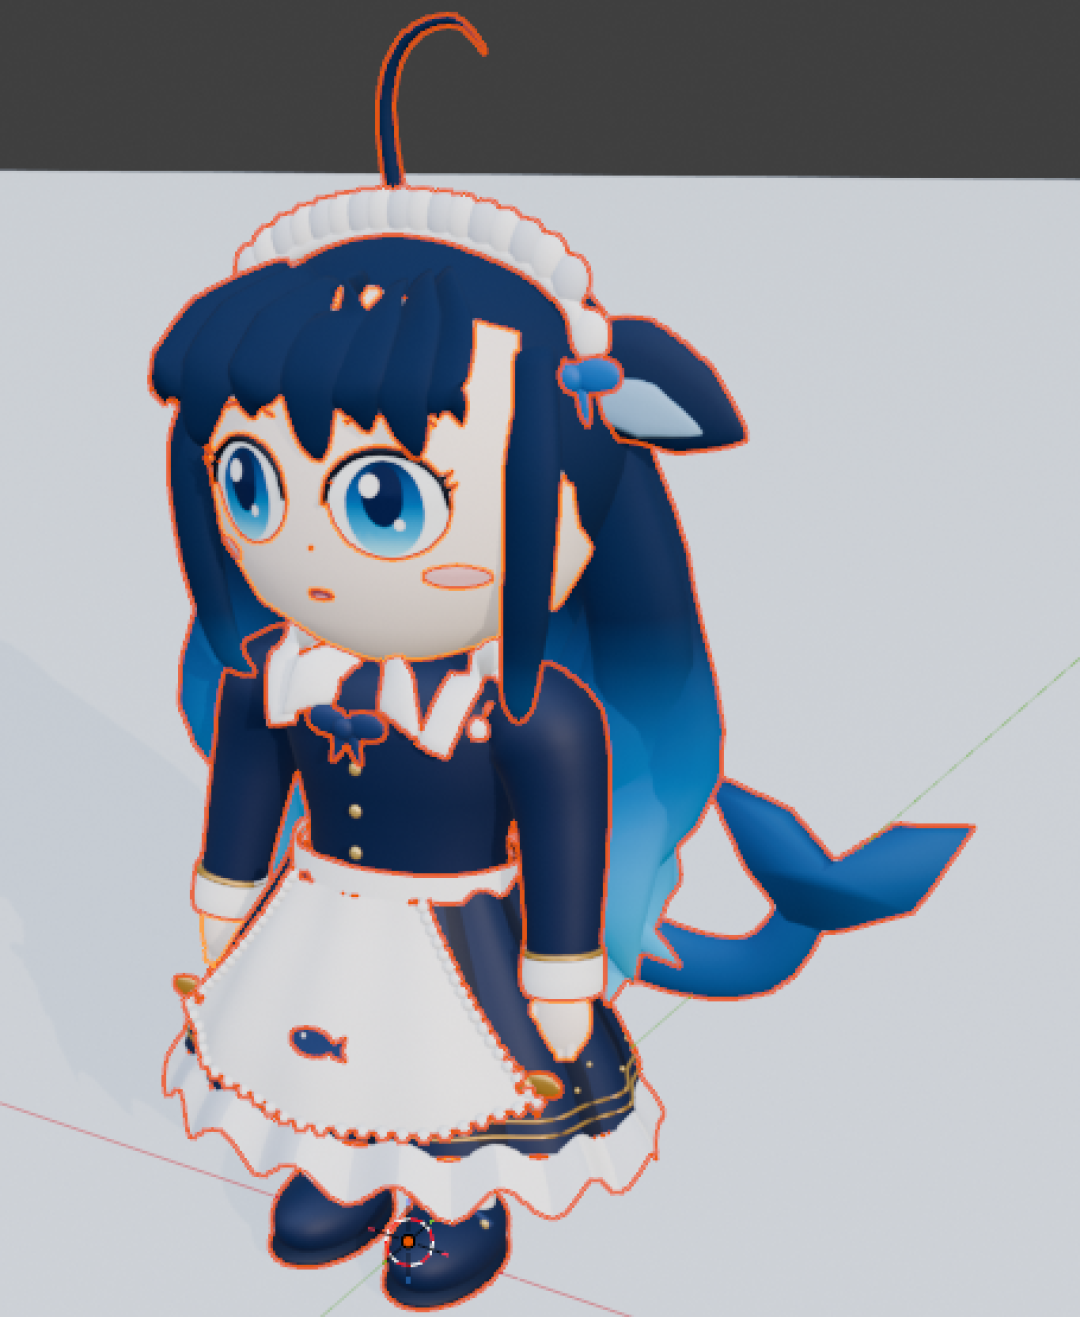
先说钱。 知乎一位博主拿 Kimi K3.1 Pro 驱动 Blender 实测,充了 60 块积分,才"蹬"一晚上就没了 1000 多积分、30 多块没了,而且第一次生成其实不贵,钱几乎全烧在"再改一点"上:说"瘦脸"、“改刘海”、“修眼睛”,每轮都是再烧一笔。同一篇实测的结论很克制:3D 综合水平稍好过其他几款国产模型,但普通用户得掂量性价比。知乎
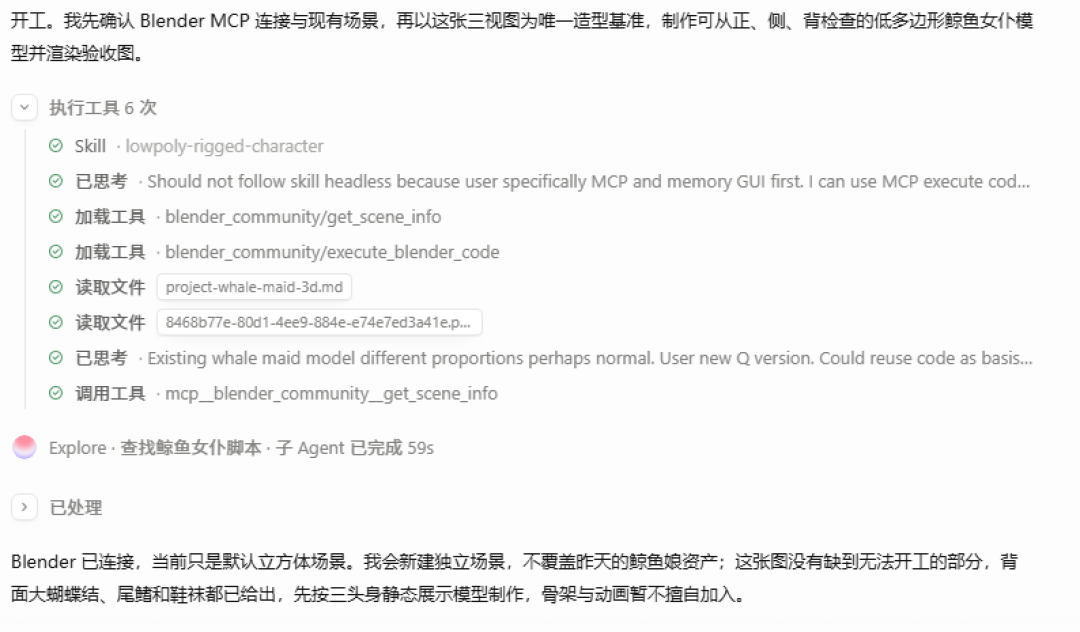
再说能不能用,答案更扎心。 阿里 Qwen 团队 10 月发布的 BlenderWorld 评测基准,给会操作 Blender 的 AI 出了套统一考题:首版 223 项任务,覆盖建筑室内、车辆机械、角色动物等 9 大领域。知乎
13 个被测模型里的榜首 GPT-6-Astra 拿了 79.9 分已经不低,但只有 42.2% 的任务通过了全部验收条件。也就是说,一道题大部分做对,和把整件事完整交付,中间还隔着很远。知乎
最典型的翻车是沙发题:要求木腿本体高 150 毫米,AI 检查的却是木腿加脚轮后的总高度,测到 150 毫米就判通过,实际木腿只有 102 毫米,短了 32%。问题不是没检查,是检查错了对象——过程完整、结论像那么回事,东西照样不对。知乎
另一组数据很点题:DeepSeek-V4.1-Flash 平均每题调用工具约 168 次、输出约 20.9 万 Token,GPT-5.6-Sol 平均只调约 44 次,得分反而更高。折腾得多,不等于交得对。知乎
第三,那到底怎么用?下场实测的人,已经收敛出几条共识。
先给验收标准,再给任务。“3D 任务 AI 最大的问题在于没有合适的验收标准时,跑再多轮也是无用功”。拿户型图建 3D 房的实测就立了规矩:坐标系先写死,四条尺寸链加出 11100 和 11600 才敢开工;建完让 AI 拍俯视对图自查,第一版虚构出的一面墙就是这么被揪出来返工的。知乎知乎
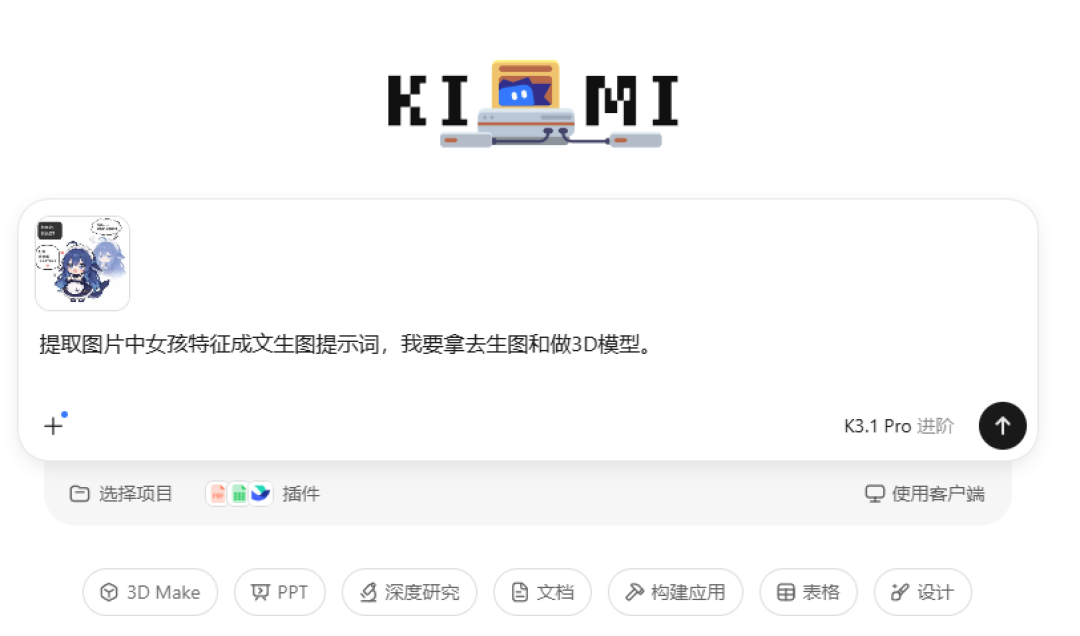
高难度任务别指望扔张参考图就完事。 跟 AI 扔张游戏截图,让它还原服装的金属质感和衣袖褶皱,大概率做的是一坨。知乎微博
第一版交给生成工具,精修绑骨交给大模型。 上面烧积分的博主最后给的答案就是这个:用 Tripo3D 之类先把首次生成的下限抬起来,再让大模型微调外形、绑骨,体验才对得起积分。做建筑可视化的从业者给出的分工也是同一思路:游戏资产优先 Meshy,低成本试原型选 Tripo3D,有实物要扫描选 Luma,公司要数据合规就基于开源的混元 3D 二次开发。知乎知乎
最后。一轮狂热带回一句大实话:仅仅看起来像是远远不够的。AI 建模确实跨过了"会做"的门槛,但还没跨过"能躺"的那道坎。让它干苦力、跑试错,尺寸和验收握在自己手里——这是当下最划算的玩法。知乎