10月14日、15日两天,知乎连着冒出两个问题:“用了AI编程后,你写代码更快了,还是检查代码更累了?”"用了AI编程工具后,你最不敢完全交给它写的是哪一类代码?"后一个问题下的回答里,有位创业者给项目组定了条规矩:对AI编写的代码一律按最高级别审核,审核时间比生成时间还长。知乎
这轮"检查累"的吐槽不是孤例。往前翻,9月24日那条"为什么越是维护过老系统的程序员,越不敢让AI直接改代码"拿了268赞,9月17日"AI生成代码会不会变成新式屎山"下的万字回答也有107赞;再到微博上265赞的"过段时间大部分代码人已经看不懂了,只能让AI修,越修越烧token"。另一边则是完全不同的画风:MVP阶段的创业者说"任何类型代码都适合给AI构建,活下来最重要",小红书上手把手教小白vibe coding的教程收藏破百。同一个工具,有人闭眼放行,有人全量人肉复核——两种都在付学费。微博
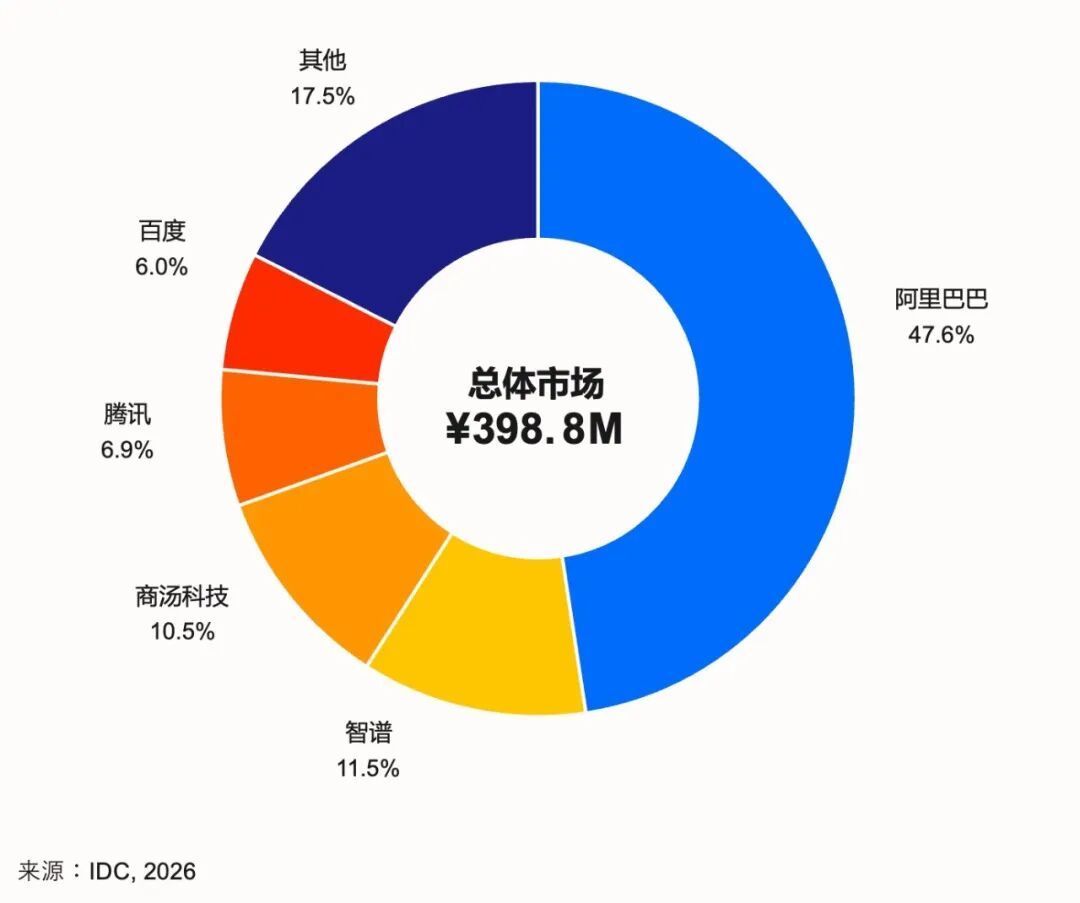
先把背景钉死:这不是小众折腾。IDC首份中国AI编程市场报告里,仅阿里一家(Qoder)就占了47.6%的份额、接近半壁江山(36氪7月报道)——AI生成代码已经全面进入日常工作流,才会让"检查"变成新的瓶颈。36氪
把近一个月知乎、小红书、微博、36氪上十来篇高强度讨论样本按"到底在怕什么"归类后,有个规律浮出来:社区真正不敢交给AI的,从来不是按"技术难度"分布的,而是按另外两个轴分布。这篇就干一件事:把这批样本的对错、成本、反例都摆完,给你一张能直接抄走的三档托付表。
一、社区"不敢交"的,高度集中在这四类代码
① 依赖隐性上下文的存量系统改动。 这是268赞回答和"新式屎山"长文共同的火力点。后者的案例很具体:让AI写"订单超时关闭",三秒给出分布式定时任务、状态检查、数据库更新,语法挑不出毛病——但它不知道你们的MySQL集群为扛读写分离做过特殊路由,不知道Redis跨机房同步有200毫秒延迟窗口,更不知道网关层为了绕一个老ERP的Bug做过畸形的参数改写。代码是教科书级的,放进带着历史包袱的系统就是认知层面的黑盒。268赞回答的概括更狠:能力不足的程序员乱改代码有版本控制兜着、有编译器拦着,“AI不行,它太擅长装专家了”,失败规模没有下限。知乎知乎
② 安全、权限、鉴权类代码。 9月16日知乎一篇实测给出了几乎反常识的结论:作者让AI"提升一个密码验证程序的安全性",AI煞有介事地加了PBKDF2-SHA256、随机盐、几十行哈希代码,看起来非常专业——但在汇编层,真正的破口只是最终编译成的一条`test eax,eax`跳转,改一个寄存器照样绕过。那几十行"专业加密"对整体安全性的提升约等于0。木桶效应在安全领域最要命:需求方向错了(比如硬编码密码),后面AI做再多努力都是表演。知乎
③ "AI自报完成"的用户可见功能。 小红书10月14日一篇实测:AI说"已完成页面改造,新增搜索功能并优化交互",终端没报错,代码能跑——但人点进去试才发现:空关键词直接白屏、手机端布局挤作一团、原有筛选条件的顺序变了。另一位博主10月15日把Reddit、X、Hacker News、YouTube评论区一个月里关于Cursor、Claude Code、Codex的吐槽去水后统计出95条真实反馈,头号槽点是"额度突然用光且无提醒"(46条),第二是"质量悄悄变差"(32条)。开发者真正想要的只是一张看得见的计费表。这两件事本质相同:AI的错误和它的"完成声明"都发生在你的注意力之外。**小红书小红书
④ 深水区线上bug的排查与修复。 "新式屎山"回答里那笔账值得每个团队贴在工位上:一段AI生成的异步重试代码,带随机退避、防雪崩,架构师看了都会点头——它唯一漏掉的是下游第三方接口不严格幂等。结果:写那段代码AI花了5秒,工程师确认合并花了10分钟,它引发的线上故障花了将近100个人力小时才排掉。知乎
二、反证也要看:社区真心敢交的是什么
只看吐槽会变成劝退文,但样本里的另一半同样清楚:MVP/独立Demo阶段,任何类型都可以放心交给AI先跑起来(10/15回答原话);一次性脚本、小工具、测试脚手架、新模块原型,是各平台公认的"敢交区"。甚至有反例:老系统回答评论区有人说,让AI加新功能反而review出了"以前的代码本身有问题"——AI按标准写法撞上了人的历史坑,偶尔还能当免费的旧账审计。微博那条高赞"方差论"说得直白:工具抹平了敲代码的体力活,拉开差距的是需求拆解、方案取舍、风险预判、边界校验——“敢不敢交"的真相不是模型能力问题,而是"你给它的上下文里,有没有它看不见的东西”。微博
三、三档托付表:按"出错代价可逆性 × AI可见度"分
档位 | 代码类型 | 依据 | 你怎么做 |
|---|---|---|---|
A 闭眼交 | 一次性脚本、原型、新Demo、测试脚手架、明确外部化需求 | 出错可逆,上下文全在对话框里 | 跑一遍就交付,别浪费心智逐行读 |
B 半交+抽查 | 存量项目的单模块新功能、常规重构 | 局部依赖隐性约定 | 不读行级代码,要AI给出改动文件清单+影响面说明,重点抽查"空结果、移动端、原有功能回归"三类边界 |
C 不许AI自己验收 | 安全/权限/支付、删数据与改schema、共享分支提交、老系统关键路径改动、深水区bug定位 | 出错不可逆,AI看不见全局状态 | 人掌握需求和方案,AI只做局部执行;验收必须来自运行现场,不接受"AI说完成了" |
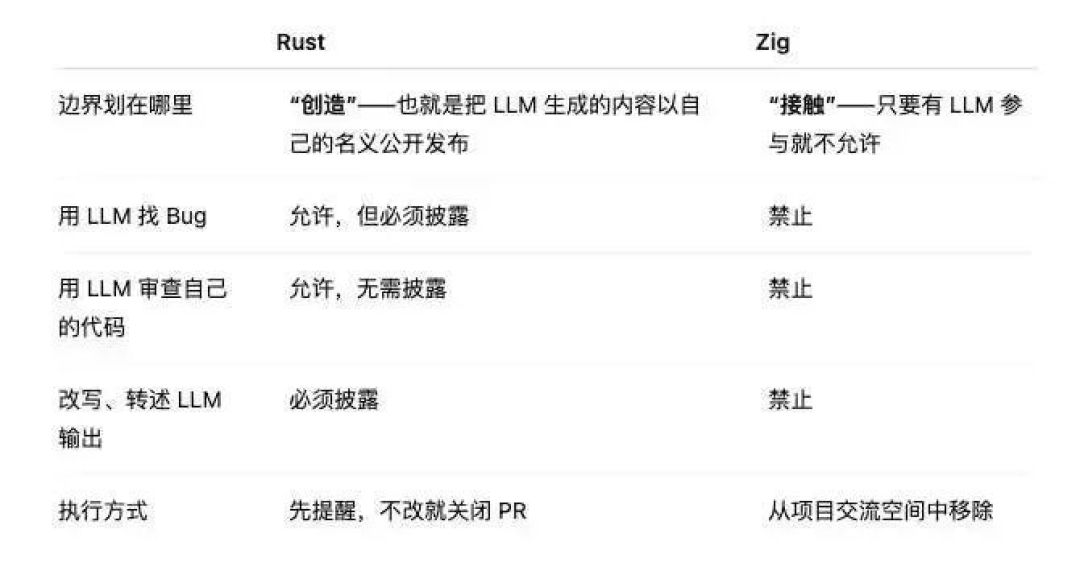
之前聊Linus用Claude Code进内核时,内核那三条"AI代码验收规矩"更多是顶级开源项目的事;但看看Rust和Zig这两个以"语言洁癖"著称的社区给LLM立的边界——能帮你看(审查、找bug),不能替你写(直接提交),用多了还会触发"熔断"——同一套分层逻辑正在往每个普通项目组下沉。Rust给AI立规、内核给AI验收之后,轮到个人开发者的日常工作台了。36氪
四、三个能直接抄的验收动作
把"做完了吗"换成三连问(小红书实测贴的方法,亲测比任何提示词技巧管用):“哪些已经验证?哪些只是推测?还有什么没检查?”
按影响面协作,别一刀切:低风险操作(查文件、读代码)自动推进;涉及修改先讲清范围(改哪些文件、可能影响哪些功能);高影响操作(删数据、改权限、公共接口)保留人工确认。注意OpenCode 10月13日的changelog已经在支持按项目设置自动接受权限——工具在放权,你要分层放,不是全放。
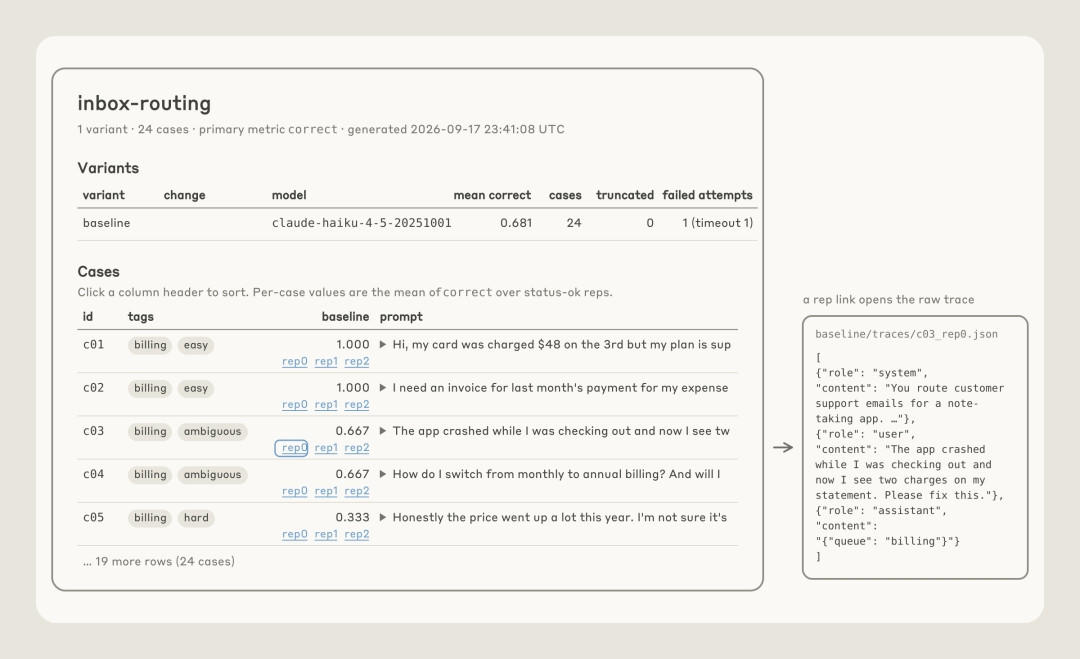
让写代码的Agent和查代码的Agent隔离:引入独立上下文的Review Agent评估副作用;别埋头读AI吐出的大段源码,让它先输出架构图和通俗文档(微博"方差论"原方法),你只审假设,不审语法。这条民间打法,9月底已经被官方盖章:Anthropic在9月28日发布调优指南(36氪10月9日解读),核心就一句——"反复测试、反复改"这种活也让AI自己干,人只负责定标准和做抽查。第一步是 /claude-apibuild-eval:把"靠谱一点"这种模糊要求变成一套可反复运行的验收题库(题目不能只收"翻车现场",最常见的问题也要覆盖,否则测不准日常体验),AI拟出评分规则后,你拿几份已打分的答案对照自己的判断,确认评分器本身先过关。微博36氪
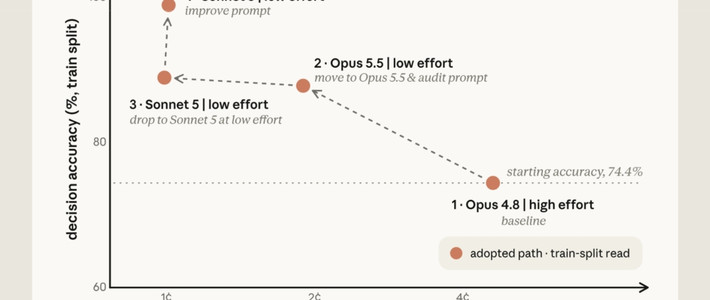
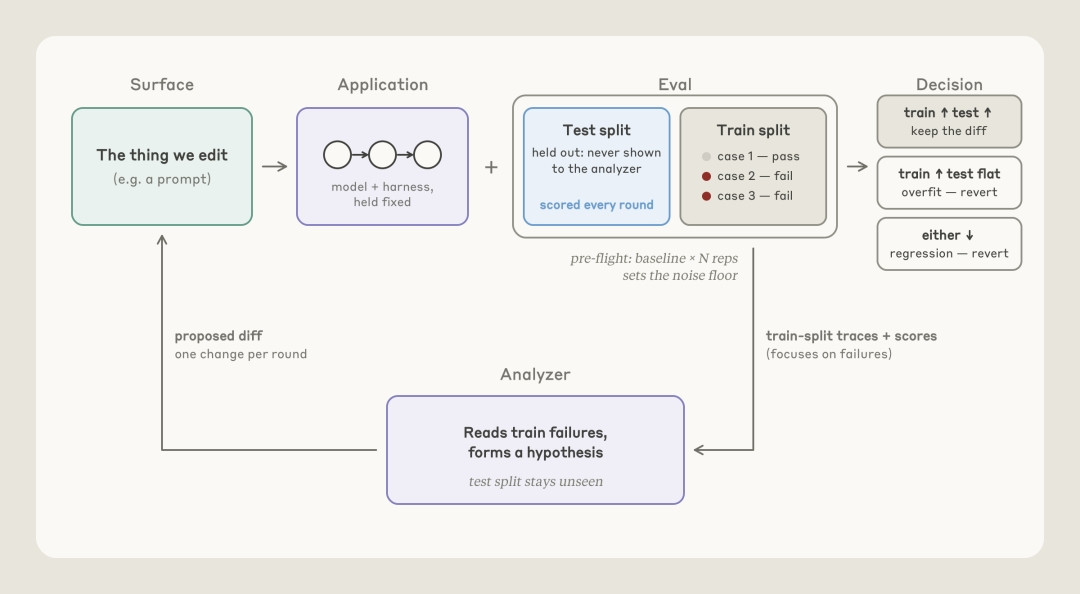
第二步是 /claude-apihillclimb:让AI每轮提一处修改、重跑评估,确有改善才保留、改差了就撤回。最能防"AI自己验收自己"翻车的是它的留出机制:单独留一部分"验收考题"不提前公开,负责改代码的模型看不到这些题——练过的题涨了、留出题没涨,就判定过拟合,本轮修改直接回退。官方给的内部客服案例:14张留出工单上决策准确率从78.6%升到90.5%,模型调用成本降到约1/5。注意口径,这是特定配置下的小样本结果,不能线性外推到你的项目,而且两个入口都要求Claude Code v2.1.259及以上。36氪
题库之外,你的三连问依然成立:验收标准可以交给机器跑,但"什么才算做对"永远人来定。
五、接下来盯什么信号
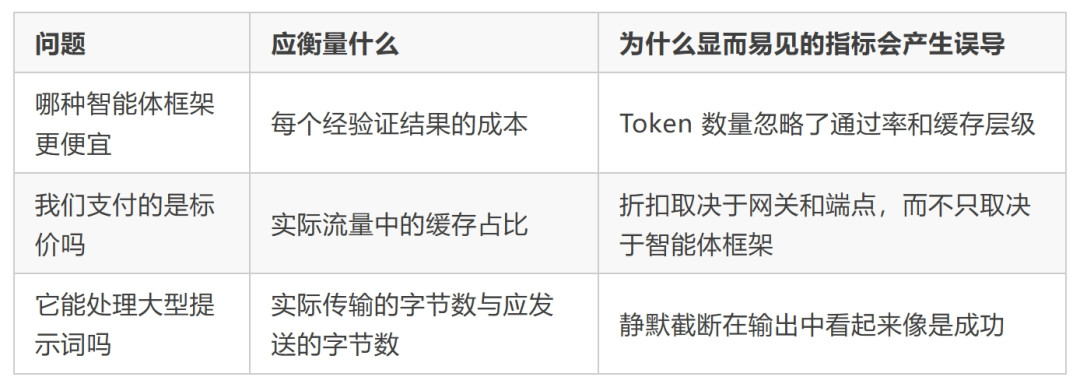
成本侧的窗口正在变好变坏各一半。先看一张底牌:36氪9月的三项实测显示,模型一模一样,不同智能体框架的Token消耗能差出70倍——真正该衡量的是"每个有效结果的成本",而不是裸Token量。36氪
好消息是厂商开始补"成本可见性"的洞:Claude Code已经上线idleCompaction,缓存将失效时主动帮你执行一次/compact,防止一小时后回来第一次请求被全额计费,想关掉就在`~/.claude/settings.json`里把`“idleCompaction”`设为false。但那份95条统计里46条的头号槽点"额度用光无提醒",目前还没有任何一家原生解决。如果下一轮工具更新还不给每次调用的账单粒度,本身就是该换工具的信号。B档抽查的三个边界(空结果、移动端、原功能回归)建议现在就把它们固定进你的验收清单——这三类恰好也是社区"AI谎报完成"样本里出现频率最高的翻车点。微博
适用人群再收窄一次:独立开发者,停止全量逐行读AI代码,把省下来的心智全押到C档;团队负责人,把C档写进PR规则,别赌每个人的责任心;刚入坑vibe coding的,MVP阶段大胆交,但别让写你毕设、外包验收和理财脚本的那个AI,替你验收它自己。生成免费的时代,验证才是你的新成本项——这份成本,现在可以分层付了。